2026-10-06、Googleが「EmbeddingGemma 2」を公開しました。文章だけでなく、コード・画像・動画・音声も同じ768次元の数字の並び(ベクトル)に変えられる、オープンで軽量な埋め込みモデルです。
埋め込みモデルとは:文章や画像を「意味が近いものは近くに並ぶ数字の列」に変える部品です。文章を生成するAIとは役割が違い、検索やRAG(資料を検索してからAIに答えさせる仕組み)の「探す側」を担います。
この記事の内容は、公式発表・モデルカード・開発者向けガイドの記載(2026-10-07時点)に基づきます。weevee自身で動かして測った結果は含みません。性能の数値はすべて公式が公開している値です。
つまり何が起きたか|3点で整理
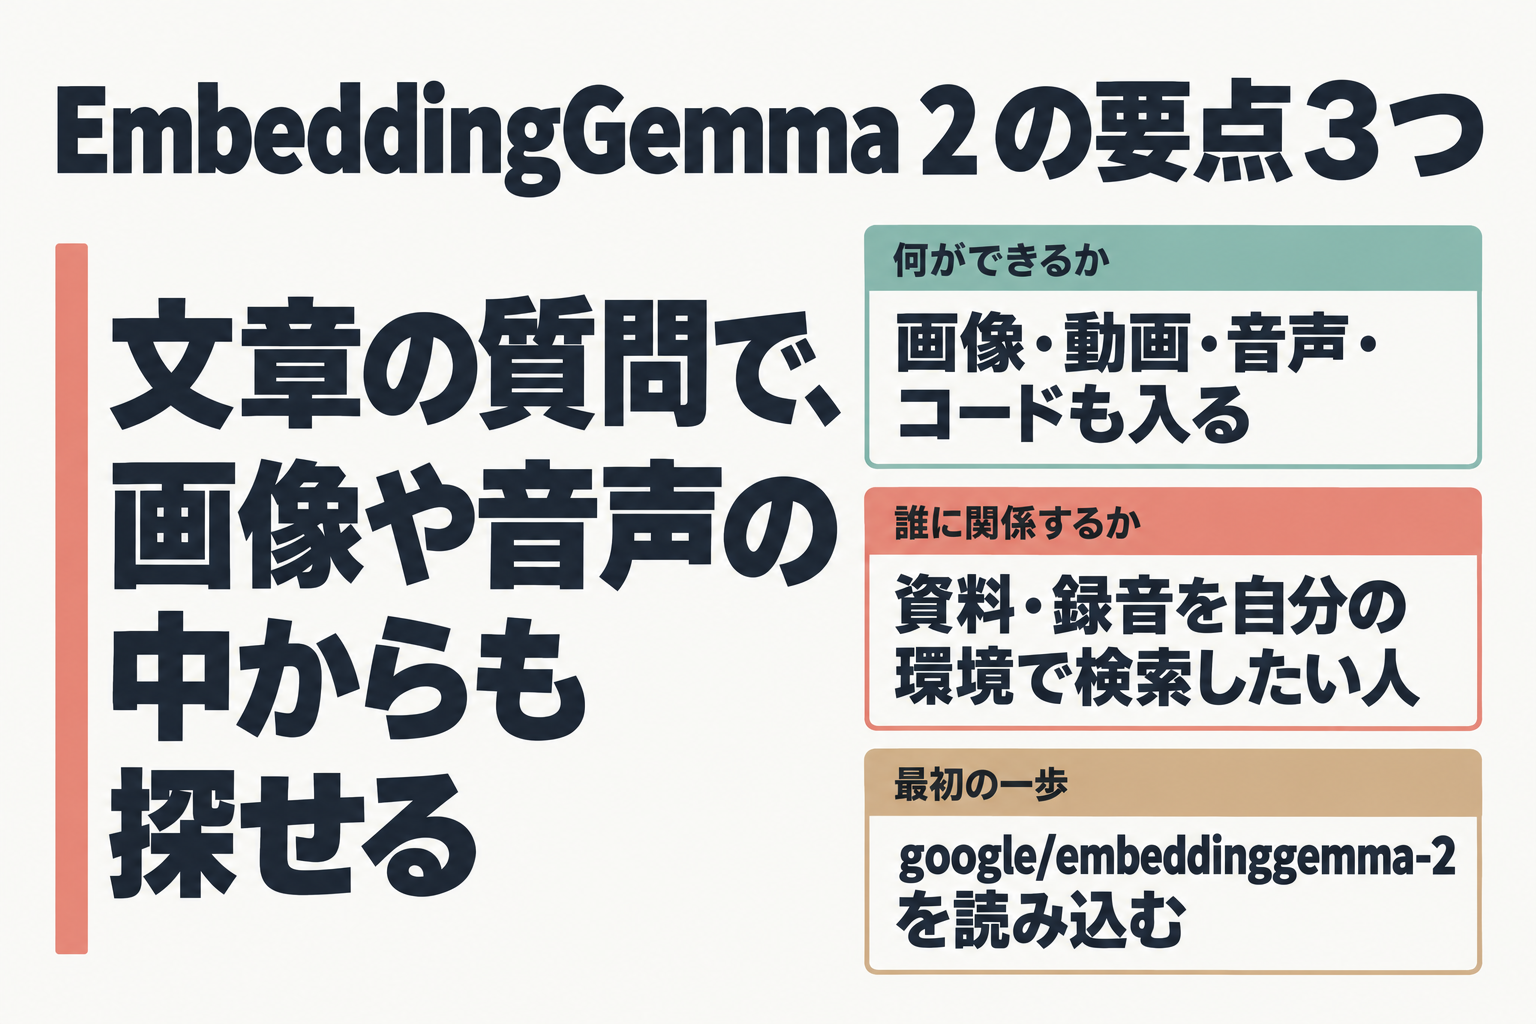
- 何ができるようになったか:旧版はテキスト専用でした。新版は画像・動画・音声・コードも同じ空間に入れられます。「文章で質問して、写真や音声の中から探す」ことが1つのモデルでできます。
- 誰に関係するか:社内の資料・スクリーンショット・録音などを自分の環境で検索できるようにしたい個人開発者や小規模チームの担当者です。文章だけを検索する人は、旧版でも足りる可能性があります(後述)。
- 今日の最初の一歩:Hugging Faceの
google/embeddinggemma-2を、sentence-transformersで読み込むところまで進めます(手順は「今日試す最初の一歩」に書きました)。
迷ったらこれ
- 画像・音声・動画も検索対象にする人は、EmbeddingGemma 2。必要な部分だけ読み込む構成にでき、文章専用の構成なら270M(2億7千万パラメータ)と、旧版の約300Mより小さく済みます。
- 文章だけを検索する人は、まず旧版で足りるかを考える。多言語テキストの精度は公式の数値でほぼ同じです(旧版61.15、新版61.36)。
- 向かない人:PCの最低スペックを先に知りたい人。公式にはスマートフォン上のメモリ値しかなく、PC向けの目安は記載がありません。
前バージョンから何が変わったか(Before → After)
旧版のEmbeddingGemma(以下、旧版)と新版を並べます。
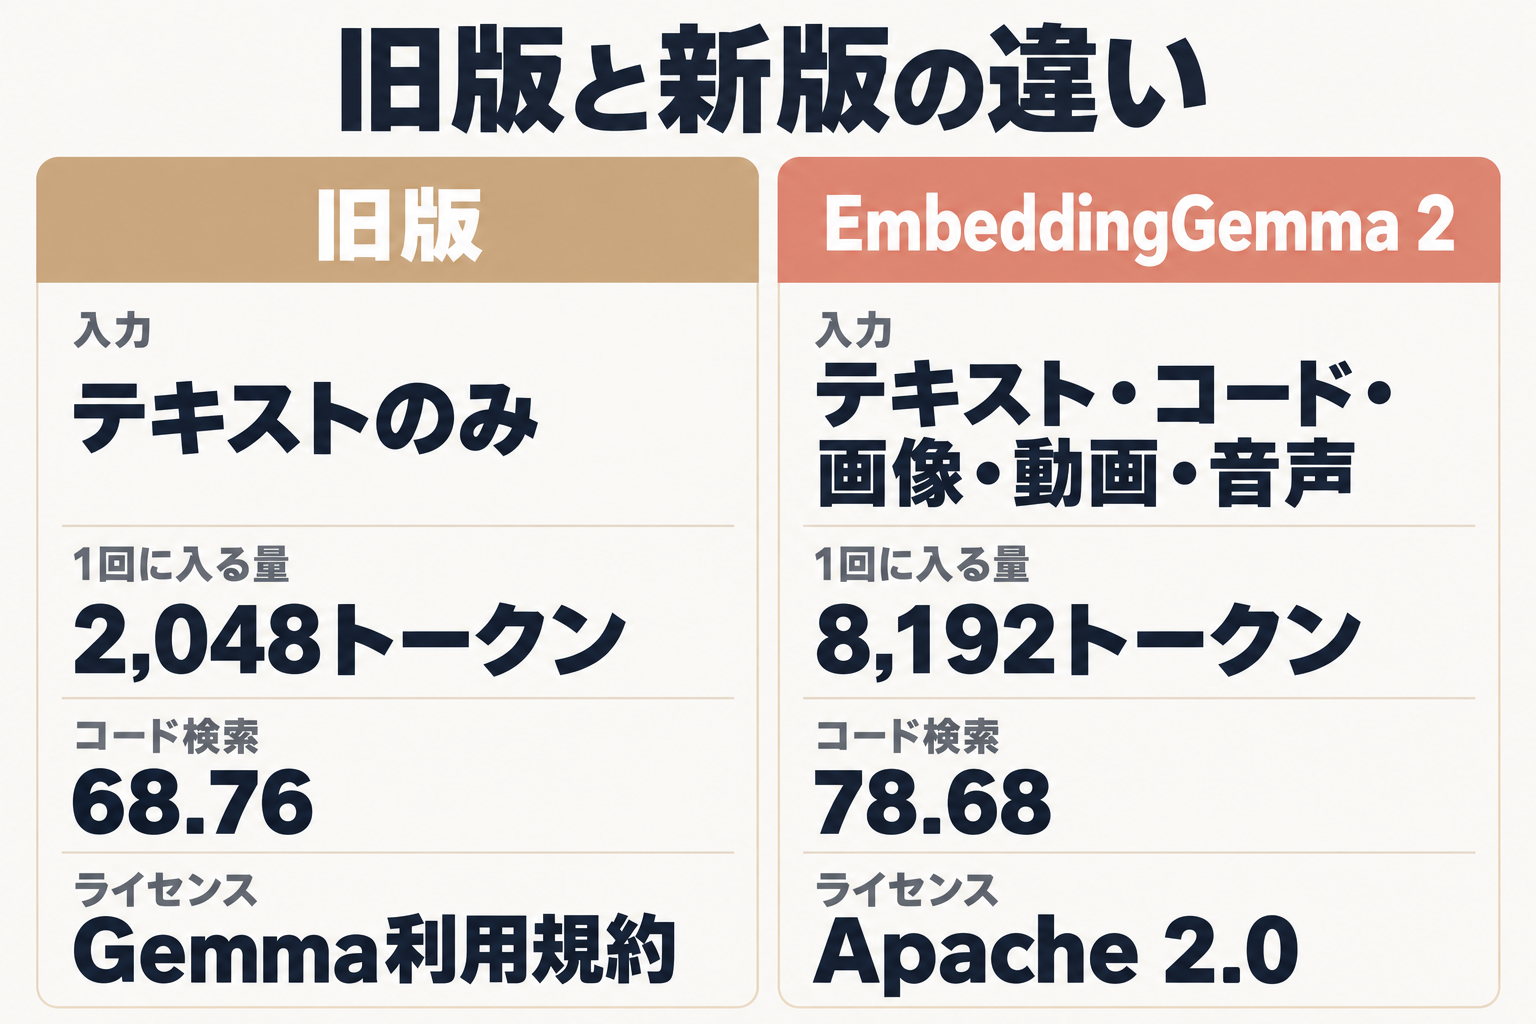
| 項目 | 旧版(EmbeddingGemma) | EmbeddingGemma 2 |
|---|---|---|
| 入力 | テキストのみ | テキスト・コード・画像・動画・音声 |
| サイズ | 約300M(公式ドキュメントの1つは308Mと記載) | 270M / 440M / 570M / 740M(読み込み時に選ぶ) |
| 1回に入る量 | 2,048トークン | 8,192トークン(全入力共通・旧版の4倍) |
| 次元 | 768(512・256・128に切り詰め可) | 768(512・256・128に切り詰め可・同じ) |
| 言語 | 100以上 | 100以上 |
| ライセンス | Gemma利用規約 | Apache 2.0 |
| コード検索(MTEB Code) | 68.76 | 78.68 |
| 多言語テキスト(MTEB Multilingual v2) | 61.15 | 61.36 |
| ベースモデル | Gemma 3(旧版モデルカードより) | Gemma 4 |
読み取れるポイントは3つです。
- 変わったのは入力の種類と長さです。画像・動画・音声が加わり、1回の入力量も4倍になりました。公式は、5.5分の音声、29枚の画像、58フレームの動画が1回に入る目安だと書いています。動画は既定で1秒につき1フレーム、音声は16kHzモノラルが前提です。
- コード検索は大きく伸びました。MTEB Codeは68.76から78.68へ、+9.92点です。公式はこれを「約14%高い」と表現しています。
- 文章の精度はほぼ維持です。次元数と対応言語数も変わっていません。
旧版の累計ダウンロード数は2,000万を超えると公式が書いており、新版はこの路線の後継にあたります。
仕組みの要点|必要な部分だけ読み込む4つの構成
新版は1つの固定サイズのモデルではありません。使う入力に合わせて、読み込む部品を選べます。
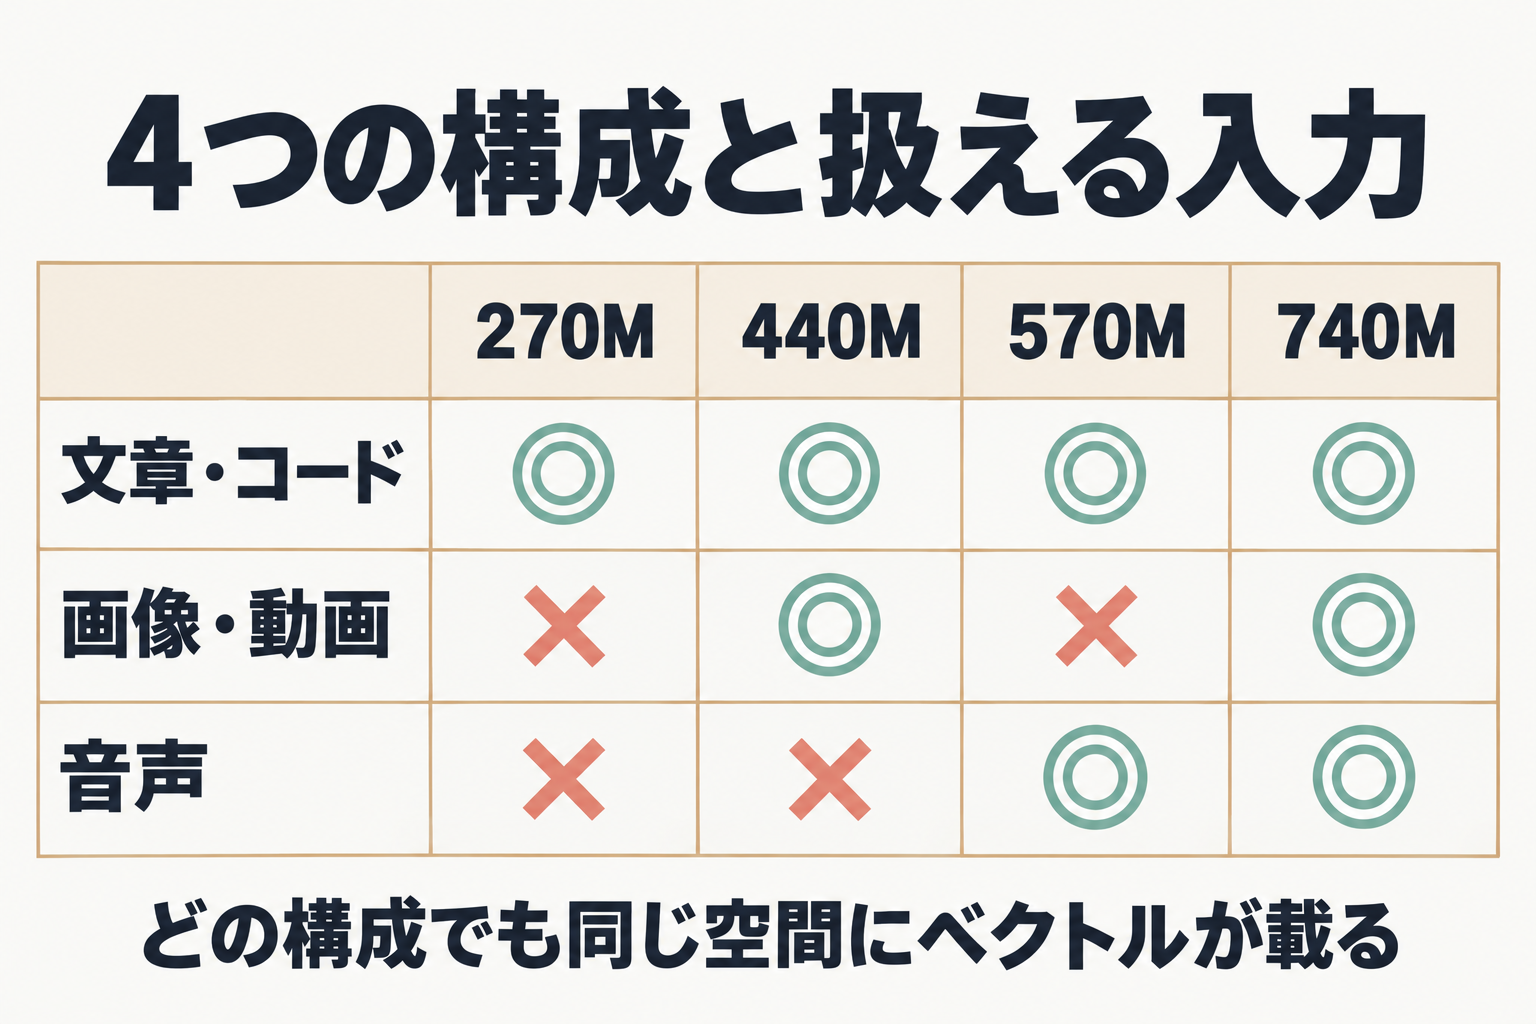
| 構成 | サイズ | 扱える入力 |
|---|---|---|
| テキスト・コードのみ | 270M | 文章・コード |
| +画像・動画 | 440M | 上に加えて画像・動画 |
| +音声 | 570M | 文章・コード・音声 |
| 全部入り | 740M | 文章・コード・画像・動画・音声 |
内訳は、テキスト・コードの基盤が270M、視覚エンコーダ(画像・動画を数字に変える部分)が+170M、音声エンコーダが+300Mです。
大事なのは、どの構成でも同じ空間にベクトルが載ることです。公式は次のように説明しています。
- 4構成は、sentence-transformersで同じチェックポイントから読み込めます。
- 270Mのテキスト専用で作った質問ベクトルを、全部入りで作った文書ベクトルと直接照合できます。
- テキストだけの索引を作り、後から画像や音声を足すとき、計算済みの埋め込みを計算し直す必要はありません。
つまり「まず文章だけで始めて、必要になったら画像を足す」という進め方ができます。ただし、これは新版の構成どうしの話です。旧版のベクトルとの互換性は、公式ページに記載がありません(後述)。
自分の仕事ではどう使えるか
公式の機能を、業務の場面に置き換えてみます。以下は仕組み上できると公式が説明している範囲の話で、weevee自身が動かして確かめた結果ではありません。
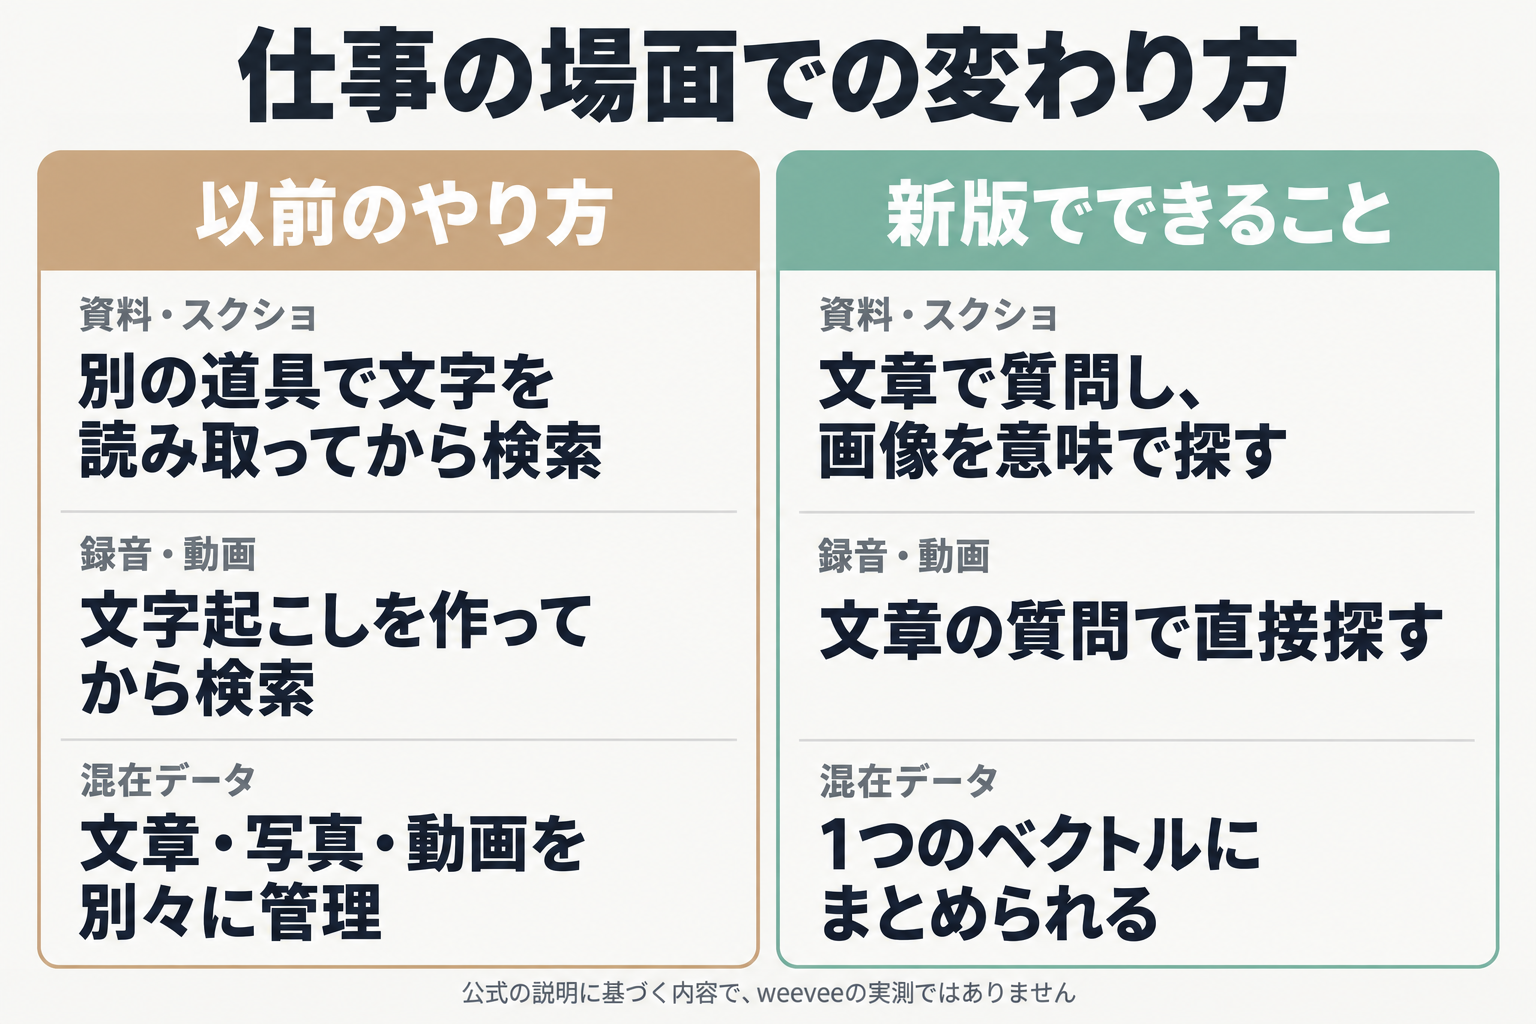
| 場面 | 以前のやり方 | 新版でできること |
|---|---|---|
| 手元の資料・スクリーンショット検索 | ファイル名や、画像の中の文字を別の道具で読み取ってから検索 | 文章で質問し、画像そのものを意味で探す |
| スライド・PDF・図表の検索 | 本文のテキストだけが検索対象 | 公式ガイドは視覚文書(PDF・スライド・図表)も対象と記載 |
| 録音・動画の中身探し | 文字起こしを作ってから検索 | 文章の質問で音声や動画を直接探す |
| コードベースの検索 | 単語の一致で探す | コード検索の指標(MTEB Code)が旧版より伸びている |
| 商品ページのような混在データ | 文章・写真・動画を別々に管理 | 公式は、文章+写真+動画を1つのベクトルにまとめられると説明 |
クラウドの検索サービスに送らず、自分の環境で動かせる点も利点です。公式は、量子化(モデルを軽くする処理)したテキストのみの構成で約191MB、全モダリティ構成で約567MBの実使用メモリと記載しています。ただしこれはGoogle Pixel 11 Pro上の値で、PCの最低要件やGPUが要るかどうかは、公式ページに記載がありません。PCで試すときは、小さい270M構成から始めるのが安全です。
関連記事:ローカルでAIモデルを動かすときのメモリの考え方は、VPS Ollama実測|メモリ選びと外部公開 で整理しています。
構成と次元数の選び方
ステップ1:検索したい入力で構成を決める
- 文章とコードだけ → 270M
- 画像や動画も探す → 440M
- 音声も探す(画像は不要) → 570M(文章・コード+音声)
- 画像も音声も探す → 全部入りの740M
迷ったら、いちばん小さい構成で始めます。後から入力を足しても、同じ空間のまま使えるからです。
ステップ2:保存量と品質のバランスで次元数を決める
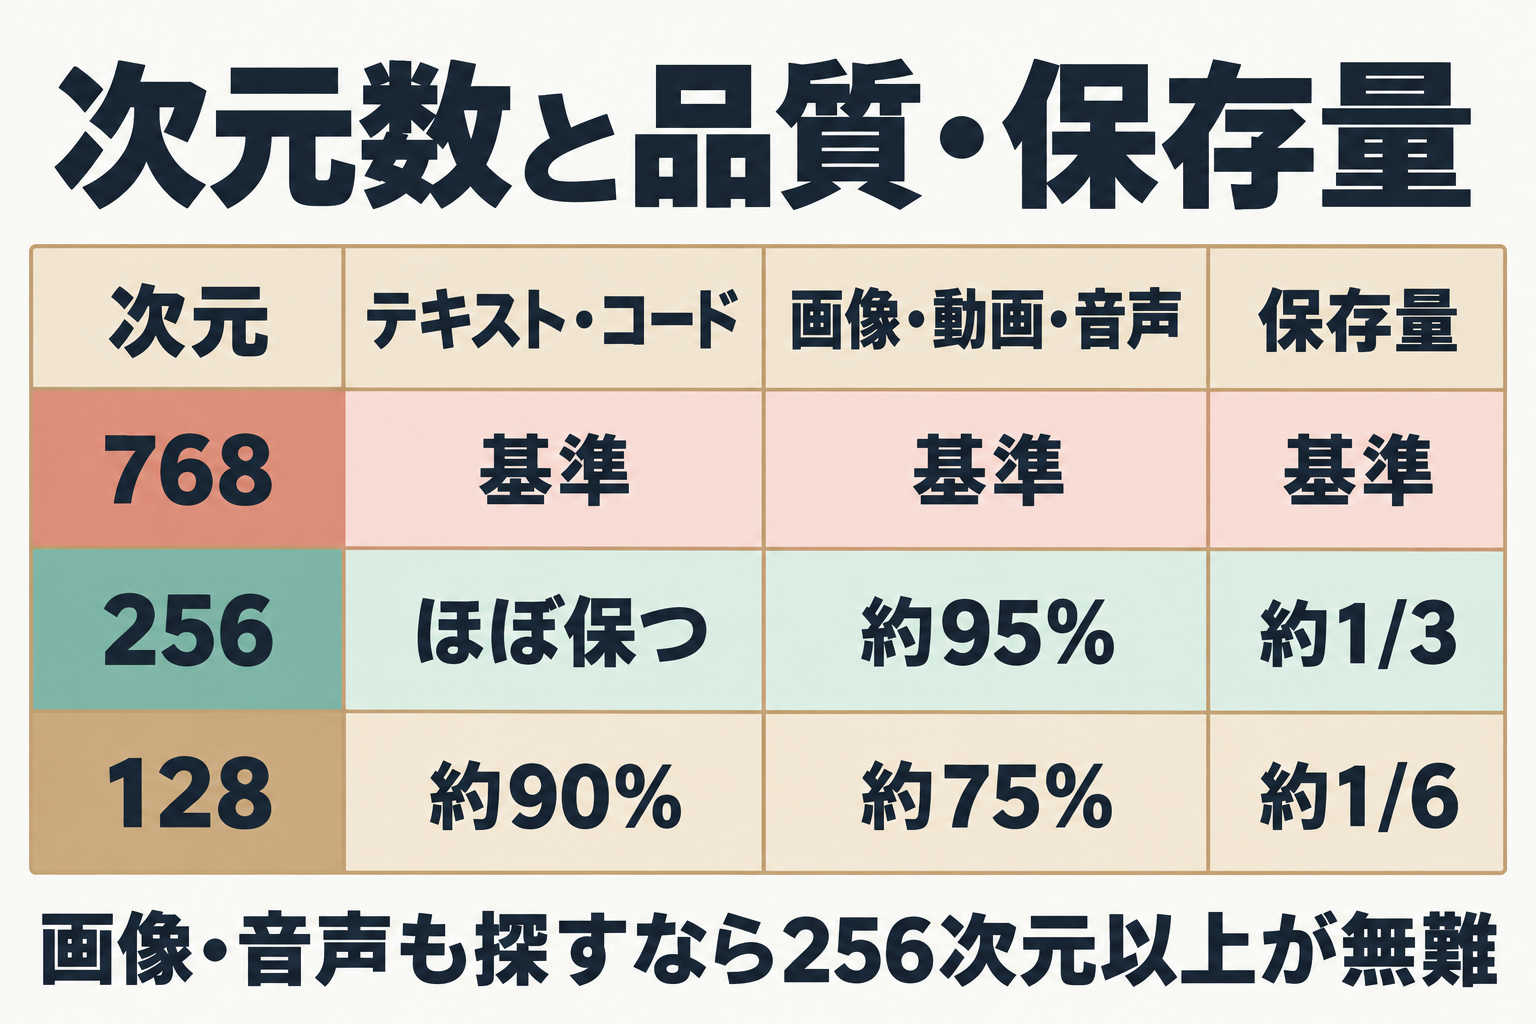
768次元を、MRL(先頭の数字だけを使っても意味が保たれるよう学習する仕組み)で短くできます。公式の数値は次のとおりです。
| 次元 | テキスト・コード | 画像・動画・音声 | 保存量 |
|---|---|---|---|
| 768 | 基準 | 基準 | 基準 |
| 256 | 元の品質をほぼ保つ | 約95% | 約1/3 |
| 128 | 約90% | 約75% | 約1/6 |
100万本のベクトルを保存するとき、768次元で約1.5GB、128次元で約250MBです(bfloat16の場合)。
判断の目安:文章とコードだけなら、256次元で品質をほぼ保ちつつ保存量を1/3にできます。画像・動画・音声も探すなら、128次元は約75%まで下がるので、256次元以上が無難です。128次元の「約75%」は画像・動画・音声の値で、テキスト・コードは約90%です。混同しないでください。
公式ガイドは、128次元を「大規模なテキストのみの索引」や「再ランキング前の一次絞り込み」向けとしています。画像・動画・音声の質問で128次元を使う場合は、自分のデータで検証してから本番に使うよう注意しています。
今日試す最初の一歩
入手先は、Hugging Face(google/embeddinggemma-2)とKaggleです。ここでは、公式の開発者ガイドにある最小の手順を日本語にまとめます。weevee自身で動かして確かめたものではありません。
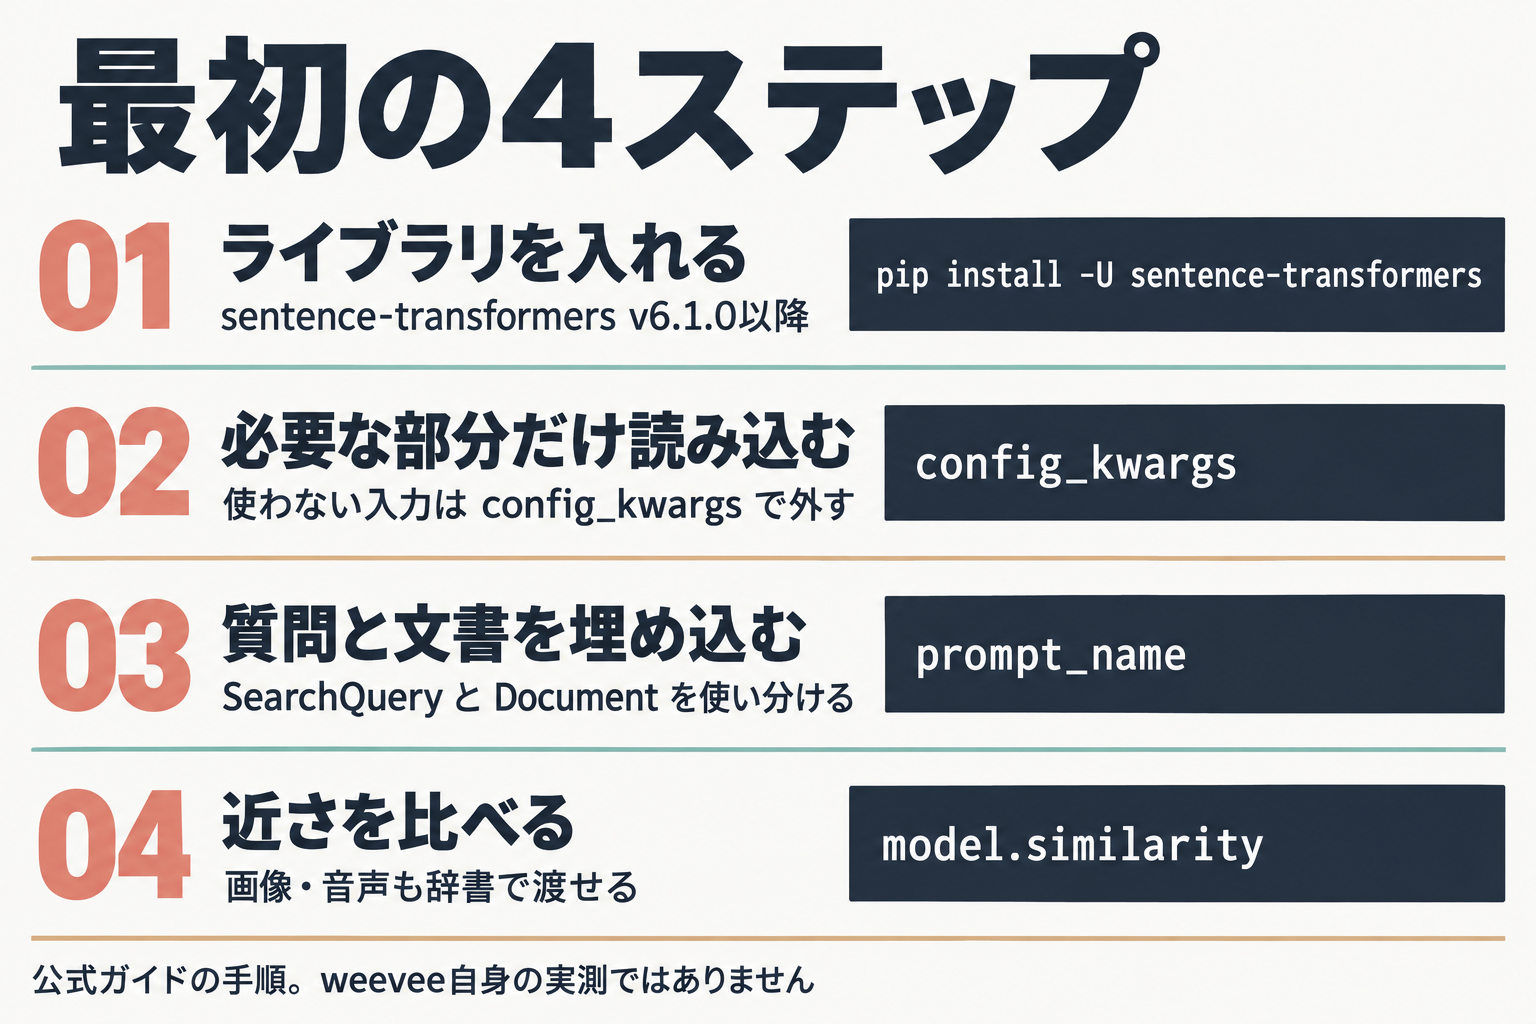
手順1:ライブラリを入れる
sentence-transformersは v6.1.0以降 が必要です。画像・音声・動画も扱う場合は、追加の部品も一緒に入れます。
pip install -U sentence-transformers[image,audio,video] transformersなお、PyTorchなど大きな部品が一緒に入る可能性があります。PCでの最低要件は公式に記載がないので、空き容量に余裕のある環境で試してください。
手順2:必要な部分だけ読み込む
何も指定せず読み込むと、全部入り(740M)になります。使わない入力のエンコーダは、config_kwargs で外せます。
from sentence_transformers import SentenceTransformer

MODEL_ID = "google/embeddinggemma-2"

# 文章・コードだけ(270M)
model = SentenceTransformer(
    MODEL_ID,
    config_kwargs={"vision_config": None, "audio_config": None},
)

# 画像・動画も使う(440M)なら   config_kwargs={"audio_config": None}
# 音声も使う(570M)なら         config_kwargs={"vision_config": None}
# 全部入り(740M)なら           config_kwargs を付けない
手順3:質問と文書を埋め込み、近さを比べる
質問側は prompt_name="SearchQuery"、文書側は prompt_name="Document" を付けて埋め込みます。近さは model.similarity で出せます。
query_emb = model.encode(query, prompt_name="SearchQuery")
doc_emb = model.encode(document, prompt_name="Document")

print(model.similarity(query_emb, doc_emb))
モデルカードには、質問側を task: search result | query: {query}、文書側を title: {title} | text: {content} という書式にする表もあります。
手順4:画像・音声も同じように比べる(440M以上・570M以上の構成)
画像や音声は、種類を示す辞書で渡します。文章の質問1つで、写真と音声の両方に対して近さを出せます。
image_emb = model.encode({"image": "sunset_beach.jpg"})
audio_emb = model.encode({"audio": "ocean_waves.wav"})
query_emb = model.encode("ocean waves at sunset", prompt_name="SearchQuery")

print(model.similarity(query_emb, image_emb))
print(model.similarity(query_emb, audio_emb))文章・写真・動画をまとめて1つのベクトルにする書き方もあります。<|image|> や <|video|> で文章中の位置を示し、{"text": …, "image": …, "video": …} の辞書で渡します。画像・動画・音声は、ファイルのパス、URL(画像・音声)、メモリ上の画像データなどで渡せます。動画はMP4のファイルを渡します。
手順5:次元を切り詰める(任意)
保存量を減らしたいときは、truncate_dim(512・256・128)と normalize_embeddings=True を付けます。質問側と文書側で、同じ次元にそろえる必要があります。
query_emb = model.encode(
    query,
    prompt_name="SearchQuery",
    truncate_dim=256,
    normalize_embeddings=True,
)
毎回付けたくない場合は、読み込み時に SentenceTransformer(MODEL_ID, truncate_dim=256) と指定する方法もあります。
つまずきやすい点(公式の注意)
- 精度の指定:bfloat16かfloat32を使い、float16は使わないよう案内されています(旧版のモデルカードにも同じ注意があります)。
- Ollama:公式ライブラリは、2026-10-07時点で新版のタグがなく、旧版(300m・約622MB・テキストのみ)だけが載っていました。Ollamaで試したい場合は、新版のタグが追加されるまで待つのが現実的です。
- 対応ツール:公式発表は、MediaPipe・LiteRT・transformers.js・WebGPU・Transformers・sentence-transformers・MLX・vLLM・llama.cpp・SGLang・Ollama・LM Studio・Qdrantを挙げています。ただし、各ツールが画像・音声・動画まで扱えるかは、公式の一覧からは分かりません。
もっと試したい人へ
公式の開発者ガイドは、次の2つも案内しています。
- Google AI Edge Galleryの端末上デモ「Instant Media Search」「Video Moments Finder」
- 微調整(ファインチューニング)に使えるUnsloth
向く人・向かない人
- 向く人:画像・音声・動画・コードのどれかを検索対象に入れたい人。ライセンスがApache 2.0なので、商用利用も可と公式発表が明記しています。
- 向かない人:文章だけを検索し、すでに旧版で運用している人。多言語テキストの精度は旧版とほぼ同じなので、載せ替えの手間が見合うかを先に考えてください。
なお、191MBという数字はPixel 11 Pro上で量子化したテキストのみの構成の値です。PCの要件は公式に記載がありません。
前バージョンや他の埋め込みモデルとの違い
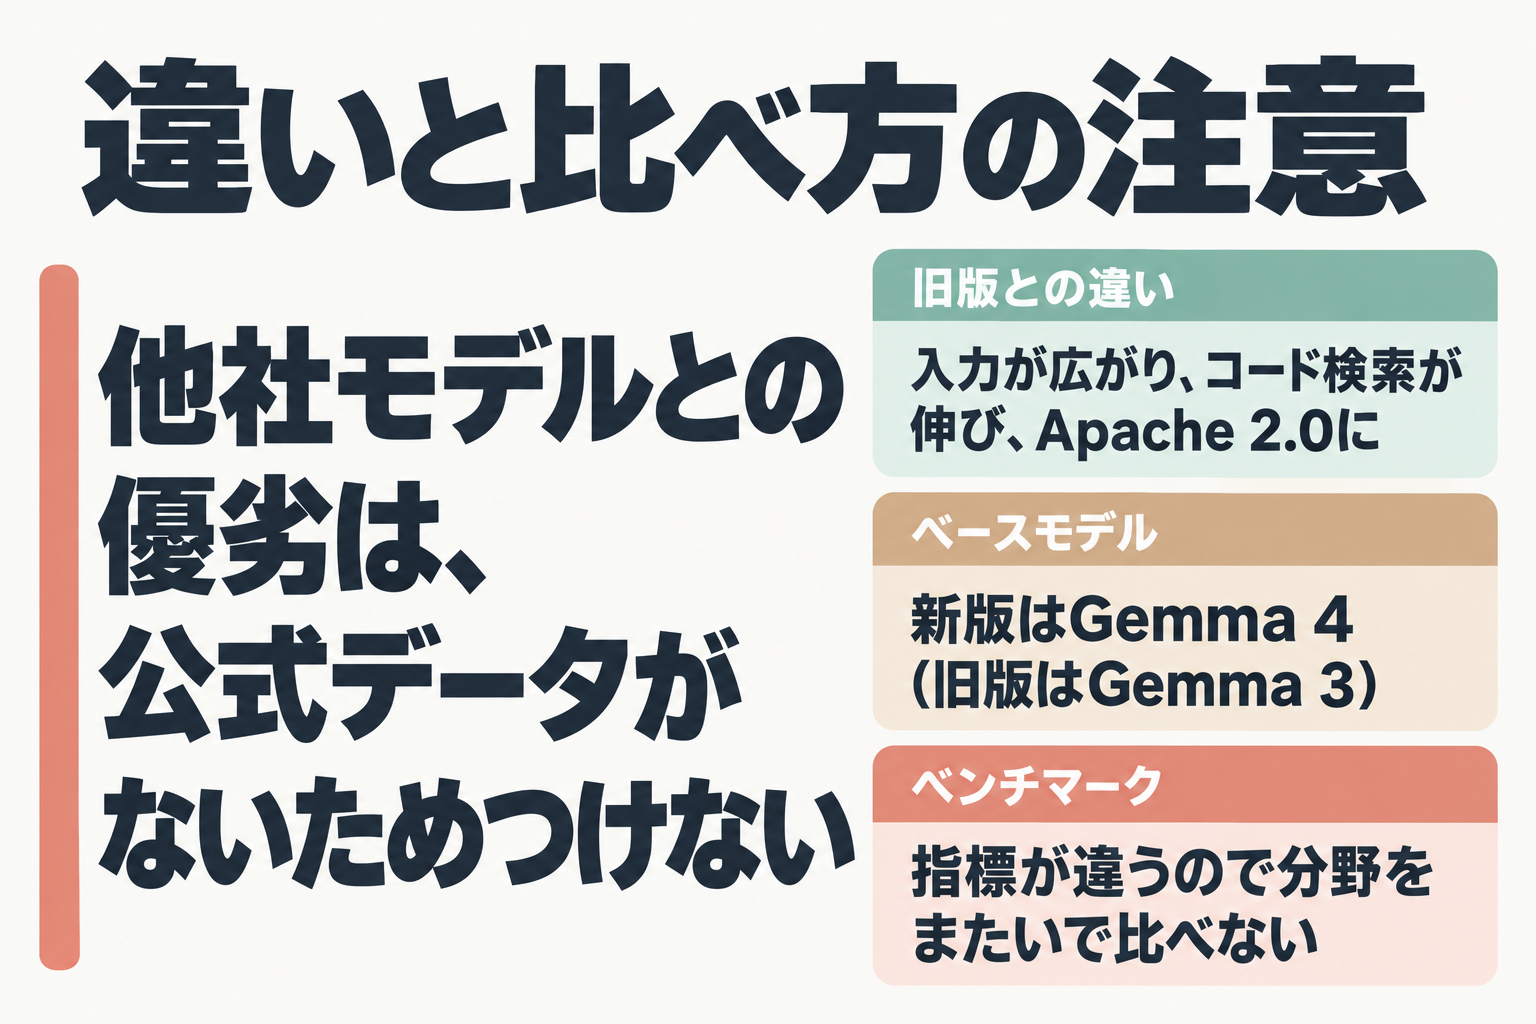
- 旧版との違い:上の対比表のとおりです。入力が広がり、コード検索が伸び、ライセンスがApache 2.0になりました。
- 同じGemma系のモデルとの違い:新版のベースはGemma 4です(旧版はGemma 3ベース)。
- 他社の埋め込みモデルとの違い:公式ページに他社モデルとの比較表はない(2026-10-07時点)ため、順位づけの根拠になる公式データがありません。この記事では優劣をつけません。
参考として、新版の公式ベンチマーク(768次元・モデルカード)は次のとおりです。関連記事:同じくGoogleの新モデルの違いを整理した Gemini 4 Argonとは?使える範囲・料金・違い も参考になります。
| 分野 | 指標 | 値 |
|---|---|---|
| テキスト | MTEB(multilingual v2) Mean(Task) | 61.36 |
| コード | MTEB(code v1) NDCG@10 | 78.68 |
| 画像 | MIEB(lite) Mean(TaskType) | 64.64 |
| 視覚文書 | MMEB v2 NDCG@5 | 67.84 |
| 動画 | MMEB v2 Hit@1 | 50.67 |
| 音声 | MSEB(Retrieval) MRR@10 | 69.54 |
指標ごとに計算方法が違うため、分野をまたいで数字の大小は比べられません。
よくある疑問
埋め込みモデルと生成AIは何が違う?
生成AIは文章や画像を作ります。埋め込みモデルは作らず、「似ているかどうか」を測る数字に変えるだけです。RAGでは、質問に近い資料を探す段階で埋め込みモデルを使い、見つかった資料をもとに生成AIが答えます。
ライセンスと商用利用は?
新版はApache 2.0で、公式発表は商用可と明記しています。旧版はGemma利用規約でした。利用前に、モデルカードのライセンス表記を確認してください。
既存のRAGから載せ替えるときの注意は?
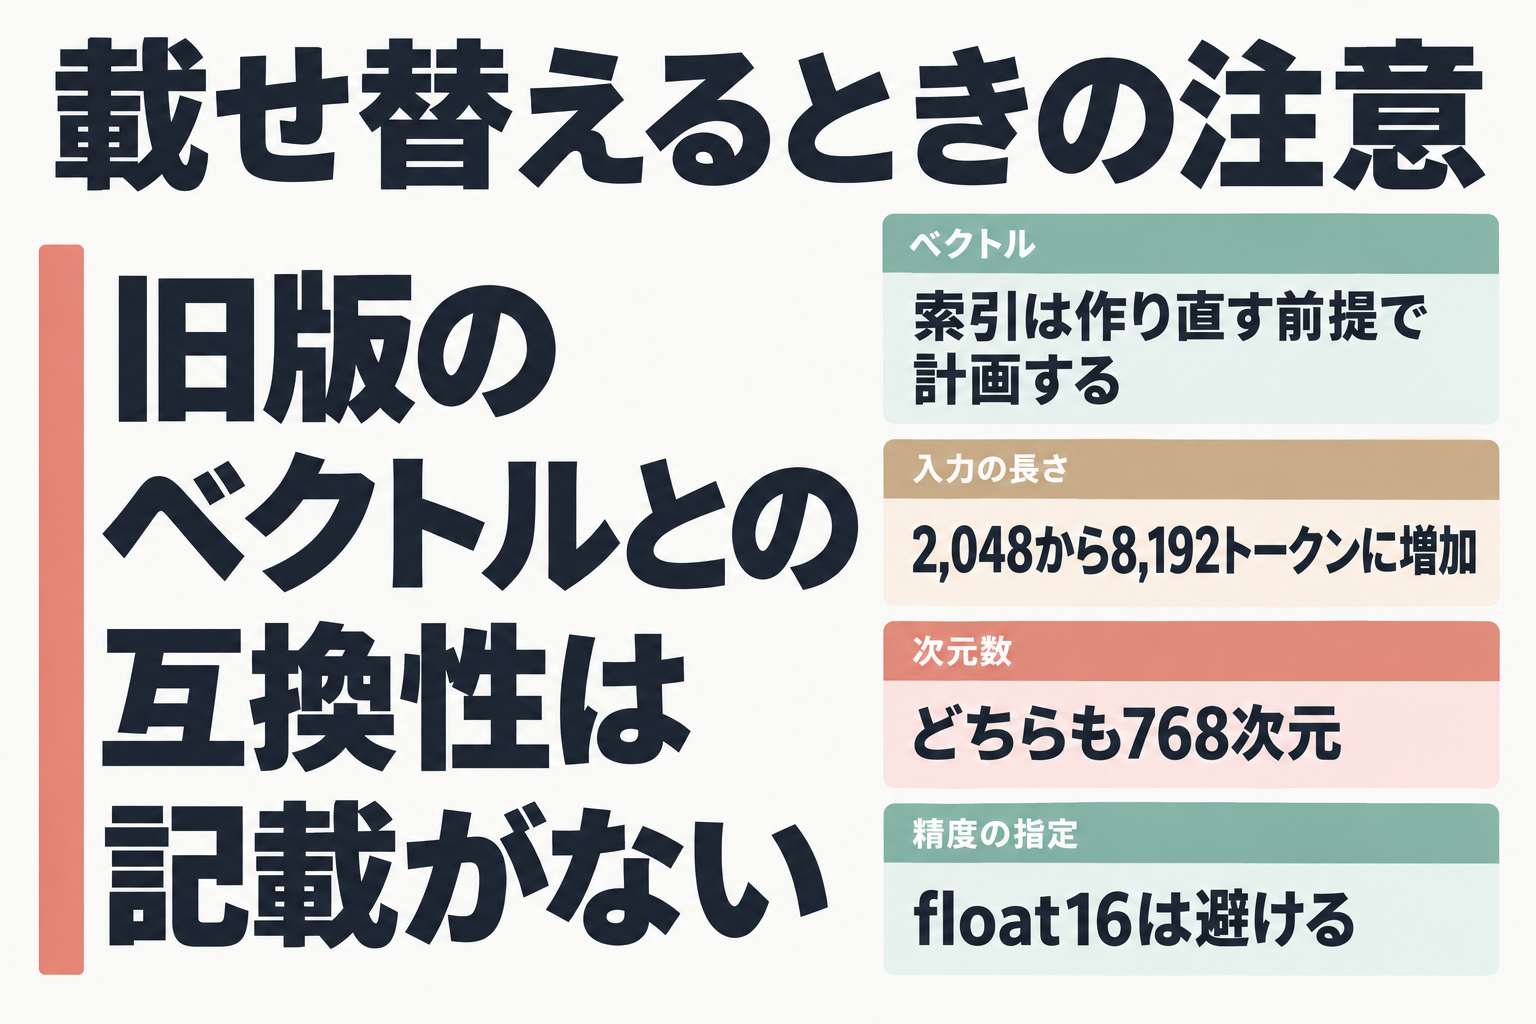
- ベクトルの互換性:旧版のベクトルと新版のベクトルが同じ空間かどうかは、公式ページに記載がありません。記載がない以上、載せ替えるときは索引を作り直す前提で計画するのが安全です。
- 次元数:どちらも768次元なので、データベース側の設定は同じにできます。ただし、ベクトルの中身は別物の可能性があります。
- 入力の長さ:1回に入る量が2,048から8,192トークンに増えています。文書の分割サイズ(チャンク長)の見直し余地があります。
- 精度の指定:float16は避け、bfloat16かfloat32を使います。
日本語は使える?
公式は「100以上の言語」と書くのみで、日本語の個別の性能値は公開されていません(2026-10-07時点)。日本語の資料で使うなら、自分のデータで検索の当たりを小さく試してから広げてください。
次の一歩|まず文章だけで読み込む
使う入力の種類で構成を決めると、無駄が出ません。文章とコードだけなら270M、画像も探すなら440M、音声も探すなら570M、両方なら740Mです。公式は、どの構成でも同じ空間に載り、文章だけの索引に後から画像や音声を足しても計算済みの埋め込みを計算し直さなくてよいと説明しています。
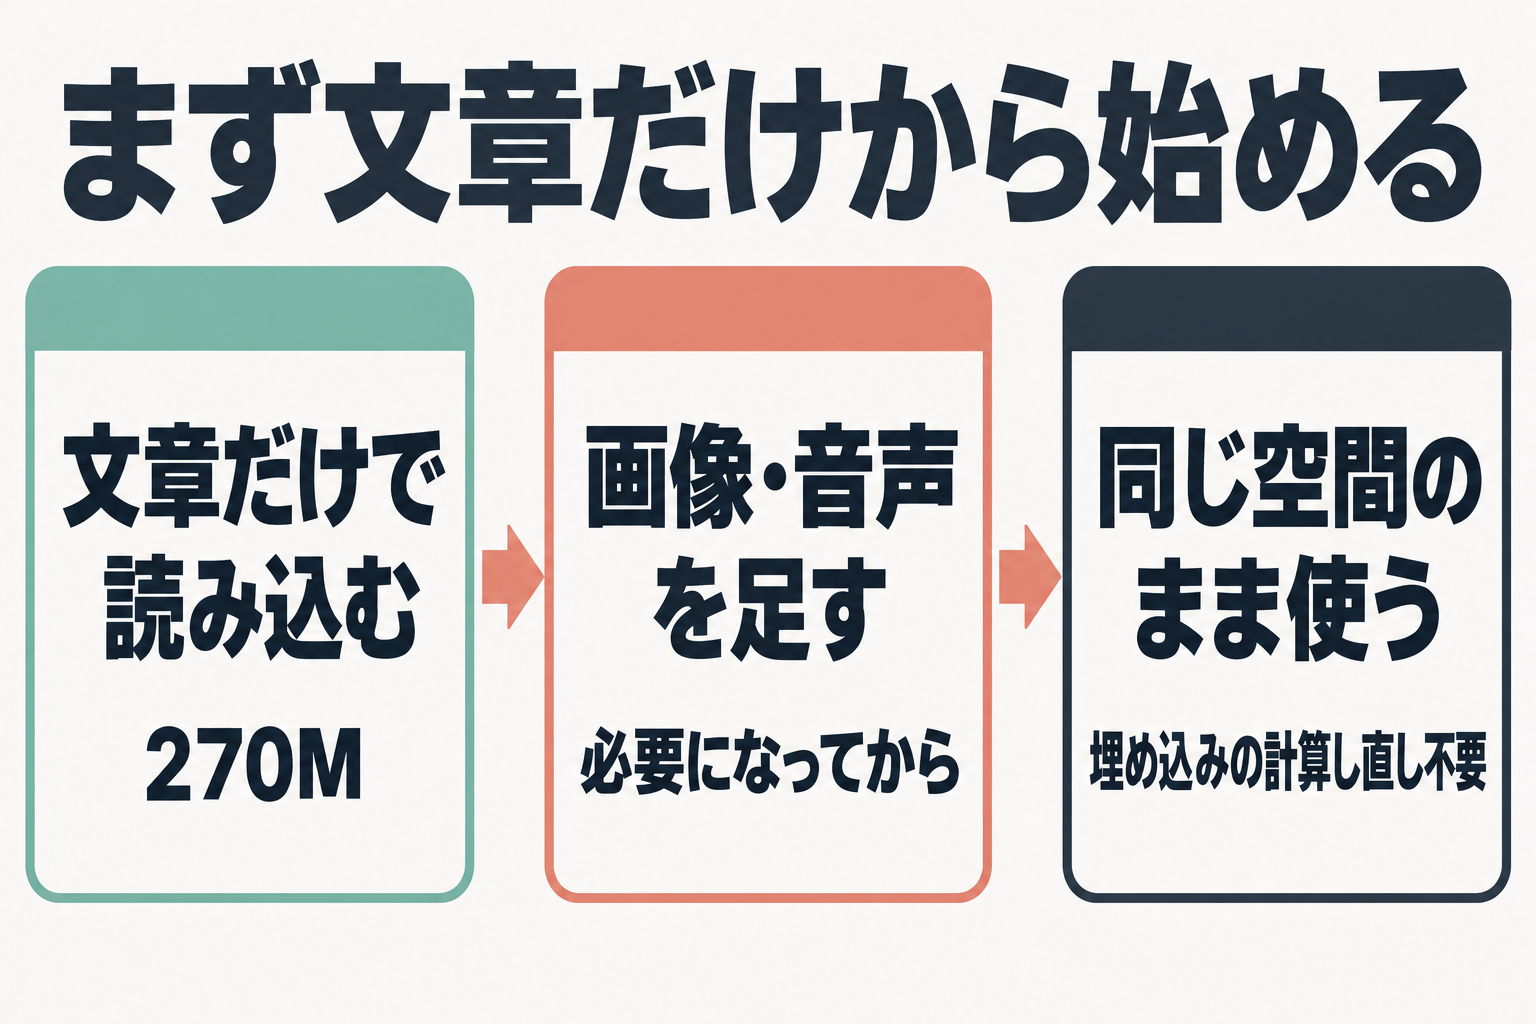
そこで、今日やるのは1つだけです。google/embeddinggemma-2 を、sentence-transformersで読み込む。最初は文章だけ(270M)で構いません。画像や音声は、必要になってから足せます。
画像も検索したい人は440M、文章とコードだけなら270Mの構成を選べます。
EmbeddingGemma 2 をダウンロードする(公式)まとめ
- EmbeddingGemma 2は、文章・コード・画像・動画・音声を同じ768次元の空間に入れられる、Apache 2.0のオープンな埋め込みモデルです(2026-10-06公開)。
- 旧版からの大きな変化は、入力の広がり・8,192トークン・コード検索の向上です。文章の精度はほぼ同じです。
- 文章だけなら270M、画像も探すなら440M、音声も探すなら570M、画像も音声もなら740M。次元は256から始めるのが無難です。
- 画像や音声も検索対象にするなら新版。文章だけなら、旧版のままでも足りる可能性があります。
入手先は、Hugging Faceの google/embeddinggemma-2、解説はGoogle AI for Developersとモデルカードです。