LegalOn Technologies(法務AIの会社)は、AIコーディングツール「Codex」の使い方を変えて、日次の推計コストを65%減らしました。OpenAIが2026年10月8日に公開した事例によると、開発スピードは維持できたとのことです。
つまり起きたのは、「いちばん強いモデルを全員が無制限に使う」運用から、「軽いモデルを基本にして、難しい作業のときだけ段階的に上のモデルへ上げる」運用への切り替えです。AIコーディングの費用が膨らんで、どのモデルをどの作業に使えばよいか迷っている個人開発者や小規模チームに関係する話です。
この記事は、公式事例と公式の料金ページ・モデル紹介ページの記載にもとづく解説です。LegalOnの環境の再現や、weevee自身での計測は行っていません。
結論と最初の一歩|軽いモデルを土台に、難しい作業だけ上げる
迷ったら、次の考え方で始めるのがおすすめです。
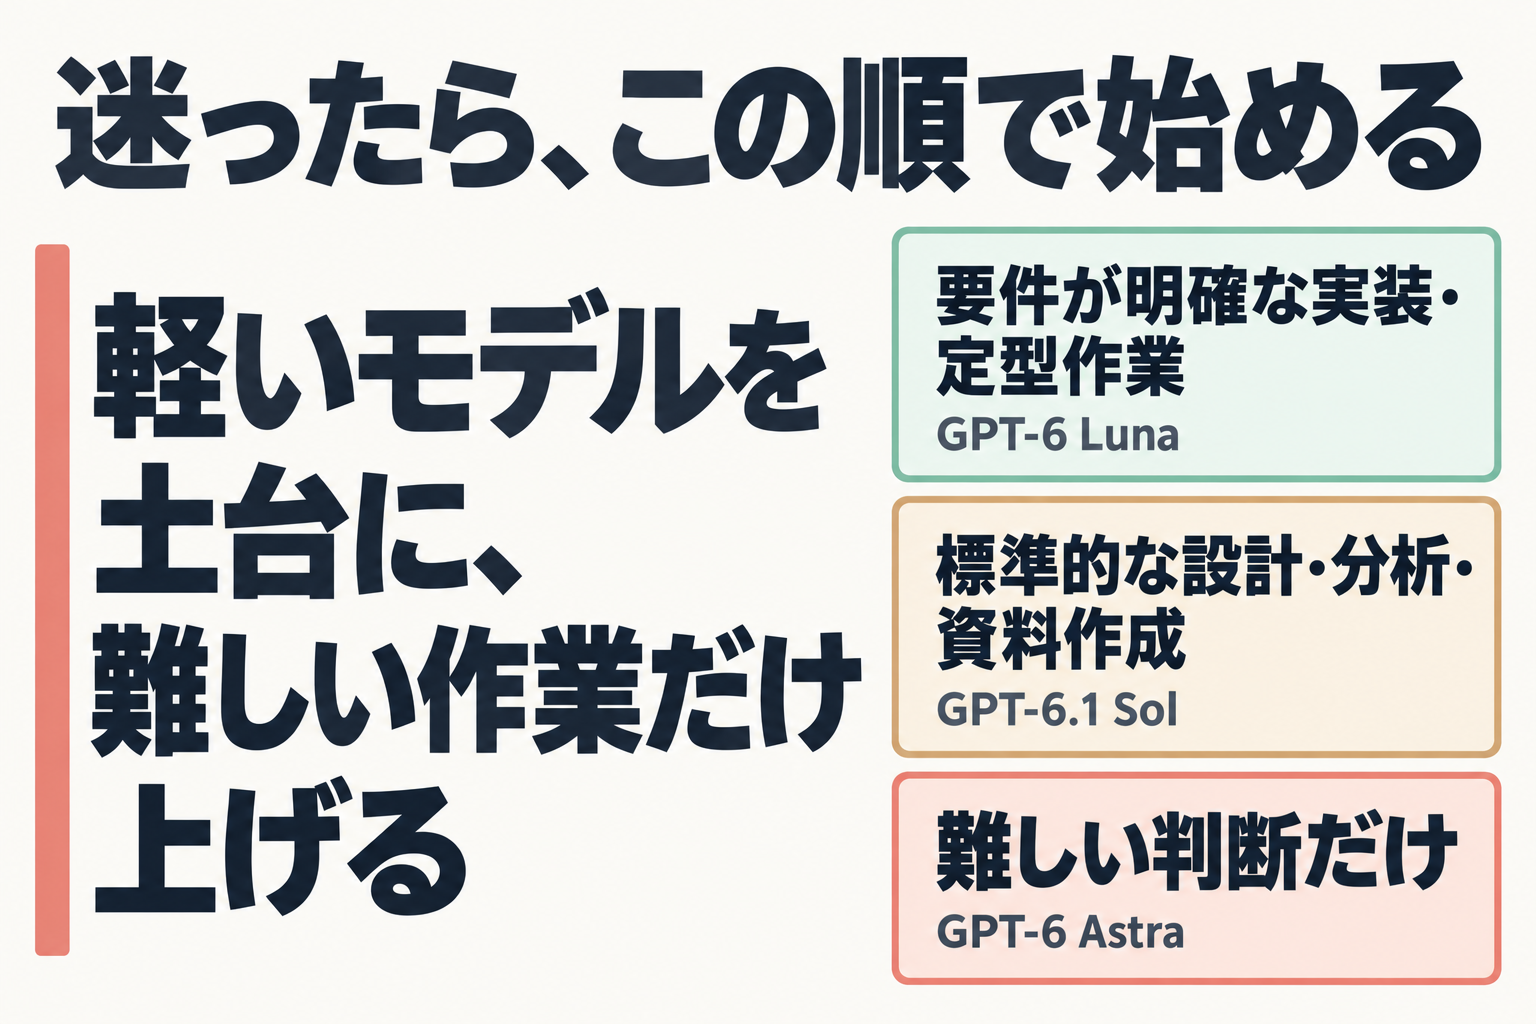
- 要件がはっきりしたコード実装や定型作業は、最軽量の GPT-6 Luna
- 標準的な設計・分析・資料作成は、GPT-6.1 Sol
- アーキテクチャ設計など難しい判断だけ、最上位の GPT-6 Astra
LegalOnの事例が示す得は、この順番に作業を振り分けたうえで、Fast mode(応答を速くする設定)を原則制限し、月次の利用上限を置いたことで、日次推計コストが GPT-5.5 運用比で65%下がった点です。
最初の5分でやることは1つだけです。直近1週間にCodexへ頼んだ作業を思い出して、「要件が明確な実装」と「設計や調査が要る作業」に二分してください。メモ書きで十分です。
使い分け前と後|何が変わったのか
注意したいのは、**65%の比較相手が「単一の最上位モデル」ではなく「GPT-5.5(Fast mode)を制限なく使える状態」**だという点です。公式事例はこう書いています。
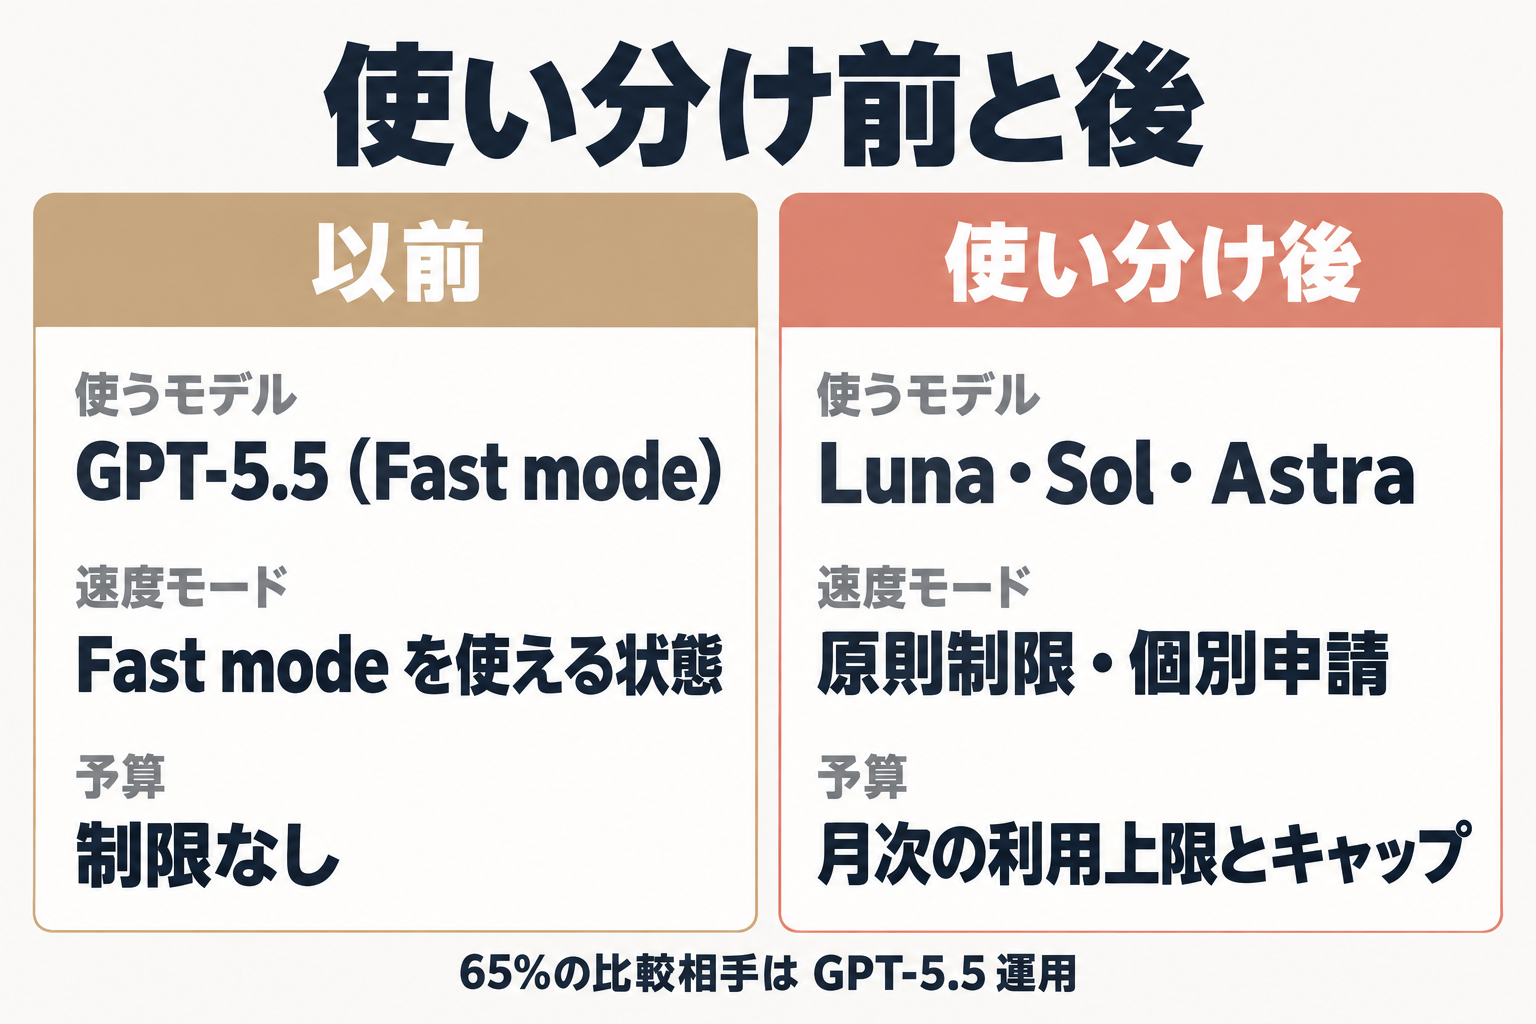
| 観点 | 以前 | 使い分け後 |
|---|---|---|
| 使うモデル | 主力の GPT-5.5(Fast mode)を制限なく利用 | 難易度に応じて Luna・Sol・Astra。軽量モデルを土台に段階的に引き上げる |
| 速度モード | Fast mode を使える状態 | Fast mode は原則制限し、必要なときだけ個別申請 |
| 予算 | 高性能モデルを無制限に使えば年間予算の超過は避けられない、と認識 | 部門・個人ごとの月次の利用上限と、予算配分の「キャップ」 |
| モデルの選び方 | 公式に記載なし | AI専門組織が推奨モデルの選定指針を整備し、エンジニアが自分で選ぶ |
以前の運用では、開発メンバーが制限なく強いモデルを使え、設計・実装・日常業務へ活用が広がりました。一方で、使い続ければ年間予算を超えてしまう。かといって一律に制限すると生産性を損なうおそれがある。このジレンマが出発点でした。
どの作業にどのモデルを当てたか
公式事例の割り当ては次のとおりです。読者の仕事の言葉に置き換えて整理します。
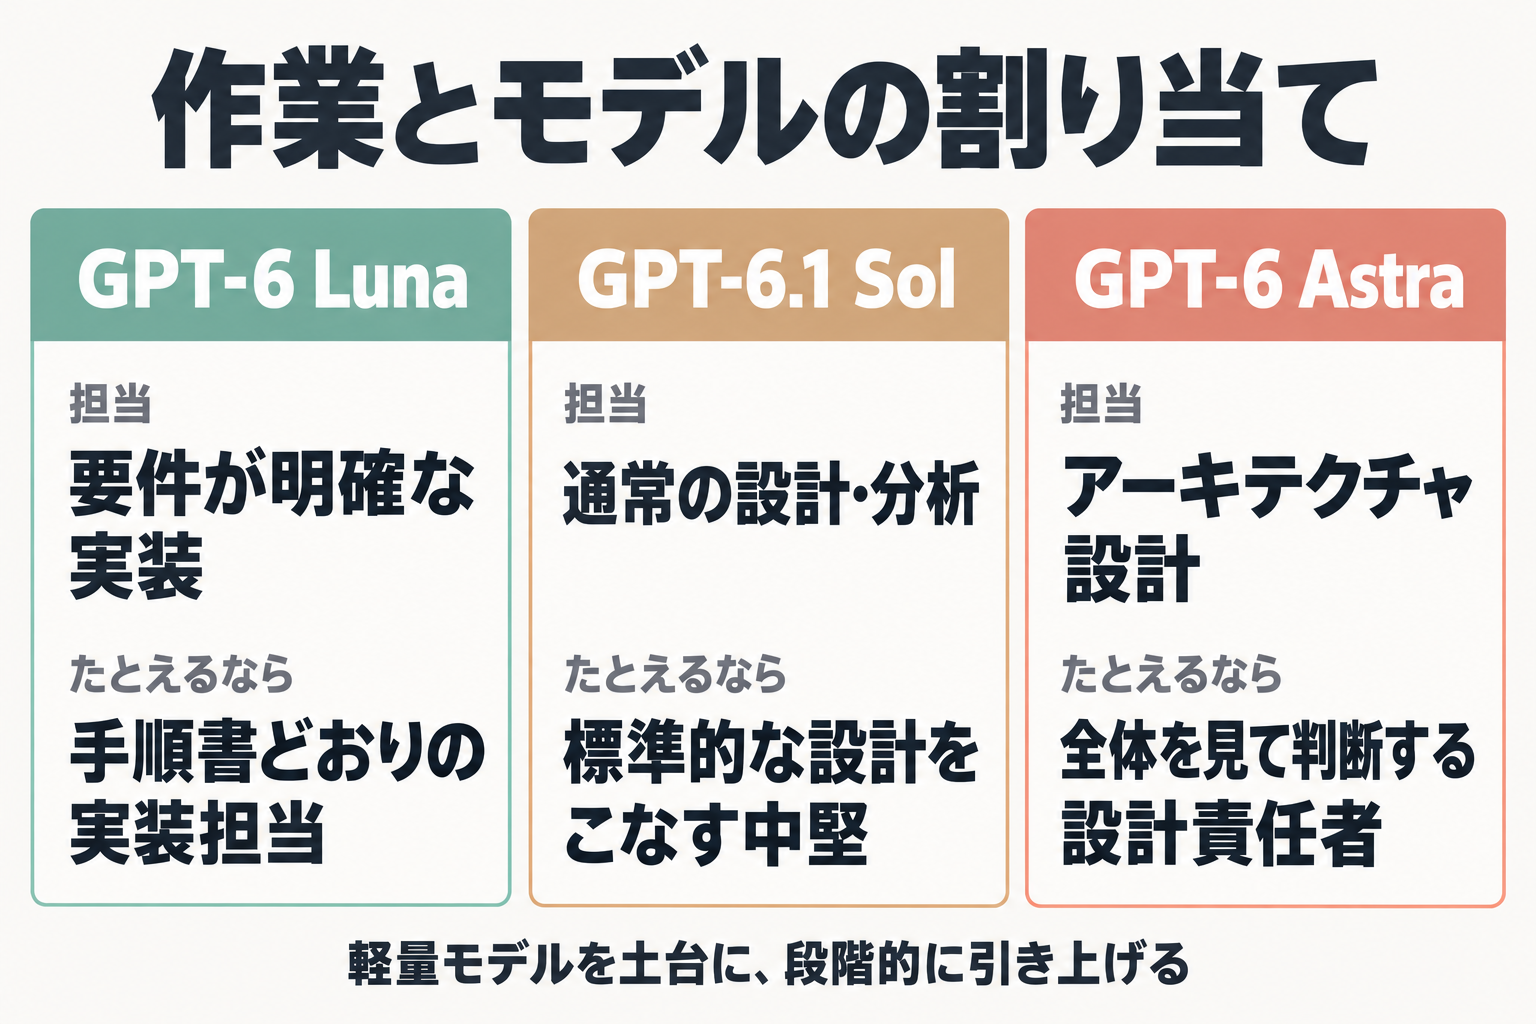
| モデル | 担当する作業 | たとえるなら |
|---|---|---|
| GPT-6 Luna | 要件が明確なコード実装(主にサブエージェント)、日常の自動化、比較的単純な作業・分析の委譲 | 手順書どおりに進める実装担当 |
| GPT-6.1 Sol | 通常の設計・分析、数値分析・資料作成、Lunaより作業時間を短くしたいとき | 標準的な設計をこなす中堅 |
| GPT-6 Astra | アーキテクチャ設計、複雑な分析・設計、エージェント全体の統括(オーケストレーター) | 全体を見て判断する設計責任者 |
※サブエージェントは、メインのAIから細かい作業を任される小さなAIのことです。
OpenAIのモデル紹介ページも同じ方向の説明をしています。Astraは「複雑な仕事に向けた最も高性能なモデル」で、ツールをまたぐ全工程で最大の能力が要るときに選ぶもの。GPT-6.1 Solは「Astraに近い性能を、Astraより低コストで」提供し、コストが重要なときに検討するもの。Lunaは「集中した大量タスクに最も効率的」で、抽出・分類・変換・構造化された要約のような、明確で繰り返せる作業に向くとされています。
LegalOnの運用方針は「まずは軽量モデルをベースに置き、難易度に応じて段階的にレベルを引き上げていく」でした。最初から最上位に頼らず、足りなければ一段上げる、という順序です。GPT-6.1 Solの価格や位置づけの詳細は、GPT-6.1 Solの価格と乗り換え判断で整理しています。
なぜ使い分けるとコストが下がるのか
公式の料金ページには、モデルごとの「利用上限」の表があります(2026年10月9日確認、PlusとBusiness標準は同じ数字)。
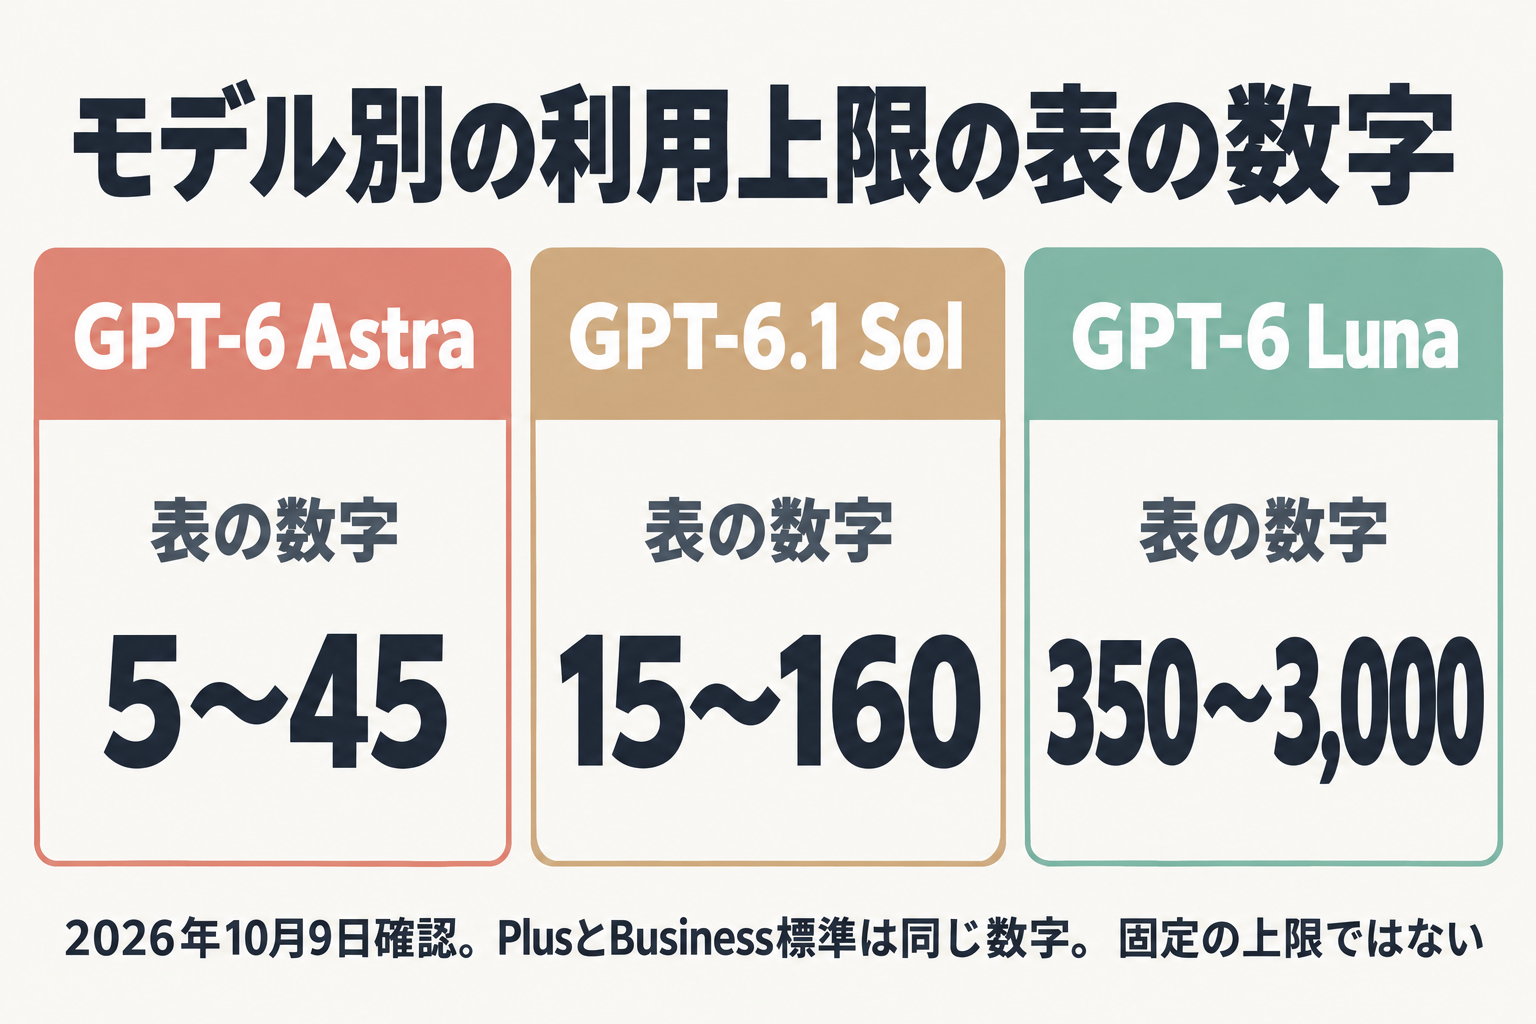
| モデル | 表の数字 |
|---|---|
| GPT-6 Astra | 5〜45 |
| GPT-6.1 Sol | 15〜160 |
| GPT-6 Luna | 350〜3,000 |
同じプランでも、Astraは5〜45、Lunaは350〜3,000と、モデルによって使える量の目安が桁違いに変わります。これは固定の上限ではなく、実際の消費はタスクやモデル、設定で変わります。料金ページには「利用上限に近づいたら低コストのモデルに切り替えれば、残りの利用枠を長く使える」「定型的なタスクでは低コストのモデルに切り替えると利用枠を長く使える」という案内もあります。なお、週次の利用上限も適用される場合があると同じページに書かれています。
もう1つの要因が推論レベル(AIがどれだけ深く考えるか)です。公式は「高い推論レベルは複雑な課題で結果を良くしうるが、時間がかかりトークンも多く使う」と説明しています。簡単な作業に高い設定を当てると、時間もかかり、使う量も増えやすくなります。
速度モードにはStandardとFastがあり、LegalOnは以前の運用で使えたFast modeを原則制限しました。開発スピードへの影響が心配されましたが、事例では「タスクの並行処理といった現場の工夫でカバー」して、パフォーマンスを維持したと書かれています。ただし、速度を数値で比べたデータは公式に載っていません。
予算をどう管理したか
モデルの使い分けと同じくらい大事なのが、予算の仕組みです。公式事例が挙げる取り組みは次の3つです。
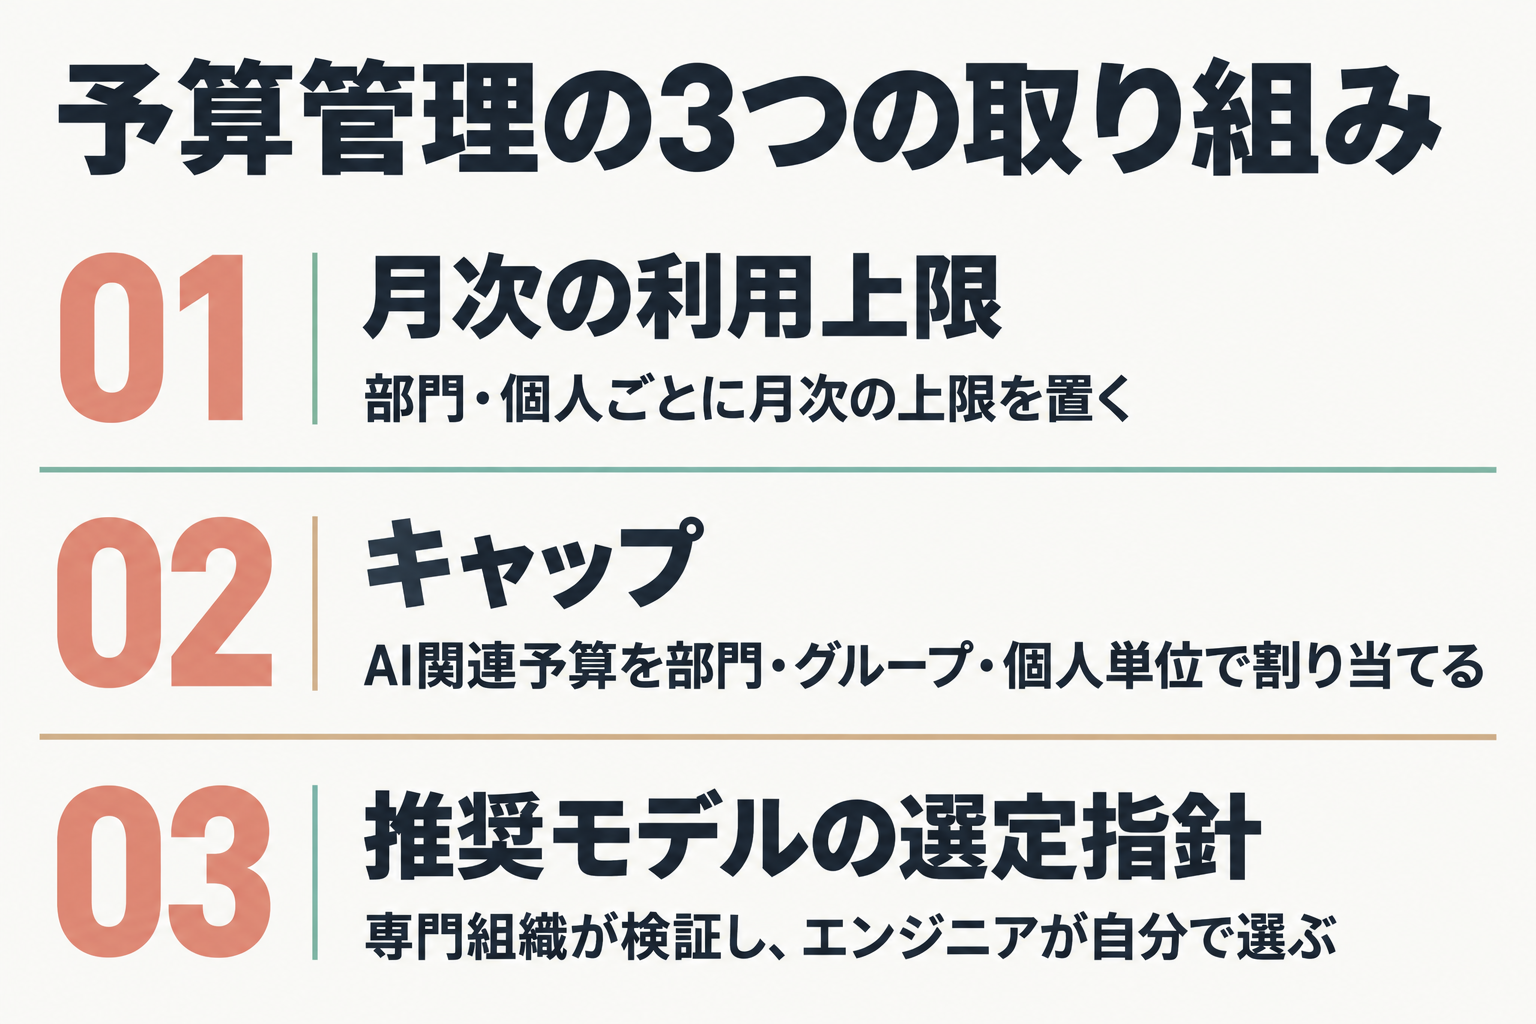
- 月次の利用上限: 管理者設定で、部門・個人ごとに月次の上限を置く。AI専門組織が利用状況を見て、業務上の必要があれば上限を柔軟に引き上げる
- キャップ(予算の割り当て): AI関連予算を部門・グループ・個人単位で割り当てる。成長フェーズの既存事業には最大約2割の効率化を求め、立ち上げフェーズの新規事業には潤沢な予算枠を確保する
- 推奨モデルの選定指針: 専門組織がモデルを検証・モニタリングし、知見をマネージャーが現場へ広げる。エンジニアはタスクごとに最適なモデルを自分で選ぶ
ここで混同しやすい数字があります。事例には「-20%」という数字もありますが、これは成熟した事業ドメインでのコスト削減率で、65%とは別物です。新規事業については、担当マネージャーの発言として「コスト効率よりも事業スピードを最優先し、AIを使い倒してアウトプットを増やす」方針が紹介されています。全部を一律に絞ったわけではなく、事業の段階で締め方を変えたのです。
自分の環境で今日試す最初の一歩
LegalOnのような組織の仕組みは、個人や小さなチームでも縮小して真似できます。公式ドキュメントにある範囲で、次の順で進めてください。
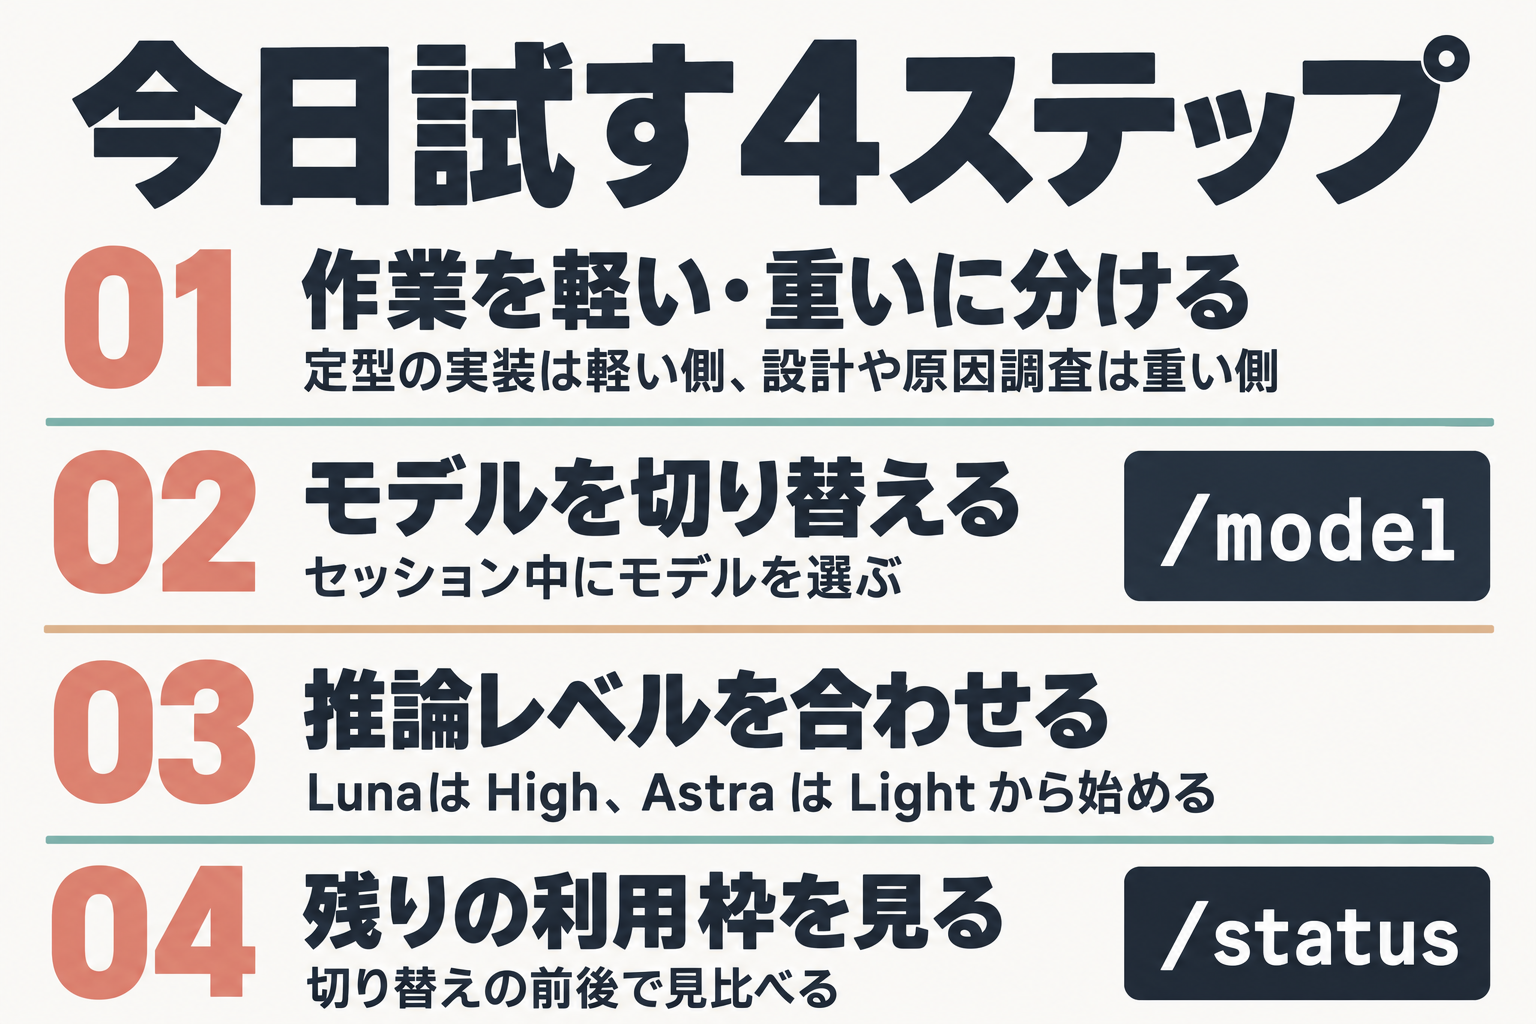
1. 作業を軽いものと重いものに分ける。 「要件が明確な実装・定型の変換」は軽い側、「設計や原因調査」は重い側です。
2. モデルを切り替える。 Codex CLIでは、セッション中に /model と入力するとモデルと推論レベルを選べます。起動時に指定するなら次のとおりです。
codex --model gpt-6.1-sol短縮形は -m です。非対話で実行する場合は codex exec -m gpt-6.1-sol "依頼文" の形になります。デスクトップアプリでは、入力欄の下にモデルと推論のコントロールがあります。
3. 推論レベルを合わせる。 公式の目安では、Lunaは「High」、Astraは「Light」から始めます(CLIではLightは「Low」)。Lightは短く範囲が明確な作業向け、Mediumは計画が要る作業向け、High/Extra Highは複数ステップやトレードオフのある難しい作業向けです。Max(1つのタスクに長く考えさせる)やUltra(サブエージェントで並列化する)は、公式も「ほとんどのタスクに不要」と書いています。
4. 残りの利用枠を見る。 セッション中に /status と入力するか、Codexの使用状況ダッシュボードで残量を確認します。モデルを切り替える前後で見比べると、自分の作業でどれだけ違うかが分かります。
「1日の費用」を見積もる際の注意点です。LegalOnの推計の算出方法は公式に載っていません。個人プランでは金額ではなく利用枠で見えるので、まずは「1週間で利用枠をどれだけ使うか」を /status で記録するところから始めるのが現実的です。
プラン面では、料金ページの価格は2026年10月9日時点で、Goが月1,400円、Plusが月3,000円、Proは月16,800円からです。Astraは、Plusと$20のBusinessプランでは一定量まで利用でき、それ以上はクレジットを購入する形です。条件は改定されるので、申し込み前に公式の料金ページで最新の内容を確認してください。
Codexで軽い作業から試してみるなら、まずは今使っているプランのまま、定型の実装をLunaに任せるところからが手軽です。
利用枠が早く尽きる人は、定型作業を軽いモデルに切り替えると枠を長く使える(公式FAQ)
Codex(OpenAI) の料金プランを確認する(公式)向いている人と、効果が出にくい人
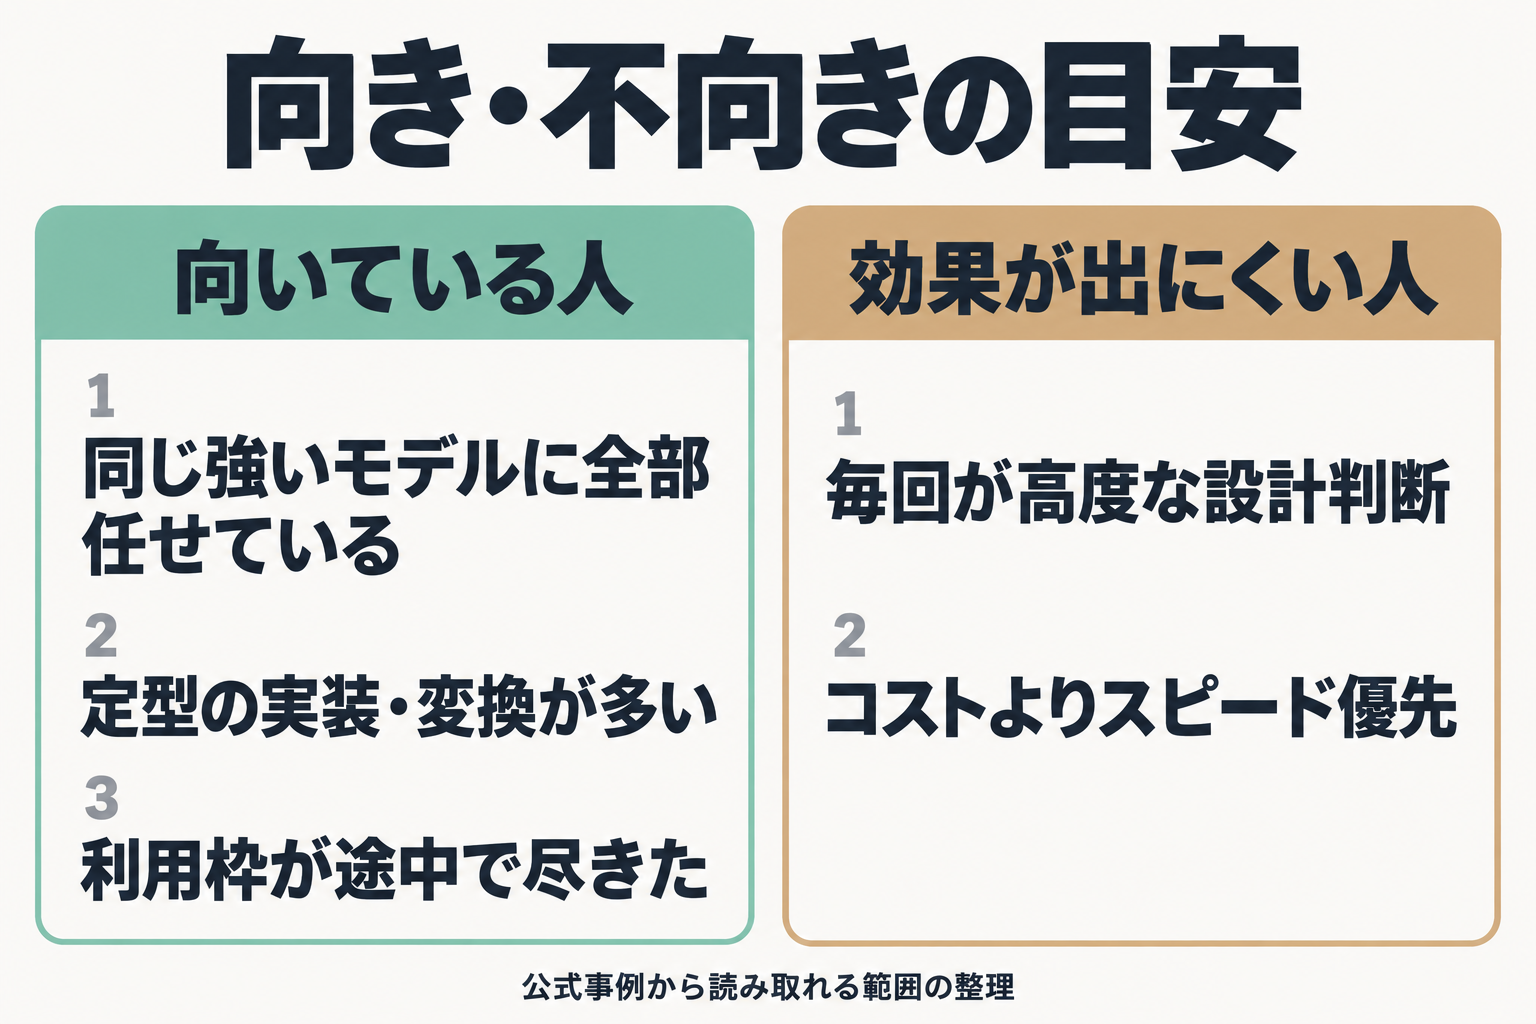
向いている人
- 設計も実装も日常作業も、すべて同じ強いモデルに任せている人
- 要件が明確な実装や、変換・要約のような定型作業が多い人
- 利用枠が途中で尽きて、止まった経験がある人
効果が出にくい人
- 毎回が高度な設計判断や複雑な調査で、軽いモデルに回せる作業が少ない人
- 事業の立ち上げ期で、コストよりスピードを優先したい人(LegalOnも新規事業には潤沢な予算枠を置いています)
後者の見分け方は、公式事例から読み取れる範囲に限ります。事例に「この人には効かない」という直接の記述はないため、上記はLegalOnの成熟事業と新規事業の扱いの違いを手がかりにした整理です。
65%を読むときの注意点
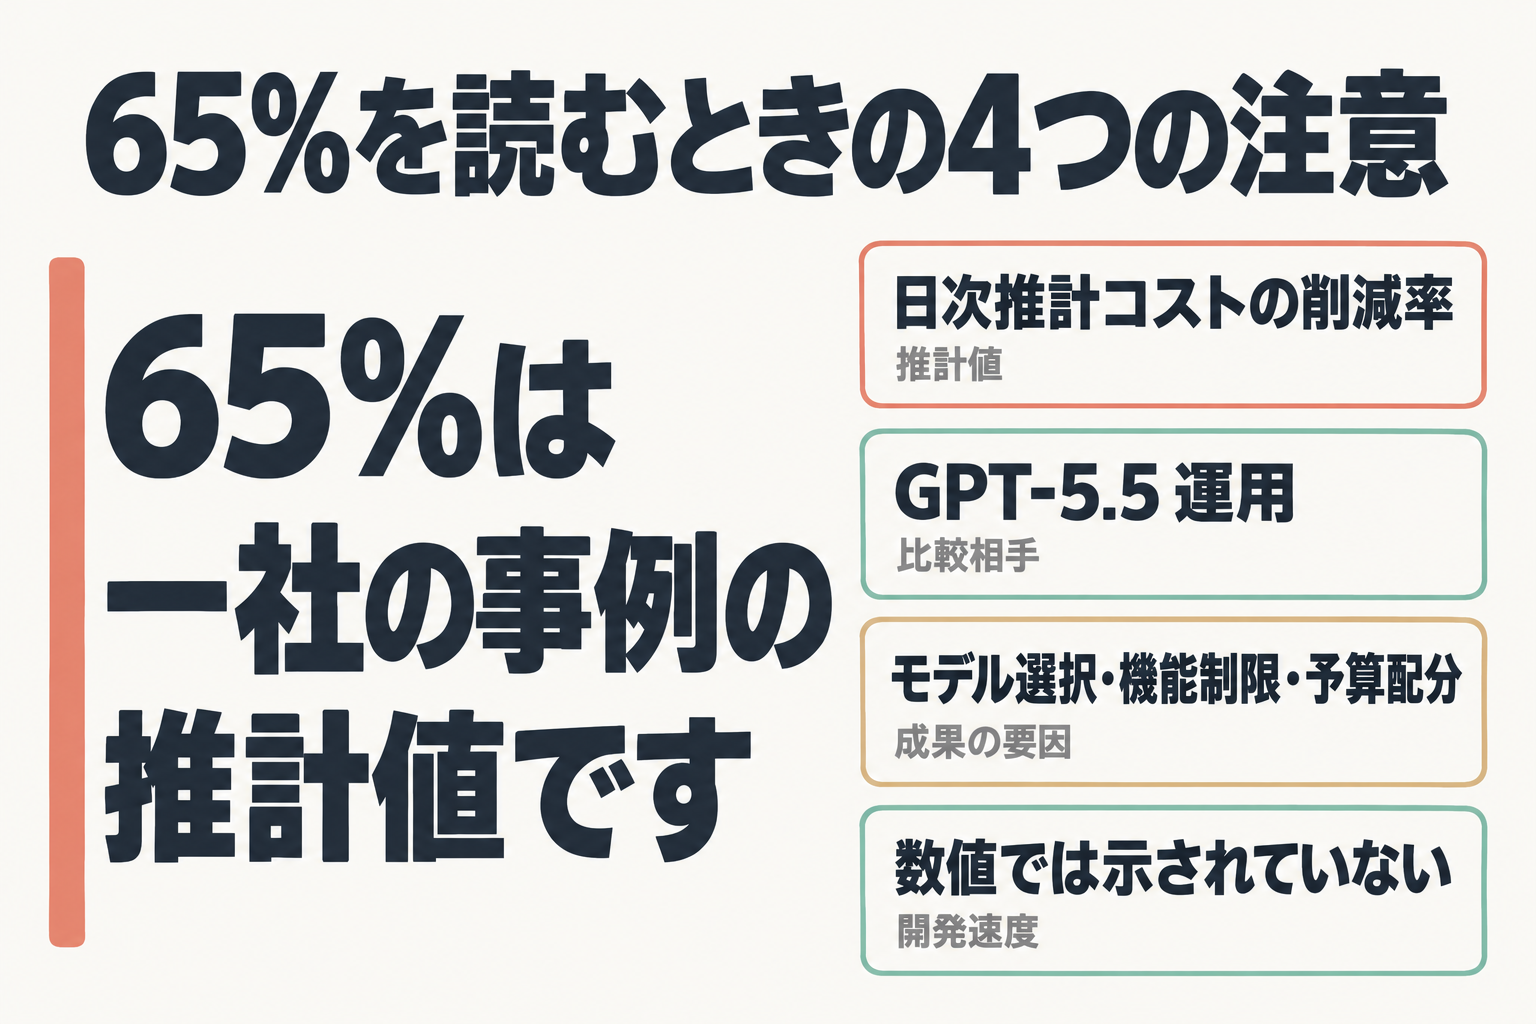
- 一社の事例の推計値です。 公式は「日次推計コスト」の削減率として示しています。比較期間、対象範囲、算出方法は公式に記載がありません。
- 比較相手は GPT-5.5 運用です。 公式が示す成果は、GPT-6/6.1シリーズの使い分けで GPT-5.5 と比べた数字です。なお、GPT-5.5は2026年10月14日にChatGPTとCodexの全プランで終了すると、モデル紹介ページに案内されています(APIは対象外)。
- モデルの使い分けだけの成果ではありません。 公式は「モデル選択、機能制限、そして事業に応じた予算配分」の一連の取り組みの成果としています。Fast modeの制限と月次上限も効いています。
- 使い分け後の開発速度は数値で示されていません。 「落とさず運用」という記載と、並行処理などの工夫が根拠のすべてです。
LegalOnは今後、「機能リリース数」を単位に顧客価値とAIコストを結びつける指標を作る予定で、設計・実装・レビューの各工程で最適なモデルの組み合わせを蓄積する基盤も計画しています。いずれも公式は「構築している段階」「計画」と書いており、完成済みの仕組みではありません。
もっと詳しく
- 同じ考え方で、Claude Codeの費用を抑える設定はClaude Code従量課金|予算アラート3段階が参考になります。
- Astraを業務で使った公式事例はGPT-6 Astraの業務効率化事例にまとめています。
次の一歩|今日、定型の実装を1つLunaに任せてみる
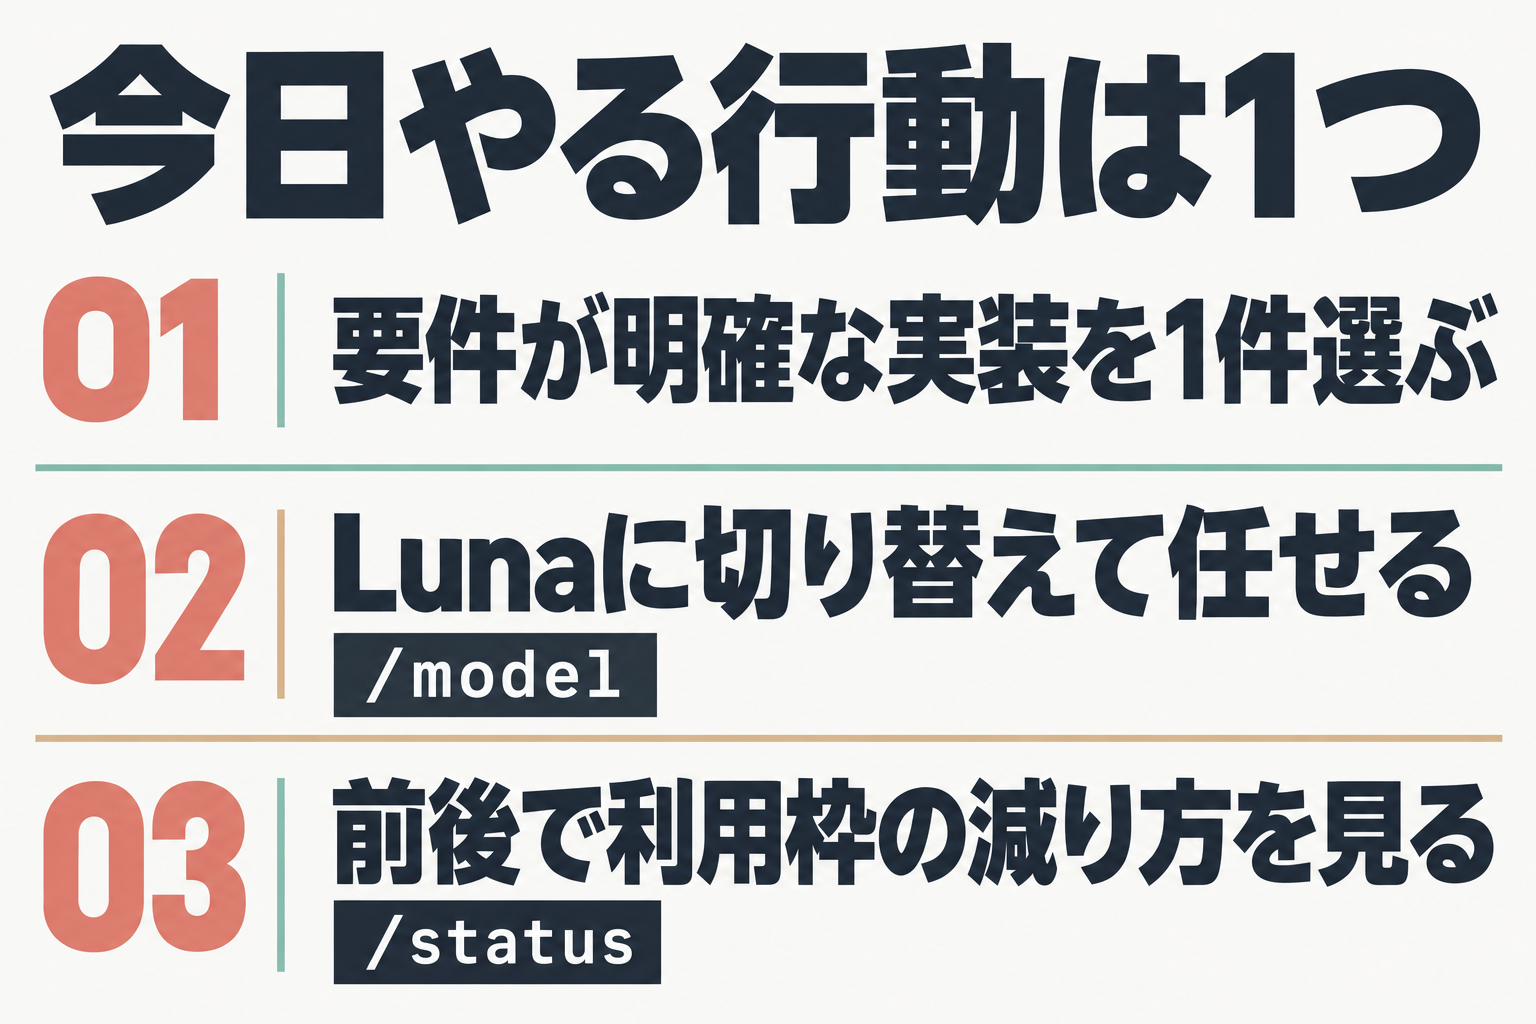
LegalOnの65%減は、強いモデルをやめたからではなく、作業の難しさに合わせて軽いモデルから始め、足りないときだけ段階的に引き上げたことと、Fast modeの制限、月次上限が組み合わさった結果でした。今日やる行動は1つです。要件が明確な実装を1件選んで、/model でLunaに切り替えて任せ、前後の /status で利用枠の減り方を見てみてください。