2026年10月15日、Metaが「Muse Spark Open」の重みを公開しました。画像・動画・音声も読み込める(マルチモーダル)大型モデルです。重みがダウンロードできるので、自分の環境に置いて動かせます。この形を「オープンウェイト」と呼びます。処理のたびに256人の専門家(エキスパート)のうち8人だけを動かす「MoE」という仕組みも使っています。
本記事は公式のHugging Faceブログ、モデルカード、ライセンス本文に書かれている内容に基づきます。実機での計測は行っていません。公式情報と報道は本文中で区別して書きます。
Muse Spark Openとは?結論と今日の最初の一歩
つまり何が起きたのか。 Metaが、画像・動画・音声まで入力できる大型モデルの重みを公開しました。商用利用も許諾されています。Meta自身は「現時点で最も高性能な米国発のオープンウェイトモデル」と位置づけています(Metaの評価です)。
迷ったらこれ。 結論は次のとおりです。
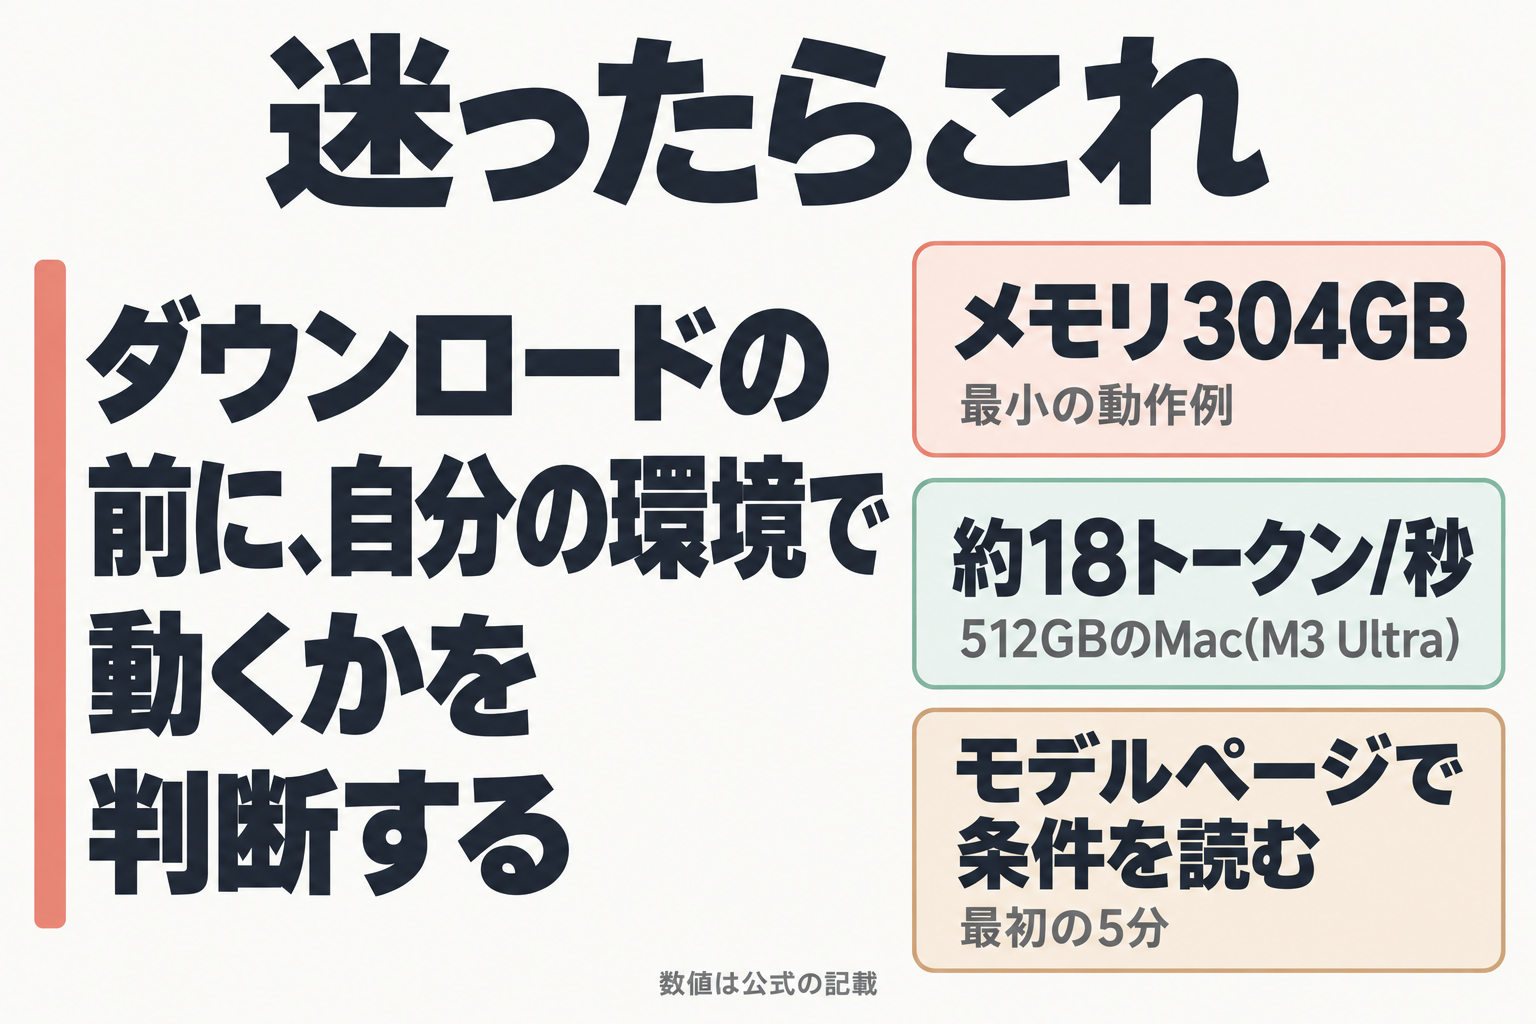
- 手元のPCや16GBクラスのVPSで動かしたい人: Muse Spark Openは向きません。公式が示す最小の動作例でもメモリは304GBで、16GBのVPSの約19倍です。手元に512GB級のメモリがなければ、API経由で試すのが現実的です(後述)。
- 512GBメモリのMac(M3 Ultra)かGPUサーバーを使える人: 試せます。公式は2-bit量子化(重みを小さく圧縮する方法)で約18トークン/秒の動作を示しています。
- 最初の5分でやること: Hugging Faceのモデルページを開き、ライセンスと必要メモリを読みます。ダウンロードを始める前に、自分の環境で動くかを判断してください。
用語を一言ずつ補足します。
| 用語 | 意味 |
|---|---|
| オープンウェイト | 学習済みの「重み」(モデル本体のデータ)が公開されていて、自分の環境に置いて動かせる |
| MoE | 処理のたびに全体の一部の「専門家」だけを動かす構造。計算は軽くなるが、重みは全部載せる必要がある |
| マルチモーダル | 文章だけでなく画像・動画・音声も入力できる |
Muse Spark Openでできること(公式の仕様から)
公式ブログとモデルカードに書かれている主な仕様です。
| 項目 | 内容 |
|---|---|
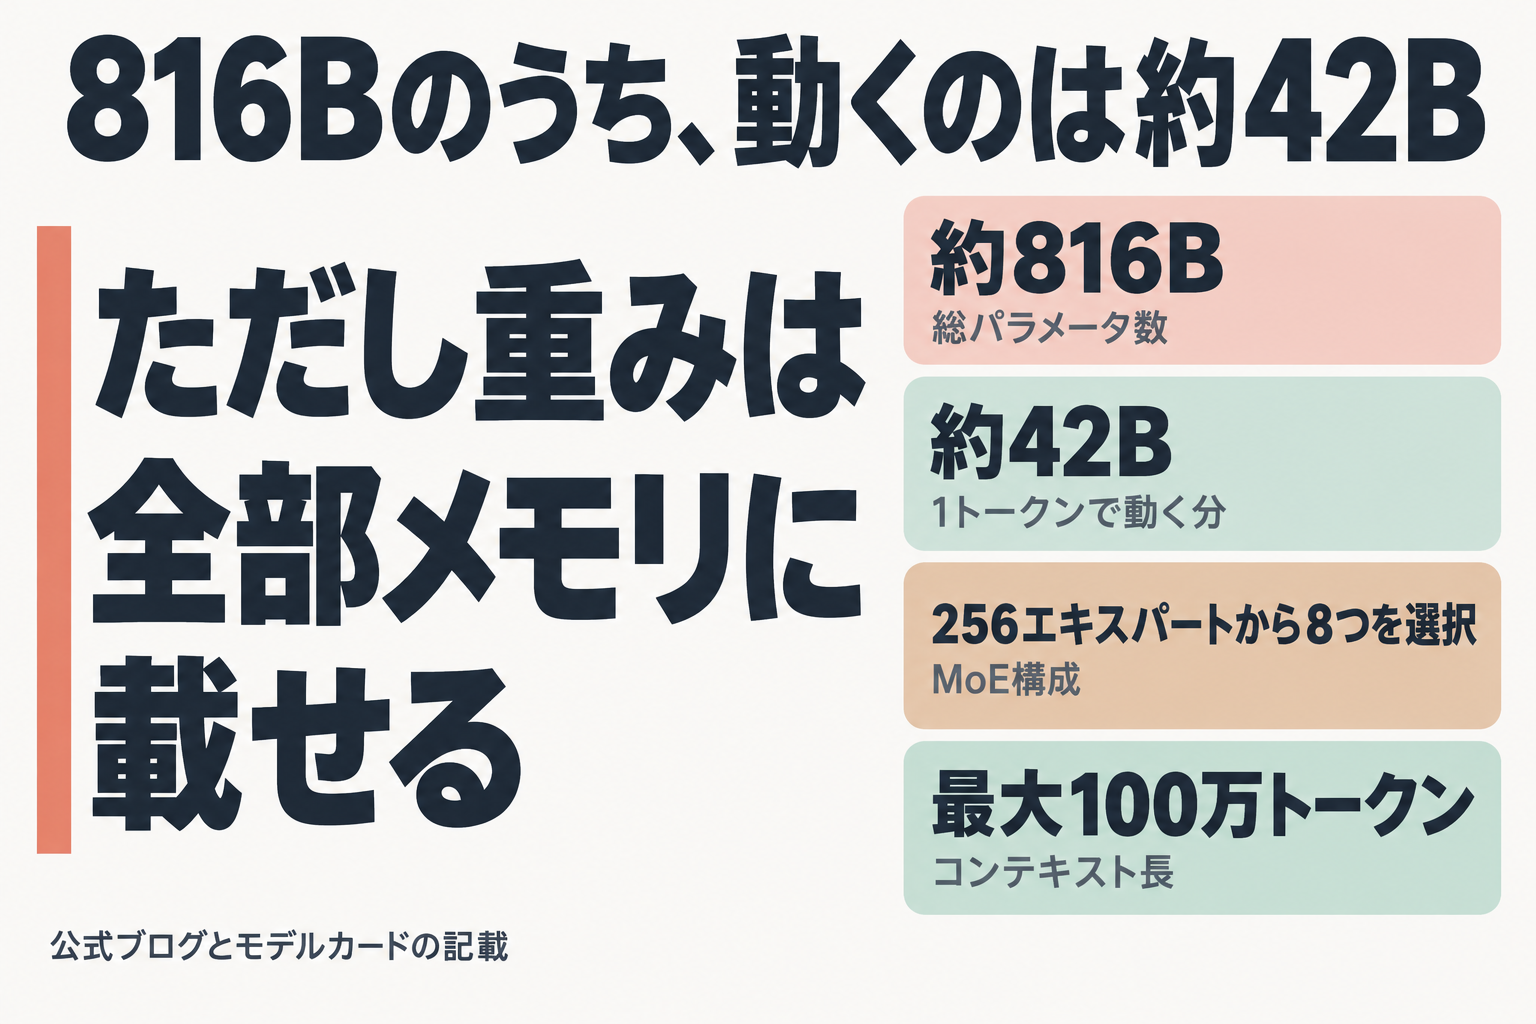
| 総パラメータ数 | 約816B(8,160億) |
| 1トークンで動く分 | 約42B |
| MoE構成 | 1層に256エキスパート、1トークンで8つを選択 |
| 入力 | テキスト・画像・動画・音声 |
| 出力 | テキスト |
| コンテキスト長 | 最大100万トークン |
| 対応言語 | 100以上 |
| 配布形式 | BF16 と NVFP4 の2種類 |
補足として、言語モデルは62層、隠れ次元は8192です。画像・動画用のエンコーダーは1.8B、音声は80msごとに1トークン(約12.5トークン/秒)で処理します。
公式ベンチマーク(モデルカード掲載)は次のとおりです。
| ベンチマーク | スコア |
|---|---|
| JobBench | 61.8 |
| MCP-Atlas | 89.2 |
| DeepSWE 1.1 | 60 |
| Terminal-Bench 2.1 | 76.4 |
| BabyVision | 80.2 |
| VideoMMEv2 | 61.5 |
| StrongREJECT v2 | 0.5(低いほど良い) |
ツール操作(MCP-Atlas、Terminal-Bench)とコーディング(DeepSWE)の両方が載っています。他社モデルとの比較は、公式の表で裏づけられる形では示せないため、優劣表は載せません。
何が進化したか:前世代のオープンモデルとの違い
Metaの前世代のオープンモデルは、2026年8月10日に公開された「Muse Glimmer」です。違いは次のとおりです。
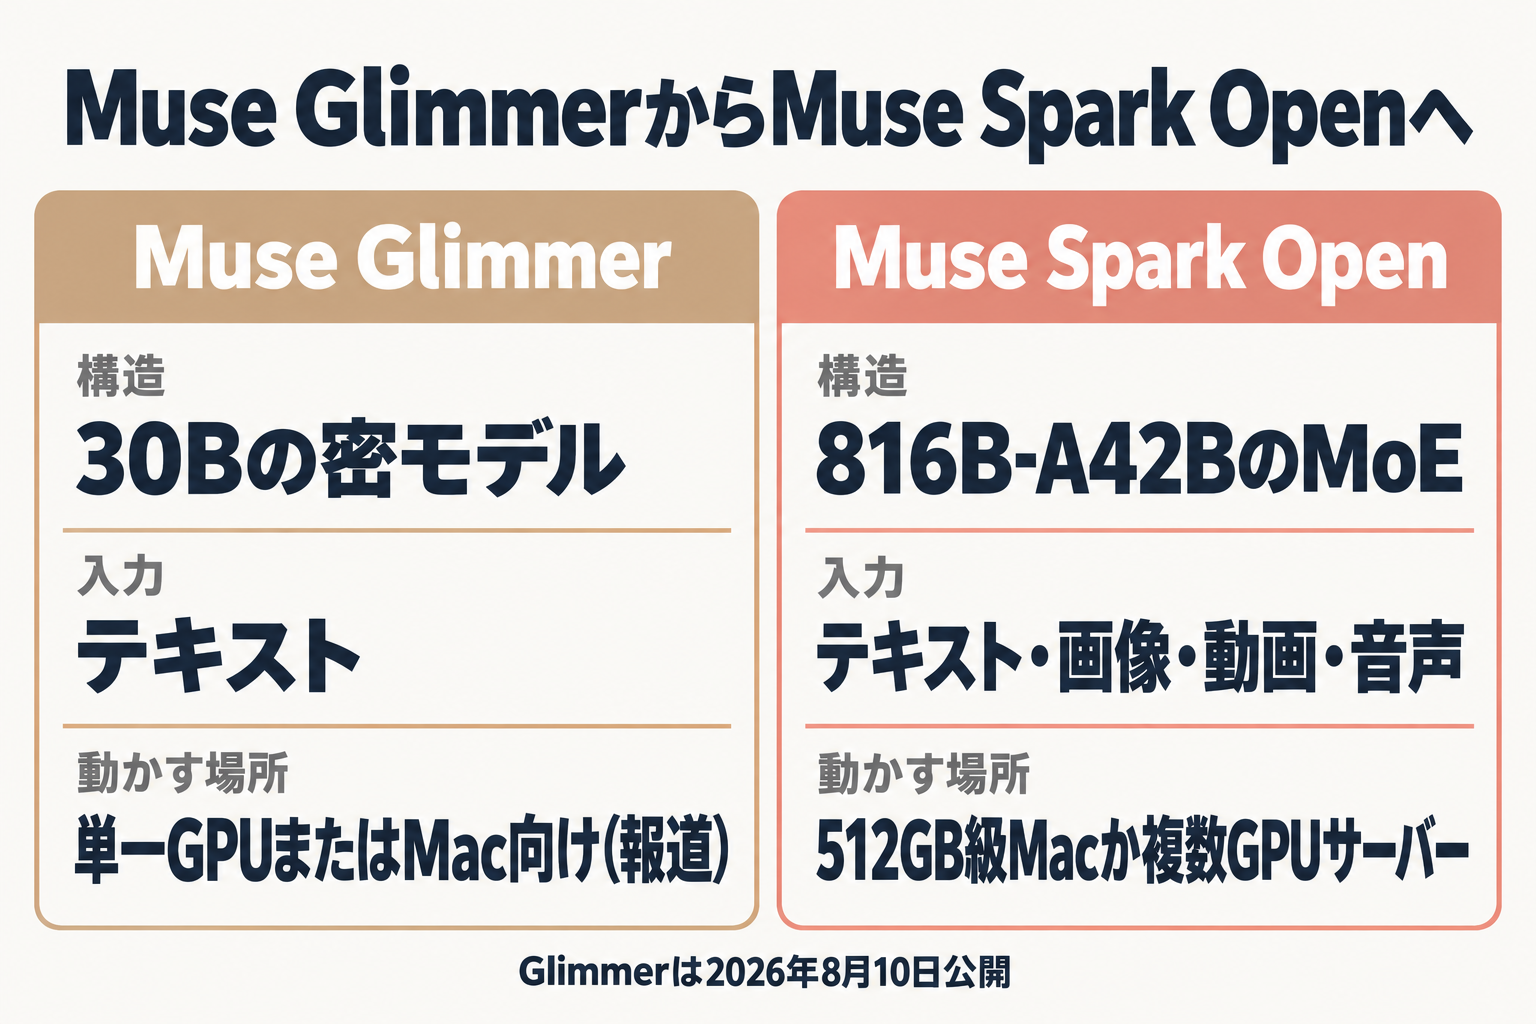
| Muse Glimmer | Muse Spark Open | |
|---|---|---|
| 構造 | 30Bの密(dense)モデル | 816B-A42BのMoE |
| 入力 | テキスト | テキスト・画像・動画・音声 |
| 動かす場所の目安 | 単一GPUまたはMac向け(報道) | 512GB級Macか複数GPUサーバー |
公式ブログによると、Spark OpenはGlimmerの「1層に1つの密FFN(全結合の計算部分)」をMoEブロックに置き換えた設計です。
Before → After: 小型の密モデルから、総量816Bの大型MoEになりました。1トークンあたりの計算は約42B分で済みます。一方で、重みを置く場所への要求は桁違いに増えました。
API・アプリ向けの「Muse Spark 1.x」シリーズとの関係は、公式ブログとモデルカードのどちらにも記載がありません。本記事では関係を推測せず、シリーズの各版の公開日も書きません。以前は「オープンウェイト版は未公開」とする記事がありましたが、2026年10月15日の公開により、その情報は古くなっています。
ライセンスと商用利用の条件
ライセンス名は「Muse Model License」です。公式のLICENSE.mdとモデルカードの内容を平易に整理します。
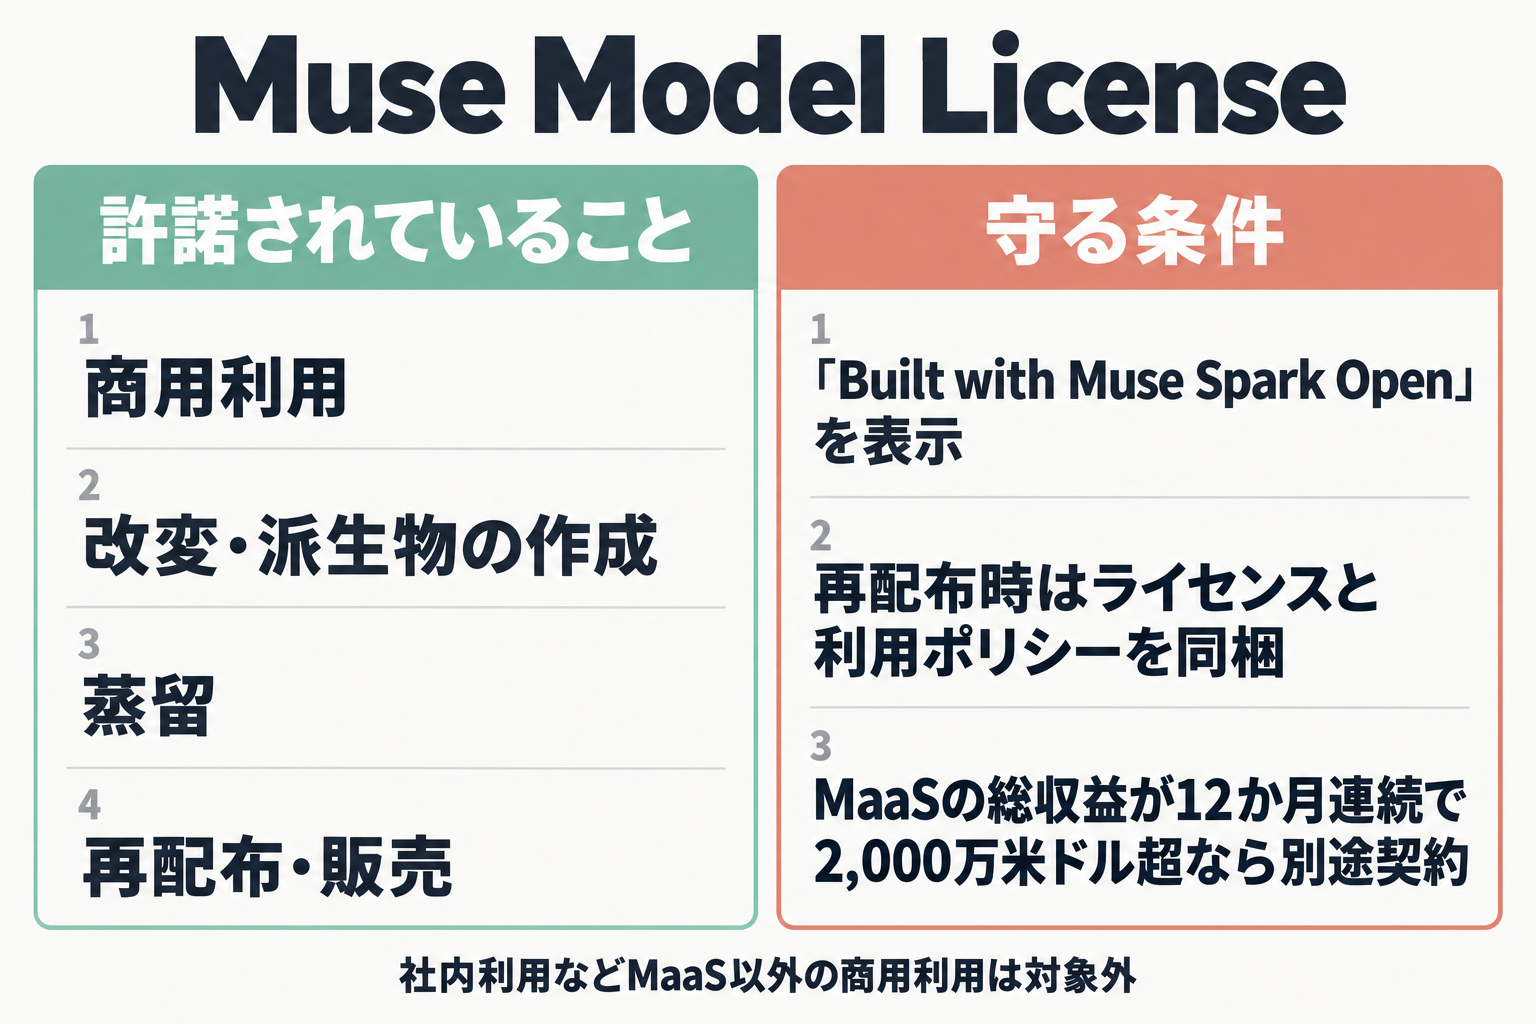
許諾されていること
- 商用利用
- 改変(ファインチューニングを含む)・派生物の作成
- 蒸留
- 再配布・販売
守る条件
- 製品やサービスのUIに「Built with Muse Spark Open」を目立つ形で表示する
- 再配布時はライセンスと利用ポリシーを同梱する
- 「Model as a Service」(モデルそのものをサービスとして他社に提供する事業)の総収益が連続12か月で2,000万米ドルを超える場合は、Metaへの通知と別途書面契約が必要。社内利用など、MaaS以外の商用利用は対象外
禁止用途(モデルカード) 違法行為、児童搾取、嫌がらせ・差別、無資格の専門業務、マルウェア作成、安全対策の回避、軍事・違法兵器、適切な保護のない重要インフラ運用、欺瞞目的などです。
別の話として: 無料の外部サービスには、入力が将来のモデルの学習に使われる条件を設けているものがあります。これはそのサービス側の条件で、Muse Spark Openのライセンスとは別物です。条件は変わりうるので、事業で使う前にライセンス本文を読み、不明点は法務の担当者に相談してください。
自分の環境で動かせる?必要メモリと判定表
公式が示すメモリの数値は次のとおりです。この間を補う換算値は作りません。
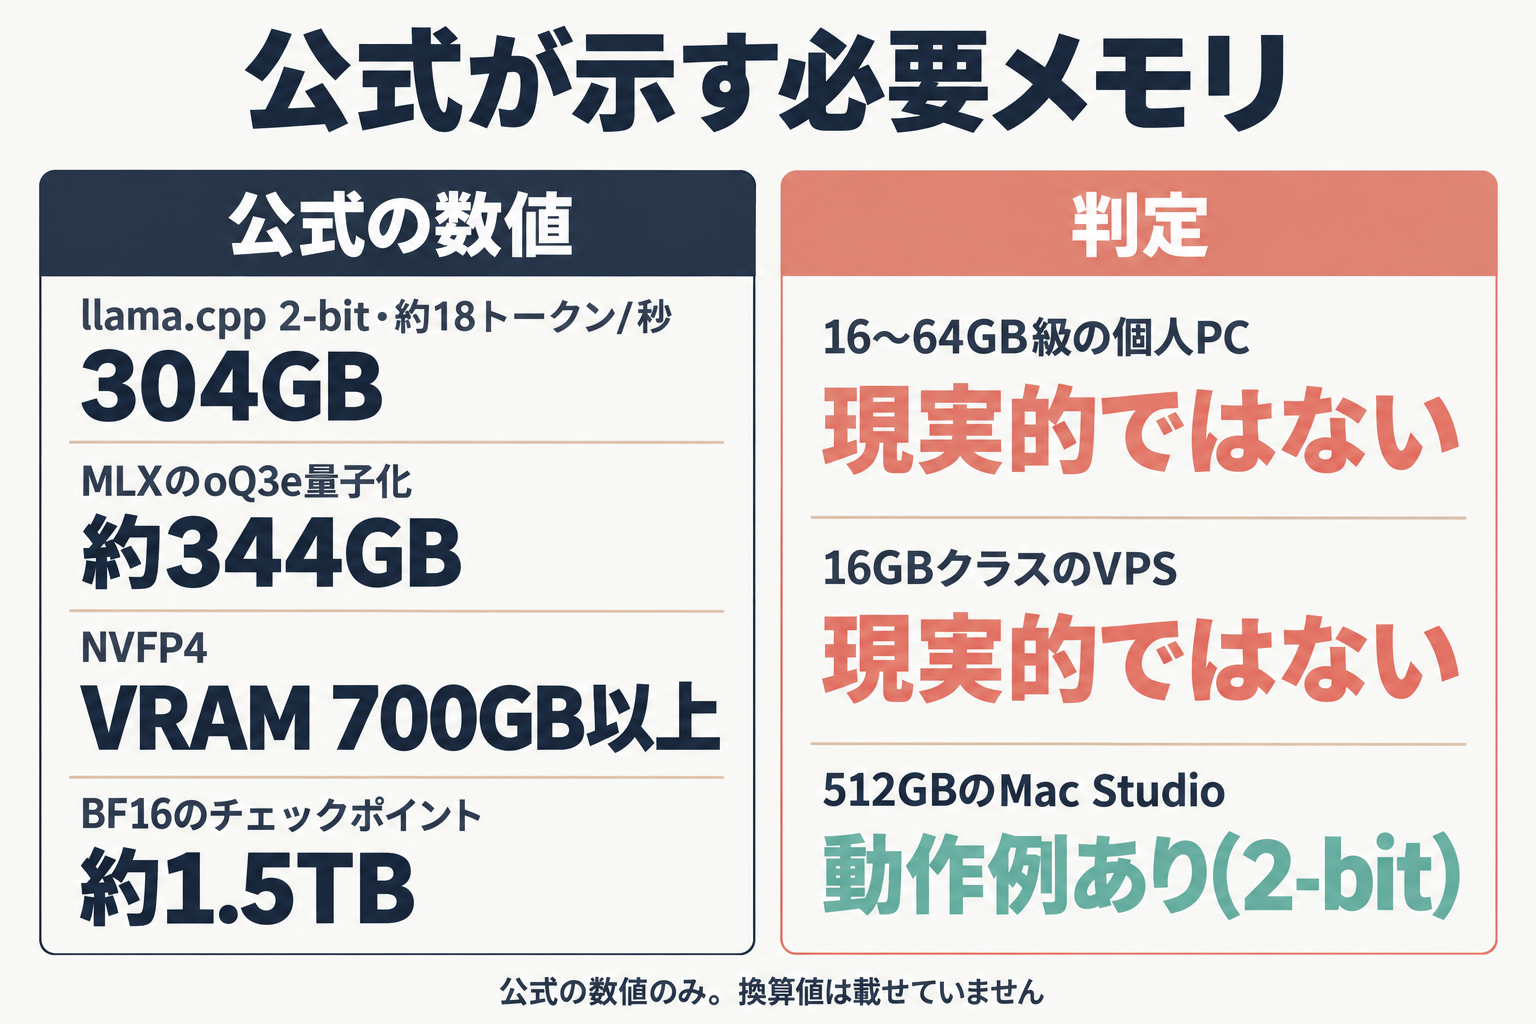
| 公式の数値 | 内容 |
|---|---|
| 304GB | llama.cppの2-bit(Q2_K)で、M3 Ultra(512GB)でテスト。約18トークン/秒 |
| 約344GB | MLXのoQ3e量子化 |
| VRAM 700GB以上 | NVFP4(モデルカード) |
| 約1.5TB | BF16のチェックポイント(safetensors)。モデルカードは2TBと記載 |
MLXの構成では、コンテキスト100万トークン(BF16)のKVキャッシュ(会話の記憶)だけで約266GBが必要とも書かれています。
判定表
| 環境 | 判定 | 根拠(公式の数値) |
|---|---|---|
| 一般的な個人PC(16〜64GB級) | 現実的ではない | 最小の動作例でも304GB |
| 16GBクラスのVPS | 現実的ではない | 304GBの約1/19しかない |
| 512GBのMac Studio(M3 Ultra) | 動作例あり(2-bit) | 304GBで約18トークン/秒の記載あり |
| GPUサーバー(NVFP4) | 推奨構成あり | B200のノード1台 |
| GPUサーバー(BF16) | 推奨構成あり(大規模) | H200×8のノードを4台(TP=32) |
MoEは「1トークンで動くのは42B」ですが、重みは816B全体を載せる前提です。公式の304GB〜1.5TBという数値がそれを示しています。「有効分が少ないから軽い」わけではない点に注意してください。
対応フレームワークはTransformers、llama.cpp、SGLang、vLLM、MLXです。モデルカードにはTensorRT-LLMとUnslothの記載もあります。
メモリと量子化の基本的な考え方は、VPSでOllamaを動かしたときのメモリ選びの記事にまとめています。
手元で動かせない場合の選び方
手元に512GB級のメモリがなければ、API経由で試すのが現実的です。 最小の動作例が512GB級のMacなので、大半の個人はこちらになります。
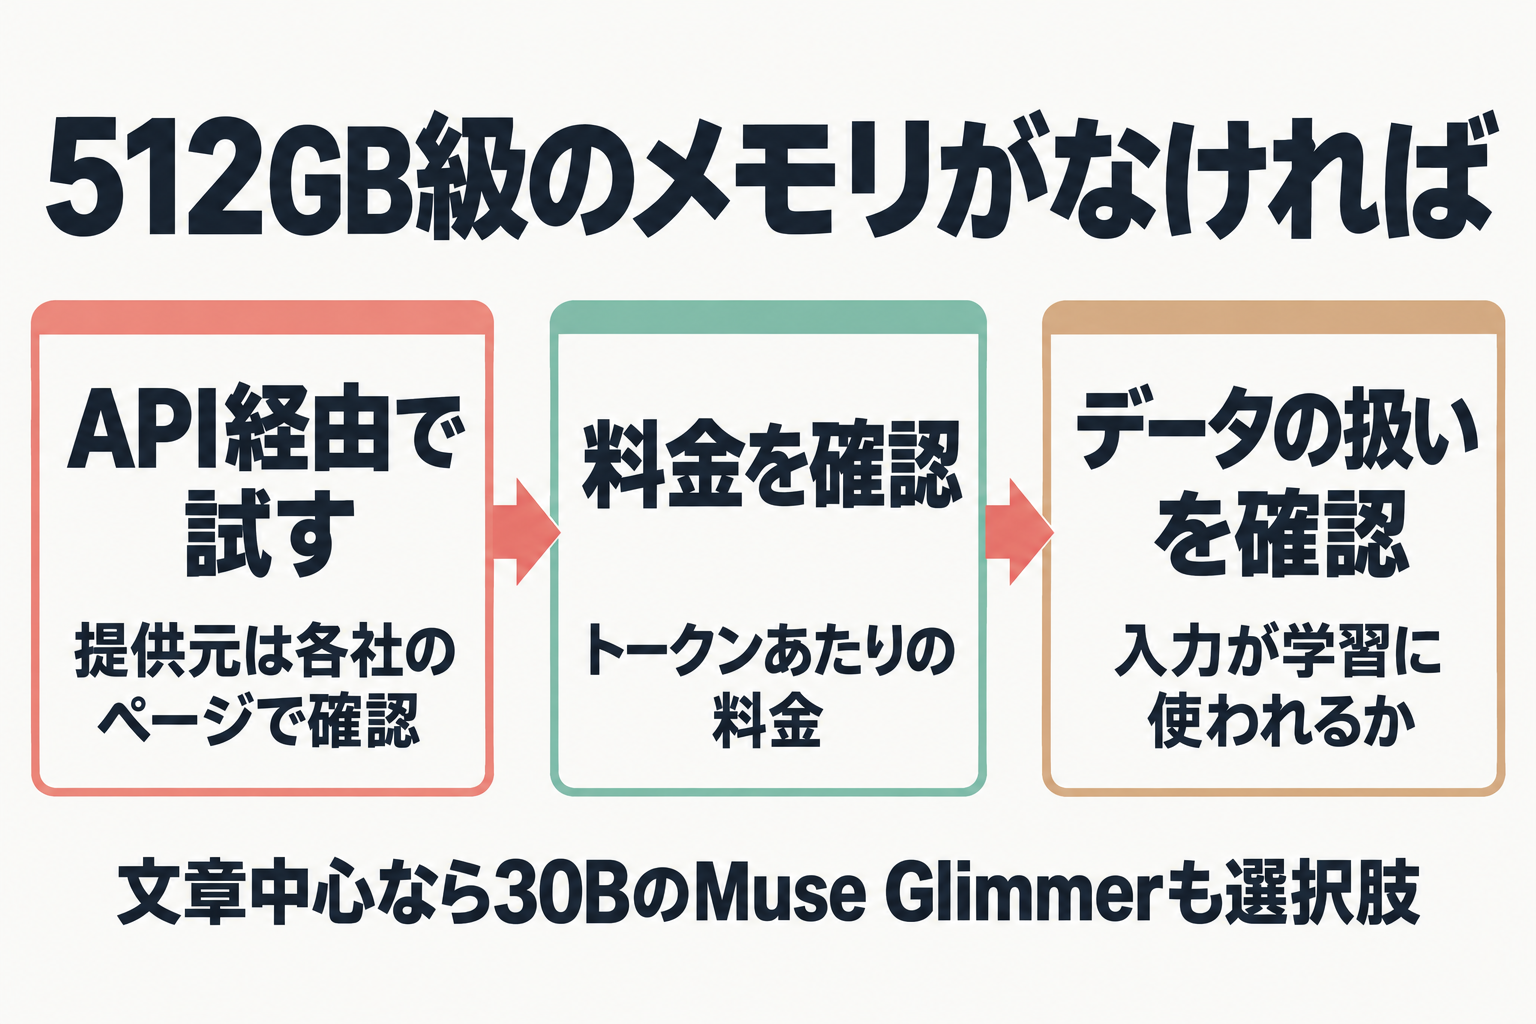
- API経由で使う: 報道では、Baseten・Fireworks・Groq・Together・OpenRouterなどでの提供が言及されています。これは報道ベースの情報です。Muse Spark Openを実際に扱っているか、どのモデル名で出ているかは、各社のページで調べてから選んでください。
- 料金とデータの扱いは各社で違います: 提供元と価格は、本記事では公式情報として示せません。使う場合は各社の料金ページで、トークンあたりの料金と、入力が学習に使われるかどうかの条件を確認してください。機密情報や顧客情報を入れる前に、データの扱いの条件を読むのが先です。
- 小さいモデルで足りるなら: 30BのMuse Glimmerが選択肢になります。単一GPUまたはMac向けと報じられています。文章中心の用途なら、こちらのほうが環境の負担は小さく済みます。
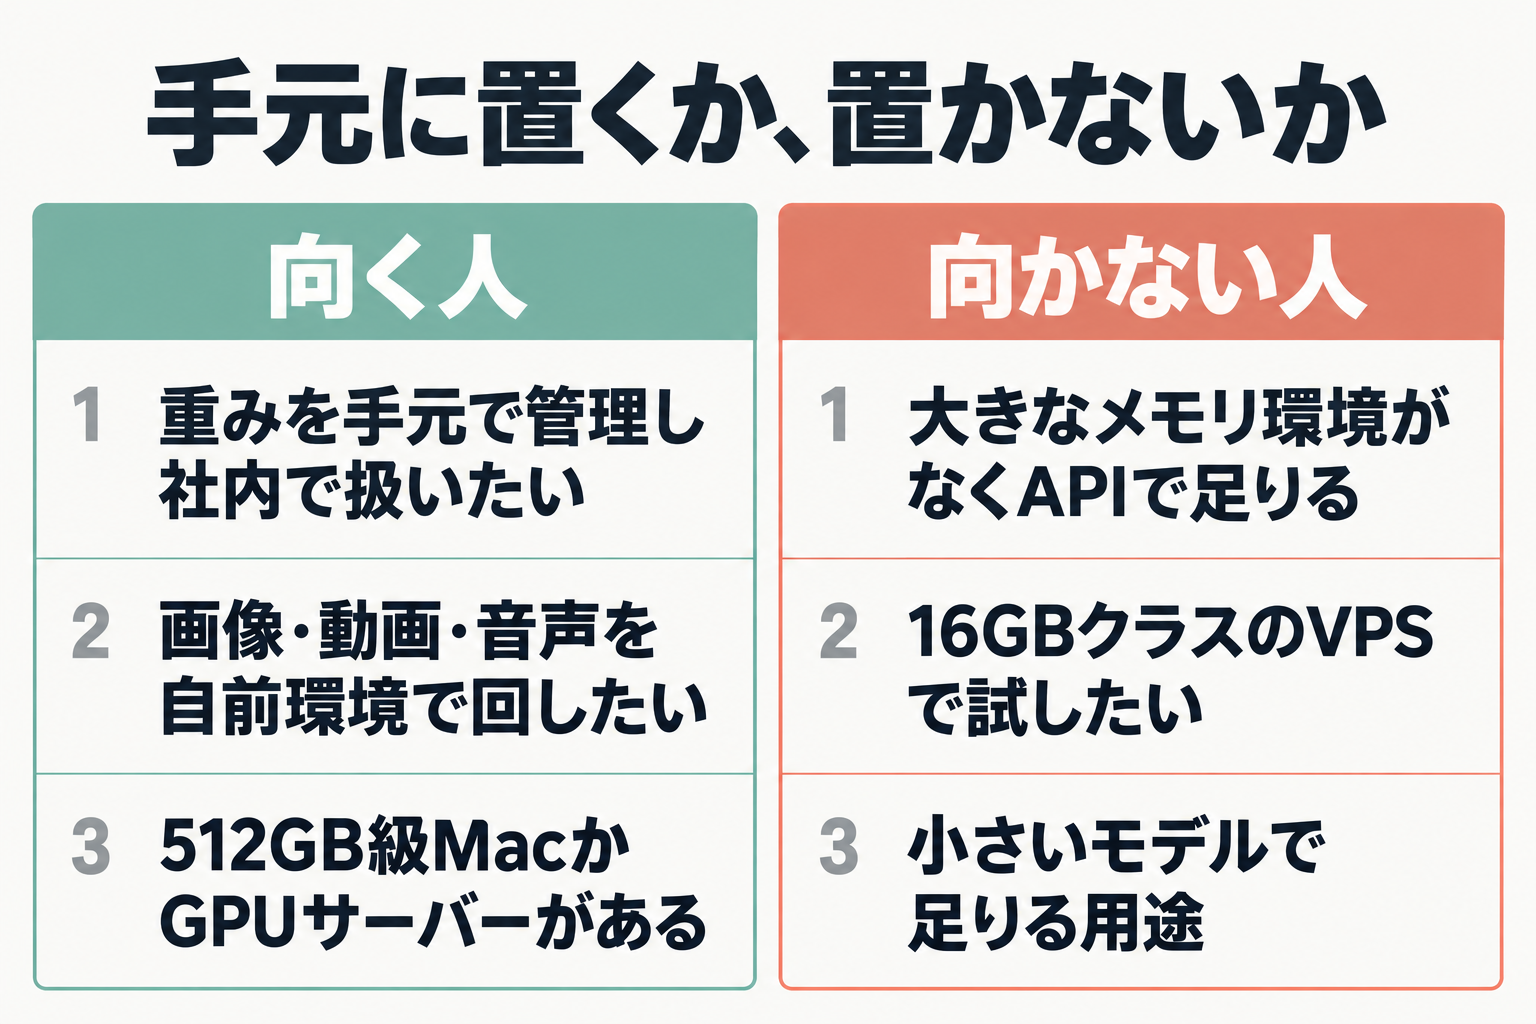
- 手元に置く意味があるのは: 重みを自分で管理したい、画像・動画・音声を自前環境で回したい人です。
手元に置くべき人、そうでない人
向く人
- 重みを手元で管理し、出力を社内で扱いたい人(社内利用はMaaS条件の対象外)
- 画像・動画・音声を含む処理を自前環境で回したい人
- 512GB級のMacやGPUサーバーをすでに持っている人
向かない人
- 手元に大きなメモリ環境がなく、APIで足りる人(上の節を参照)
- 16GBクラスのVPSで試したい人 — VPS開発環境の構築を検討する際も、まずこのセクションの判定表で環境要件を確認してください
- 小さいモデルで足りる用途の人
今日試す最初の一歩
やることは1つです。Hugging Faceのモデルページを開き、必要メモリとライセンスを読んで、自分の環境で動くかを判断します。重みは落とさず、まず条件を見るだけです。
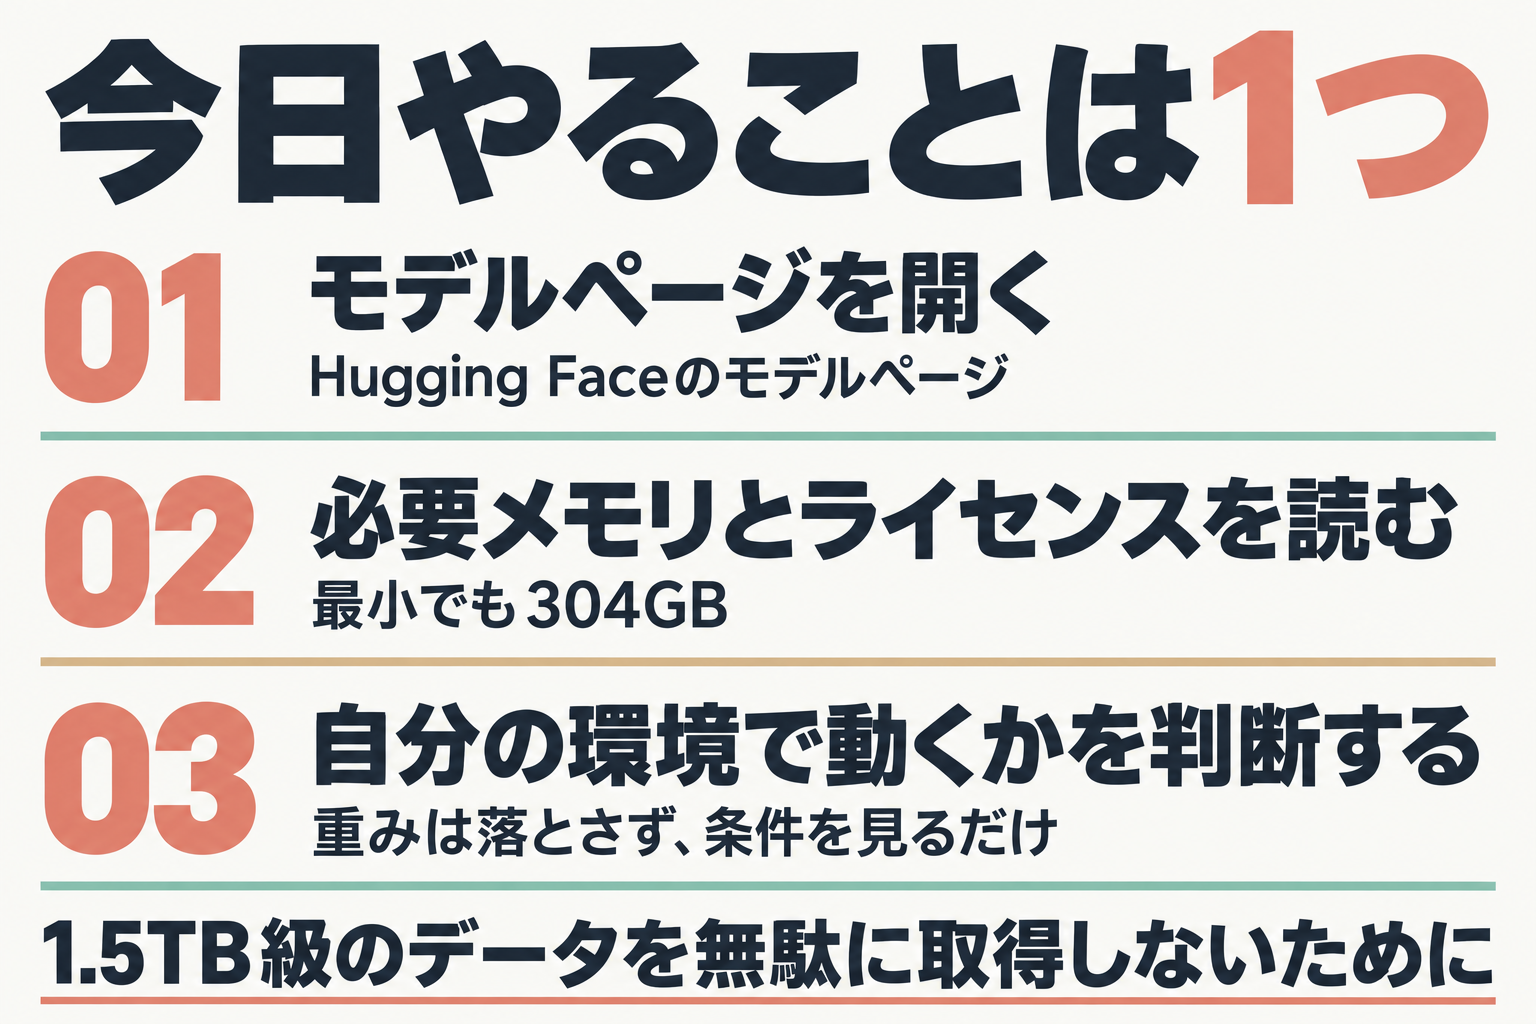
公式の数値では、最小の動作例が304GBで、ライセンスは商用利用を許諾しています。最小でも304GBが要るので、手元の環境で動かせるかを、モデルページの条件で先に確かめてください。ここで確かめておけば、1.5TB級のデータを無駄に取得せずに済みます。
2-bit版でも約304GBのメモリが要る。
公式のモデルページで必要メモリと条件を確認する(公式)確認の結果、512GB級のMacかGPUサーバーがあるなら、2-bit版から試すのが入口です。手元で動かせなければ、上で挙げたAPI経由で使う道に進んでください。その場合も、先に各社の料金とデータの扱いの条件を読んでからにしましょう。