Ollamaの公式モデル一覧は英語名がずらりと並ぶだけで、「結局どれが日本語で自然に受け答えするのか」には答えてくれません。この記事では、VPS向けの軽量な日本語対応Ollamaモデル4種に同じ質問を投げ、応答の自然さと速度を実際に比較しました。読み終えると、自分の用途とVPSのスペックに合ったモデルを選べるようになります。対象読者は、VPSにOllamaの環境はすでに作ったものの、どのモデルを入れるかで迷っている個人開発者です。大きなモデルの導入を前提にしている人や、GPU搭載マシンでの利用が前提の人には向きません。なお実測は、GPU搭載のローカルPCと、Dockerでメモリ・CPUを制限した環境(VPSプランに近い条件を再現したもの)で行っており、VPSの実機そのものでの計測ではありません。
迷ったらこれ:日本語チャット用途ならこのモデルから
汎用チャット用途で、VPSのメモリが2GB程度なら、まずqwen2.5:0.5b-instruct-q4_K_Mから試すのが最短です。
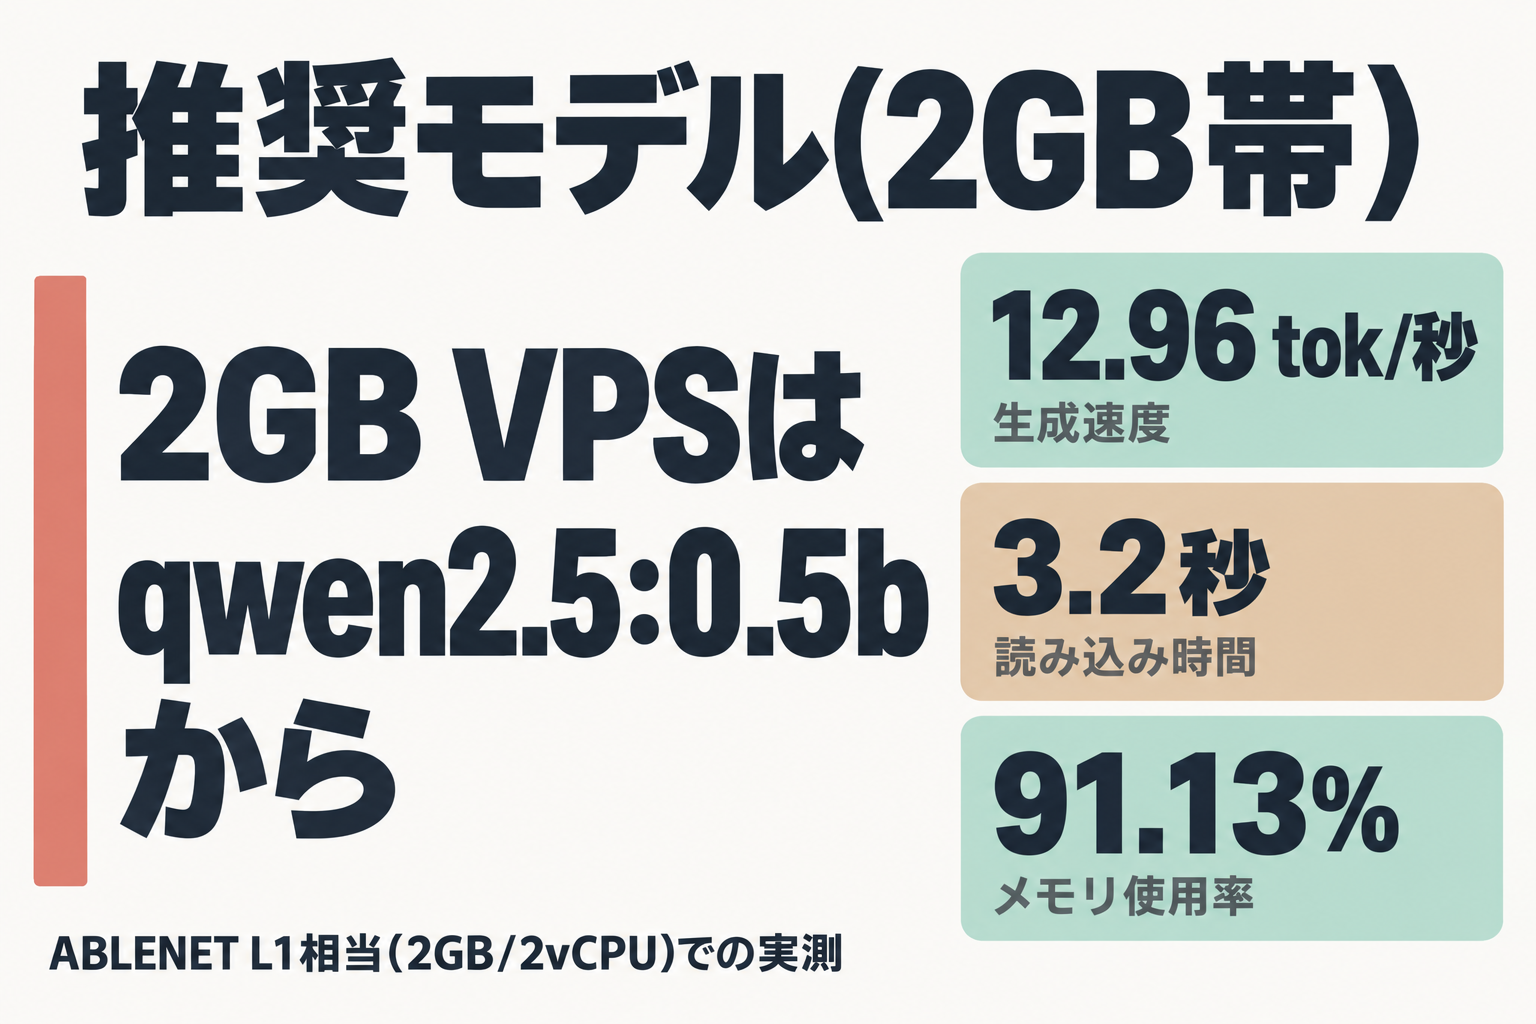
実測では、ABLENET VPSのL1プラン(月968円・2GB/2vCPU)相当のDockerコンテナで動かしたところ、生成速度は12.96 tokens/秒でした。同じ条件で1.5Bモデルを動かすとモデルの読み込みだけで118秒かかり、生成速度も3.34 tokens/秒まで落ち込んだのに対し、0.5Bまでサイズを落とすと応答が返ってくる体感が大きく変わりました。
向く人: 2GB/2vCPU程度のVPSで、まず動く実感を得たい人。向かない人: 訳語の正確さを最優先したい人(その場合は「日本語特化モデルは今も必要か」で触れる日本語特化モデルの検討をおすすめしますが、今回はCPU限定条件では未実測です)。
最初の5分でやること: VPSにSSHで入り、ollama pull qwen2.5:0.5b-instruct-q4_K_Mを実行してください。ダウンロードが終わったらollama run qwen2.5:0.5b-instruct-q4_K_Mで「VPSとは何かを日本語で3行以内で説明して」のような質問を投げ、応答速度を自分の目で確認するのが最短です。
検証条件を先に開示します
比較したのは、Ollama公式ライブラリ(2026-09-09時点)で日本語に対応する軽量モデルのうち、qwen2.5:1.5b-instruct-q4_K_M、gemma3:1b、llama3.2:1b-instruct-q4_K_M、日本語特化モデルとしてyuiseki/sarashina2.2:1b(以下Sarashina2.2:1b)の4つです。全モデルに同じプロンプト「あなたはVPS上で動くAIアシスタントです。初心者にもわかるように『VPSとは何か』を日本語で3行以内で説明してください。」を投げ、Ollama REST API(/api/generate)から返るJSONのeval_count(生成トークン数)とeval_duration(生成にかかった時間)から生成速度(tokens/秒)を算出しました。
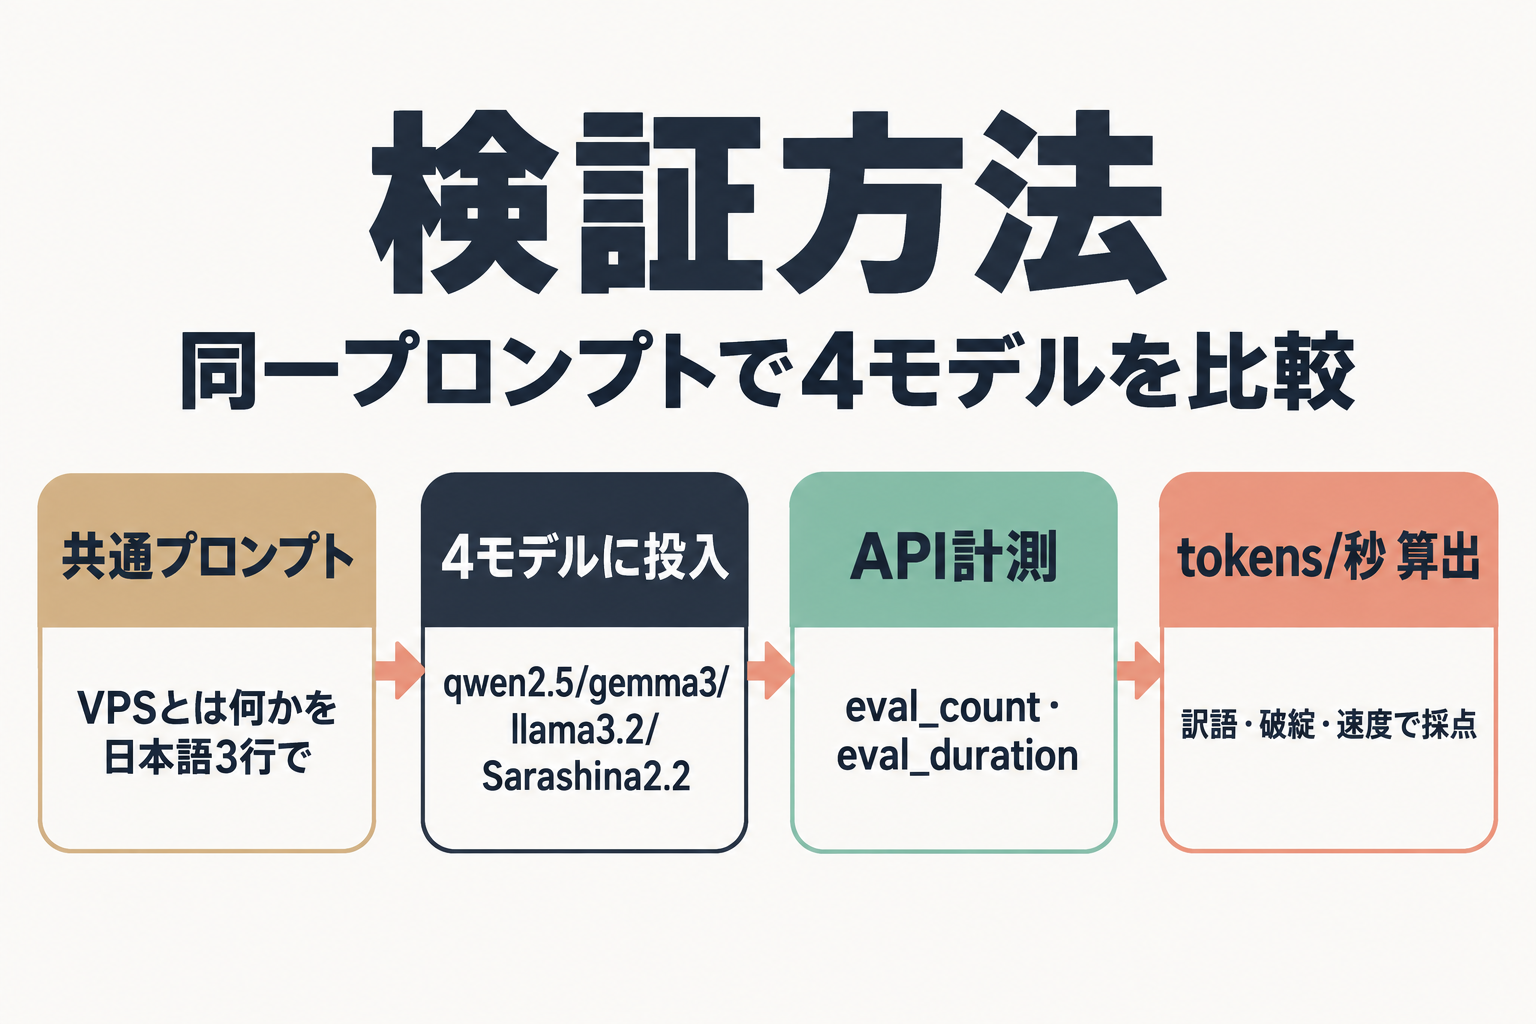
採点基準は「訳語が正確か」「文が破綻していないか」「速度」の3点です。ただし各モデル・各環境とも1回のみの実行結果(N=1)であり、統計的な有意差ではなく、1回の実行で観測された傾向として読んでください。
なお、Sarashina2.2:1bはSB Intuitions社が公開する原モデル(MITライセンス)を第三者がOllamaレジストリ用に変換配布したものです。公式配布ではない点に注意してください。
VPSでOllamaを動かす前提:GPUなし環境での注意点
ABLENET VPSのような一般的なVPSの多くはGPUを搭載していません。推論はCPUとメモリだけで行うことになり、「8GB VRAMあれば動く」といったGPU前提のスペック解説はそのままでは使えません。この記事ではVRAM要件は対象外とし、CPU/メモリでの実測に絞りました。
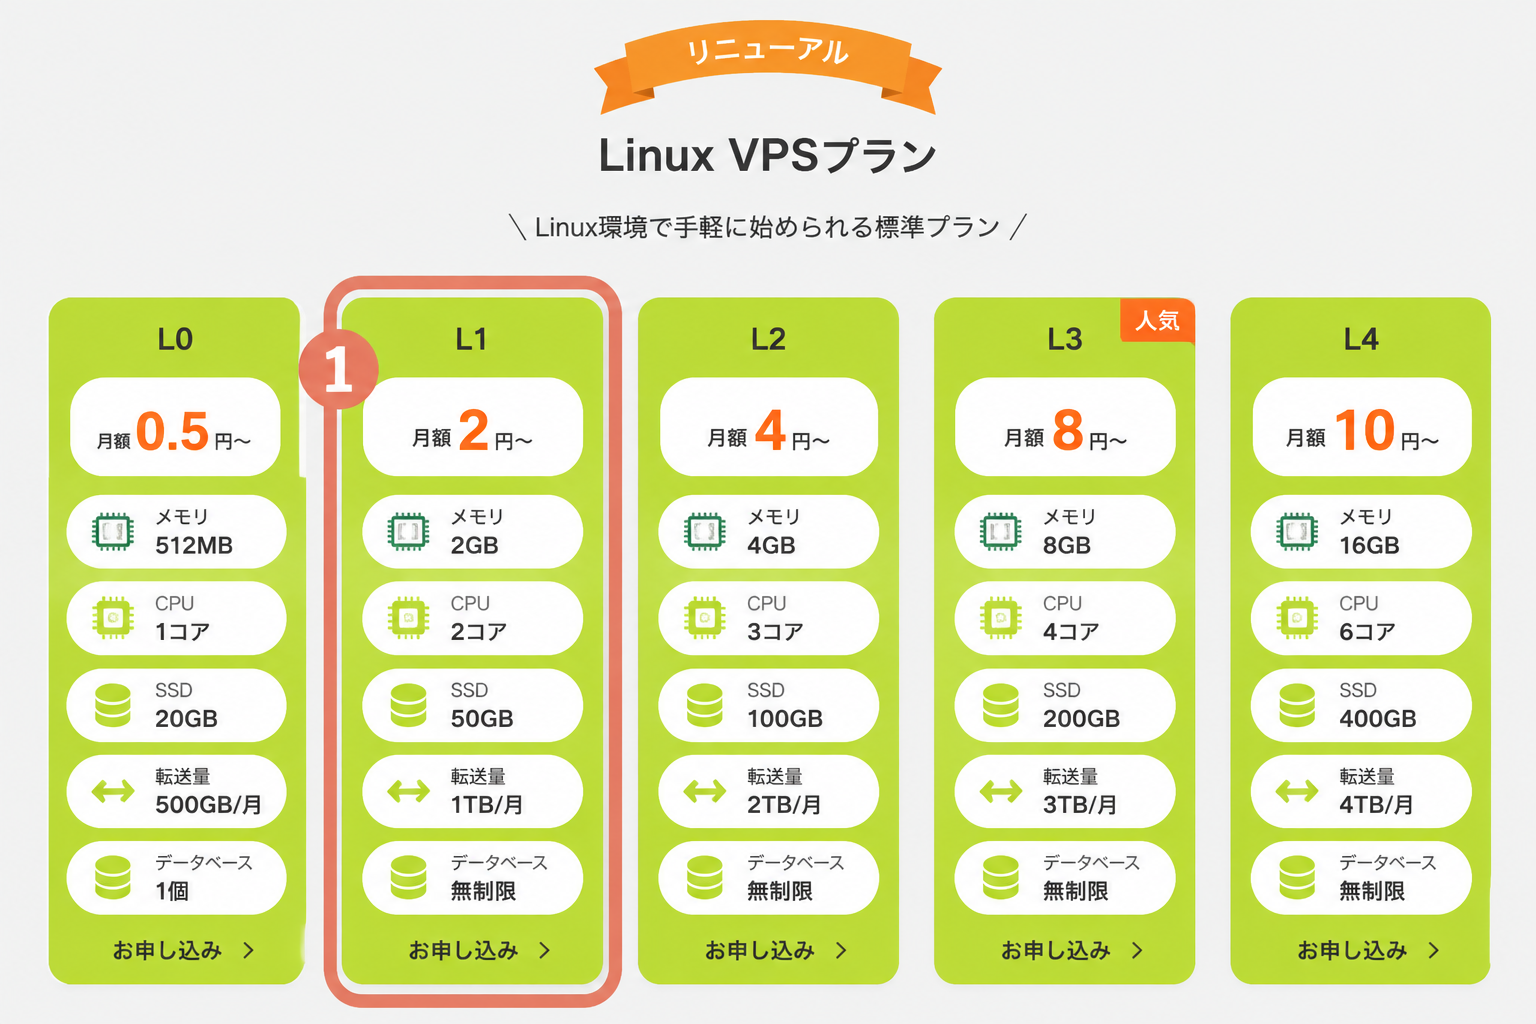
今回はDockerで--memory=2g --cpus=2と制限したコンテナを用意し、ABLENET VPSのL1プラン(月968円・2GB/2vCPU)相当の条件を再現しました。実機のVPSそのものでの計測ではなく、あくまで近似実測である点は先に断っておきます。
ABLENETのLinux VPSプランは次の通りです(2026-09-09確認、すべて最低利用期間なし・10日間無料お試しあり)。
| プラン | 月額(税込) | メモリ | vCPU | ストレージ |
|---|---|---|---|---|
| L0 | 554円(初期費用1,130円) | 0.5GB | 1 | 30GB |
| L1 | 968円(初期費用0円) | 2GB | 2 | 40GB |
| L2 | 1,536円 | 4GB | 3 | 80GB |
| L3 | 2,280円(コスパNo.1) | 8GB | 4 | 160GB |
| L4 | 2,850円 | 10GB | 5 | 200GB |
実測比較:モデル別の応答と速度
まずGPU搭載のローカルPCで、4モデルに共通プロンプトを投げた結果です。
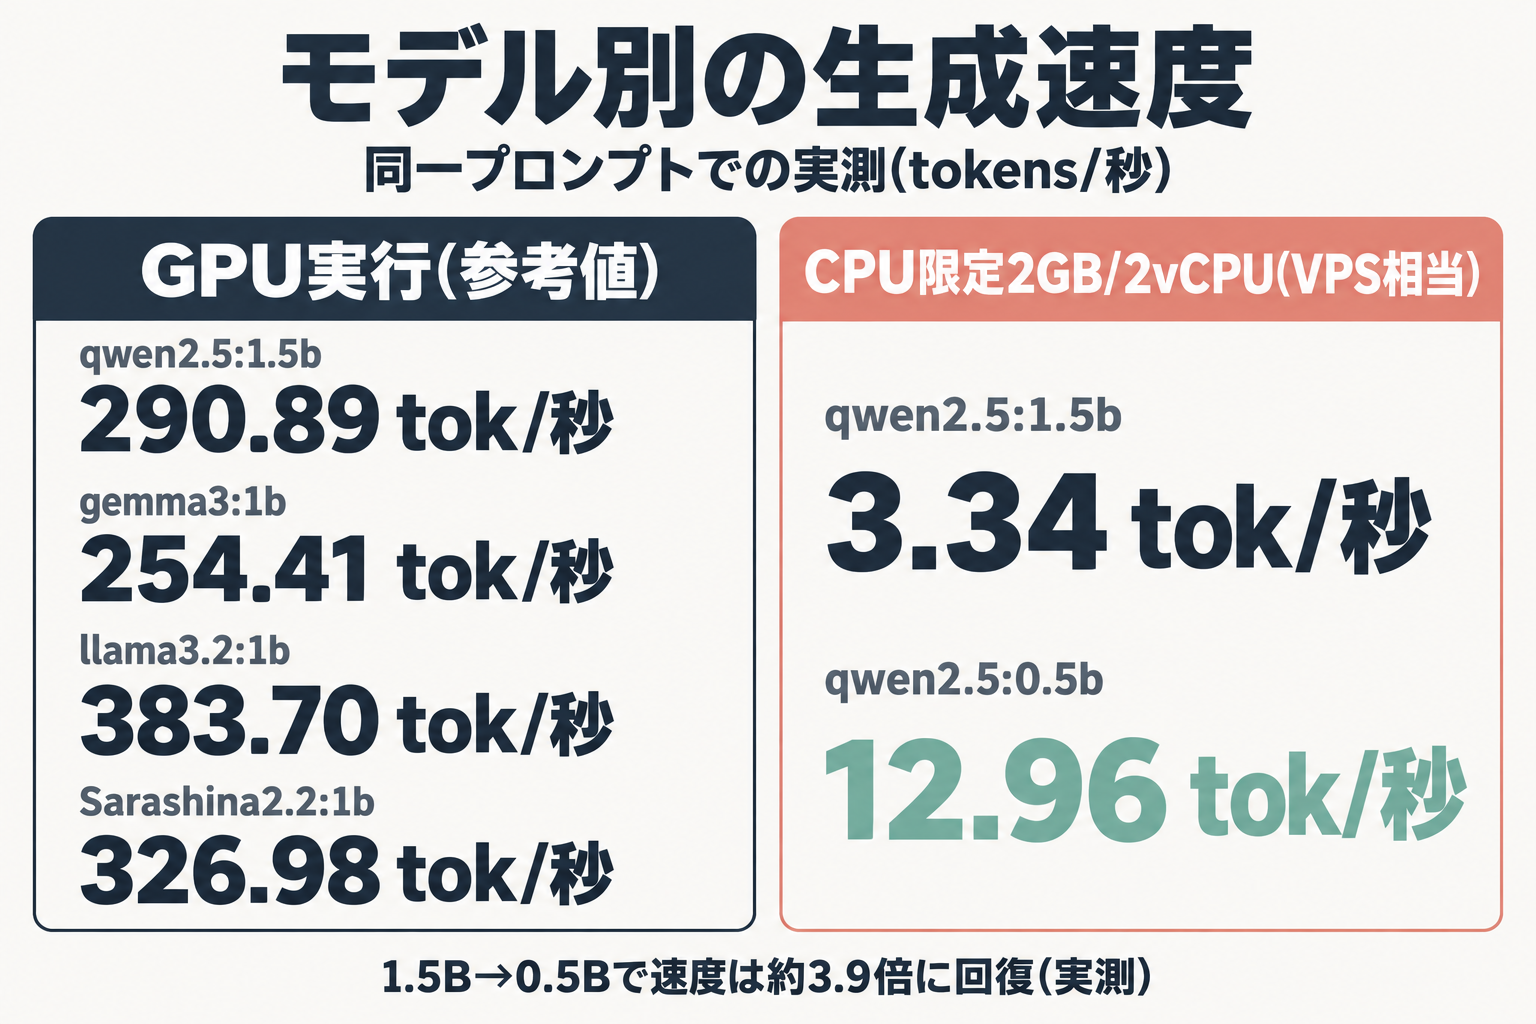
| モデル | tokens/秒 | 所感 |
|---|---|---|
| qwen2.5:1.5b-instruct-q4_K_M | 290.89 | 文法は破綻していないが、「お手数ですが、ご用件の情報を保存し」というビジネスメール的な定型句が唐突に混入 |
| gemma3:1b | 254.41 | 文体は自然だが、「変替型複数サーバー」という訳語の誤り(一般的な訳は「仮想専用サーバー」) |
| llama3.2:1b-instruct-q4_K_M | 383.70 | 「エンタープライゼル」「スパイアリングアプリケーション」など存在しない語が出現し文意が破綻。公式に日本語がサポート対象外であることと符合する結果 |
| Sarashina2.2:1b | 326.98 | 「仮想専用サーバー」と訳語は正確で説明も分かりやすいが、文中に英単語「yet」が唐突に混入 |
この速度はいずれもGPUで実行した数値で、VPSでの体感速度をそのまま表すものではありません。VPSに近い条件を確かめるため、qwen2.5の2サイズをDockerのCPU限定コンテナ(2GB/2vCPU)で再実行しました。
| モデル | 実行環境 | 読み込み時間 | 生成速度 | メモリ使用 |
|---|---|---|---|---|
| qwen2.5:1.5b-instruct-q4_K_M | CPU限定(2GB/2vCPU) | 118.57秒 | 3.34 tokens/秒 | 1.698GiB/2GiB(84.92%) |
| qwen2.5:0.5b-instruct-q4_K_M | CPU限定(2GB/2vCPU) | 3.197秒 | 12.96 tokens/秒 | 1.823GiB/2GiB(91.13%) |
同じ2GB/2vCPUの条件でも、モデルを1.5Bから0.5Bに落とすだけで生成速度は約3.9倍(3.34→12.96 tokens/秒)に回復し、読み込み時間も118秒から3秒程度まで短縮しました。GPU実行時の290.89 tokens/秒と比べると、1.5BモデルのCPU限定実行は約1/87まで落ち込んでいます。メモリ使用率は0.5Bでも91.13%とほぼ上限に張り付いており、2GBプランでは0.5B級が実用上の目安と考えられます。
gemma3:1b・llama3.2:1b・Sarashina2.2:1bのCPU限定実測は、今回の検証範囲では行っていません(未実測)。品質面ではSarashina2.2:1bが優勢でも、2GB/2vCPUでどの程度の速度になるかは今回のデータからは分かりません。
用途別の選び方
今回分かった範囲でまとめると、次のようになります。
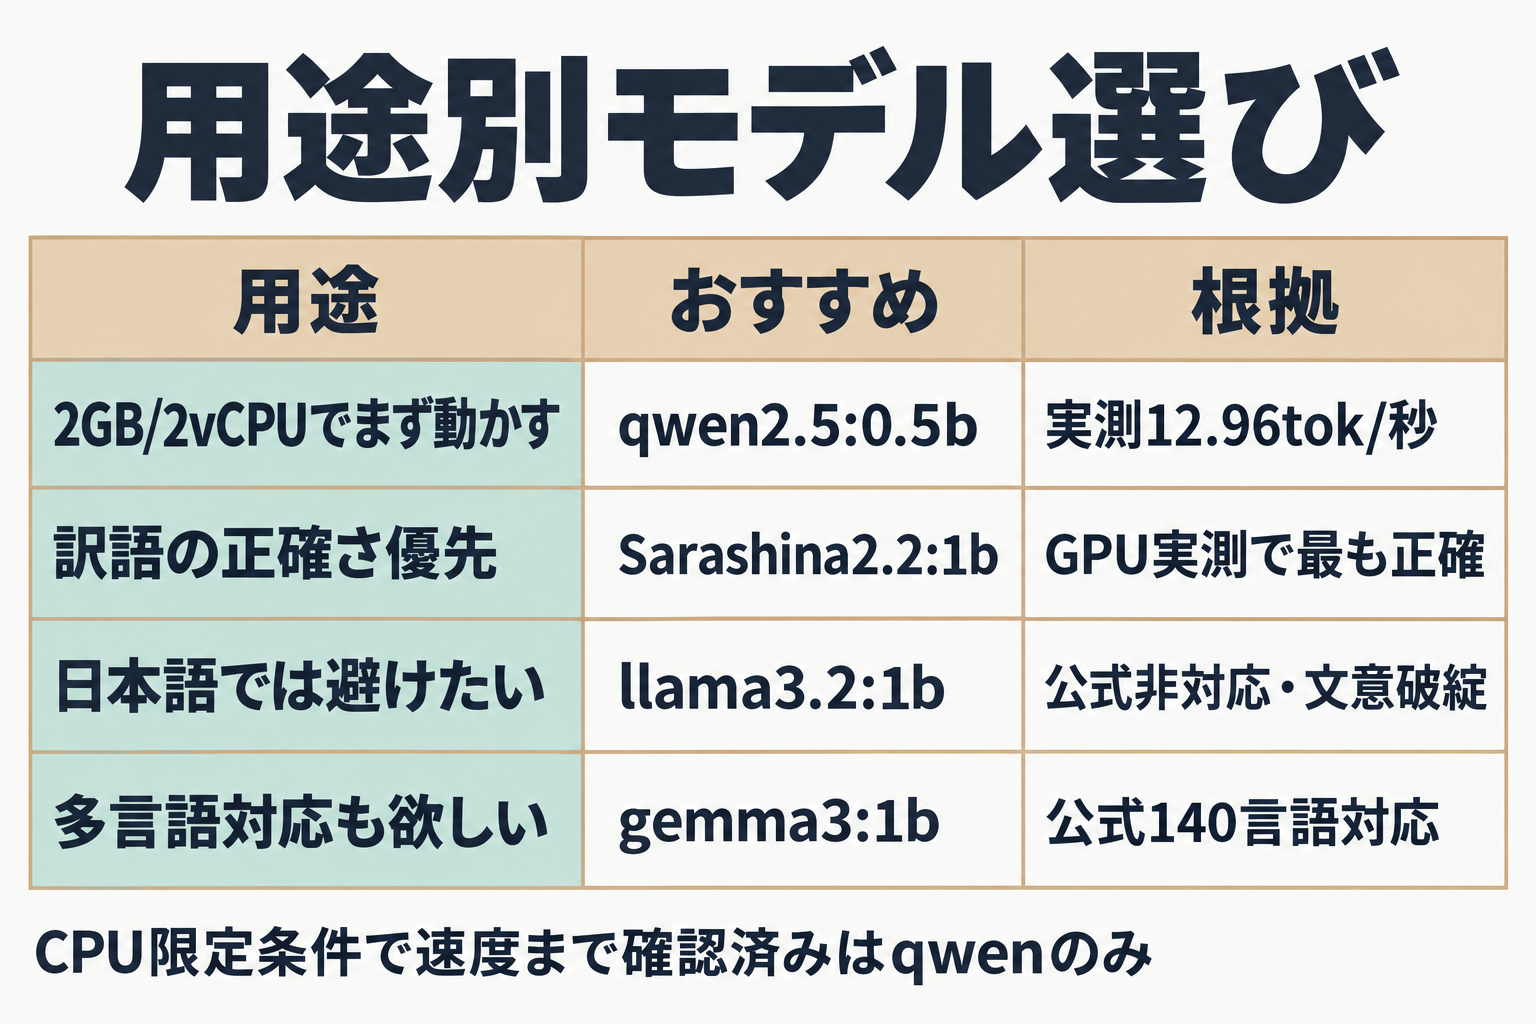
| 用途 | おすすめ | 根拠 |
|---|---|---|
| 2GB/2vCPU級VPSでまず動かしたい | qwen2.5:0.5b-instruct-q4_K_M | CPU限定実測で12.96 tokens/秒、動作を確認済み |
| 訳語の正確さを優先したい | Sarashina2.2:1b | GPU実測で訳語がもっとも正確。ただしCPU限定は未実測 |
| 日本語用途では避けたい | llama3.2:1b | 公式に日本語がサポート対象外。実測でも文意が破綻 |
| 多言語対応も欲しい | gemma3:1b | 公式に140言語対応と記載。GPU実測では文体は自然。CPU限定は未実測 |
CPU限定条件で速度まで確認できているのはqwen2.5のみです。他のモデルを試す場合は、まず小さいサイズから自分のVPSで実際に動かして確認することをおすすめします。なお、コーディング用途やマルチモーダル(画像入力)用途のモデルは今回の実測対象に含めていません。用途がチャット・要約以外の場合は、今回の結果をそのまま当てはめず別途確認してください。
日本語特化モデルは今も必要か
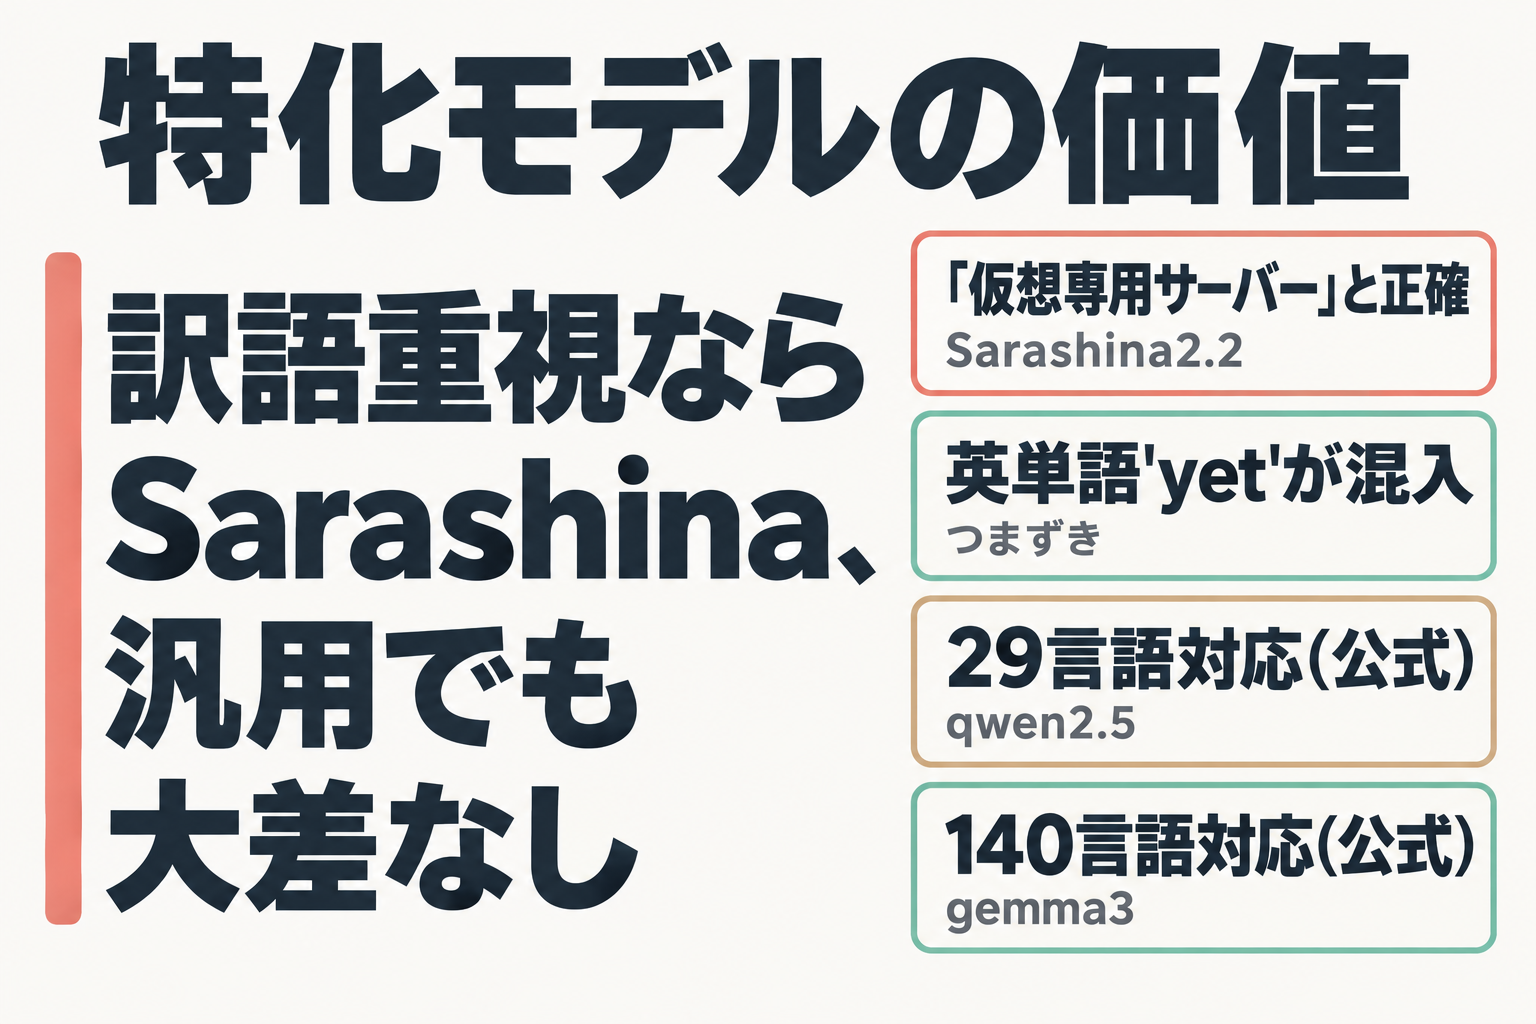
Sarashina2.2:1b(SB Intuitions開発、MITライセンス)は、今回の実測で唯一「仮想専用サーバー」という訳語を正確に使えたモデルでした。ただし文中に英単語「yet」が唐突に混じるつまずきもあり、完全に上位互換とは言えません。
ELYZA・Swallowといった代表的な日本語特化モデルは、公開されている最軽量版でも数GB級(ELYZAの最軽量公開モデルは8B)のため、今回の検証範囲では実測できませんでした。代わりに、より軽量な日本語特化モデルとしてSarashina2.2:1bで検証しています。
qwen2.5やgemma3のような汎用モデルも日本語対応をうたっており(qwen2.5は29言語、gemma3は140言語対応と公式に記載)、実測でも文法が破綻するほどの差はついていません。日本語特化モデルが必要かどうかは、「訳語の細かな正確さ」をどこまで求めるか次第、というのが実測からの所感です。
必要メモリの目安とライセンス
商用利用を考える場合はライセンスも確認しておく必要があります。
| モデル | 提供元 | ライセンス | 商用利用 |
|---|---|---|---|
| qwen2.5:0.5b/1.5b | Alibaba | Apache 2.0 | 制限なし |
| gemma3:1b | Gemma Terms of Use | 禁止用途ポリシーの遵守・利用規約の告知義務あり | |
| llama3.2:1b | Meta | Llama 3.2 Community License | 月間アクティブユーザー7億人超の事業者は別途許諾要 |
| Sarashina2.2:1b(原モデル) | SB Intuitions | MIT | 制限なし |
メモリの目安は、実測の通り2GB/2vCPU(ABLENET L1相当)では0.5B級で使用率91.13%、1.5B級で84.92%でした。数値上は1.5Bの方が余裕があるように見えますが、生成速度は0.5Bの方が大きく上回ります(3.34→12.96 tokens/秒)。より大きなモデルや快適な速度を求める場合はABLENET L2(4GB/3vCPU・月1,536円)以上のプランでの検証が必要ですが、今回は2GB帯のみの実測にとどまります。
VPSプランの選択で迷う場合は、こちらの記事で複数社のプランを料金別・性能別に比較しています。
VPSのメモリ選びをさらに詳しく知りたい方は、Ollamaのモデル別メモリ要件を整理したこちらの記事も参考にしてください。
よくある失敗トップ3
-
軽量モデルで日本語が崩れる: 今回のllama3.2:1bのように、公式に日本語サポート対象外のモデルを選ぶと「エンタープライゼル」のような存在しない語が出現することがあります。モデルページで対応言語に日本語が明記されているか確認してから選ぶのが安全です。
-
メモリ不足で極端に遅くなる: 実測の通り、2GB/2vCPUで1.5Bモデルを動かすと読み込みだけで118秒かかりました。VPSのメモリに対してモデルが大きすぎると、動くには動いても実用に耐えない速度になります。
-
量子化(モデルを軽量化する圧縮処理)の違いを混同する: 同じモデル名でも「q4_K_M」のような量子化の種類によってファイルサイズと速度が変わります。今回はq4_K_M系で揃えて比較しましたが、量子化レベルが違うモデル同士を比べると速度差の原因を取り違えやすいので注意してください。
次の一歩
今日やることは1つです。VPSに入ってollama pull qwen2.5:0.5b-instruct-q4_K_Mを実行し、今回と同じ質問を投げてみてください。
実測では、ABLENET VPSのL1プラン(月968円・2GB/2vCPU)相当の条件で12.96 tokens/秒の生成速度が確認できました。これから2GB級のVPSを用意するなら、ABLENET VPSのL1プランはこの条件に近く、まず試す環境として十分なスペックです。VPS選びの詳細については、こちらの記事で料金別・用途別のVPS比較も参考にしてください。
もっと詳しく
量子化レベルについて: 日本語特化モデルのSarashina2.2:1bは、コミュニティによるGGUF量子化版でQ4_K_Mが約2.07GB、Q3_K_Mが約1.69GBというサイズが公開されています。量子化を下げるほどファイルは小さくなりますが、応答品質への影響は今回検証していません。
今回実測していない範囲: gemma3:1b・llama3.2:1b・Sarashina2.2:1bのCPU限定(VPS相当)実測、4GB以上のVPSプランでの実測、ELYZA・Swallowの実測は今回の検証範囲に含まれていません。また各モデルの実行はいずれも1回のみ(N=1)のため、数値は傾向として参考にしてください。
Ollamaの既定設定: Ollama公式ドキュメント(2026-09-09確認)によれば、既定のコンテキスト長は4096トークン、Flash Attentionは対応環境であれば自動的に使用されます。環境変数OLLAMA_CONTEXT_LENGTHやOLLAMA_FLASH_ATTENTIONで明示的に指定することも可能です。ただしこの既定値はOllamaのバージョンによって変わることがあるため、導入時は自分の環境のollama --versionとその時点の公式ドキュメントで確認することをおすすめします。
実測環境について: 今回の実測はローカルのGPU搭載PCと、Dockerでメモリ・CPUを制限したコンテナによる近似実測です。ABLENET VPSの実機そのものでの計測ではないため、実際のVPS上の挙動を完全に保証するものではありません。