米Continuum AIが開発し、FlashLabs株式会社が日本市場向けに独占提供するAI推論ゲートウェイ「OrcaRouter」の研究チームが、27B級のエージェント向けAIモデル「OrcaSAQ-2 27B」を公開しました(2026年9月24日)。元のモデル(54GB)を12.3GBまで圧縮しながら、判断の一致率93.2%を保ったと公式は説明しています。個人のGPU環境やVPSでどこまで動かせるモデルなのか、公式発表の記載をもとに整理しました。
数値・仕様は公式リリースとHugging Faceのモデルページの記載に基づきます。実機でのモデル起動やベンチマーク計測は行っていません。
つまり何が起きたか
OrcaSAQ-2 27Bは、270億パラメータ(27B)規模のAIモデルを、性能をできるだけ保ったまま軽量化(圧縮)した「エージェント向け」のモデルです。「エージェント向け」とは、AIが自分で計画を立て、ツールを実行し、結果を見て次の判断をする——という一連の作業を任せられるように調整されたモデルを指します。
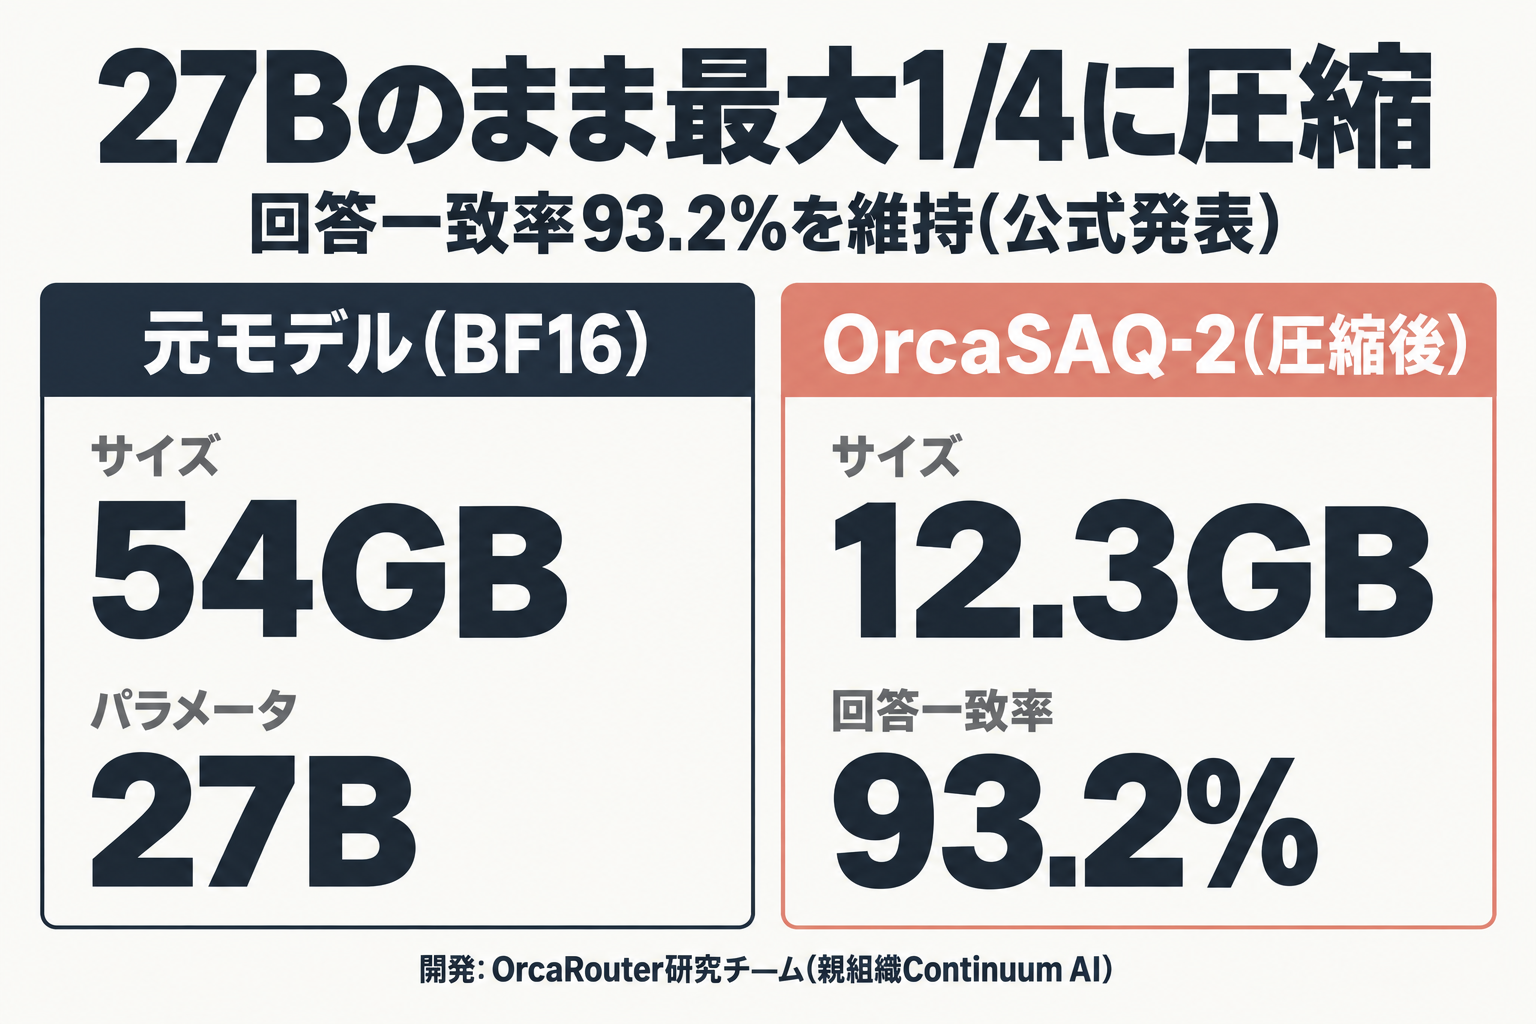
公式発表によれば、元のモデル(BF16形式・54GB)を12.3GBまで圧縮し、ファイルサイズを約4分の1以下(ストレージ換算で77.2%削減)にしています。圧縮前のモデルと比べた回答の一致率は93.2%、文章の自然さを示す指標(パープレキシティ)の差はわずか0.02%と公式は説明しています。
開発したのはOrcaRouterの研究チーム(親組織はAI研究機関のContinuum AI)で、日本国内での提供はFlashLabs株式会社が担っています。ライセンスはApache-2.0で、Hugging Faceで重みが公開されています。
迷ったらこれ
結論から先に書きます。OrcaSAQ-2 27Bを動かすには16GBのGPUが前提で、CPUだけの一般的なVPSでは想定されていません。
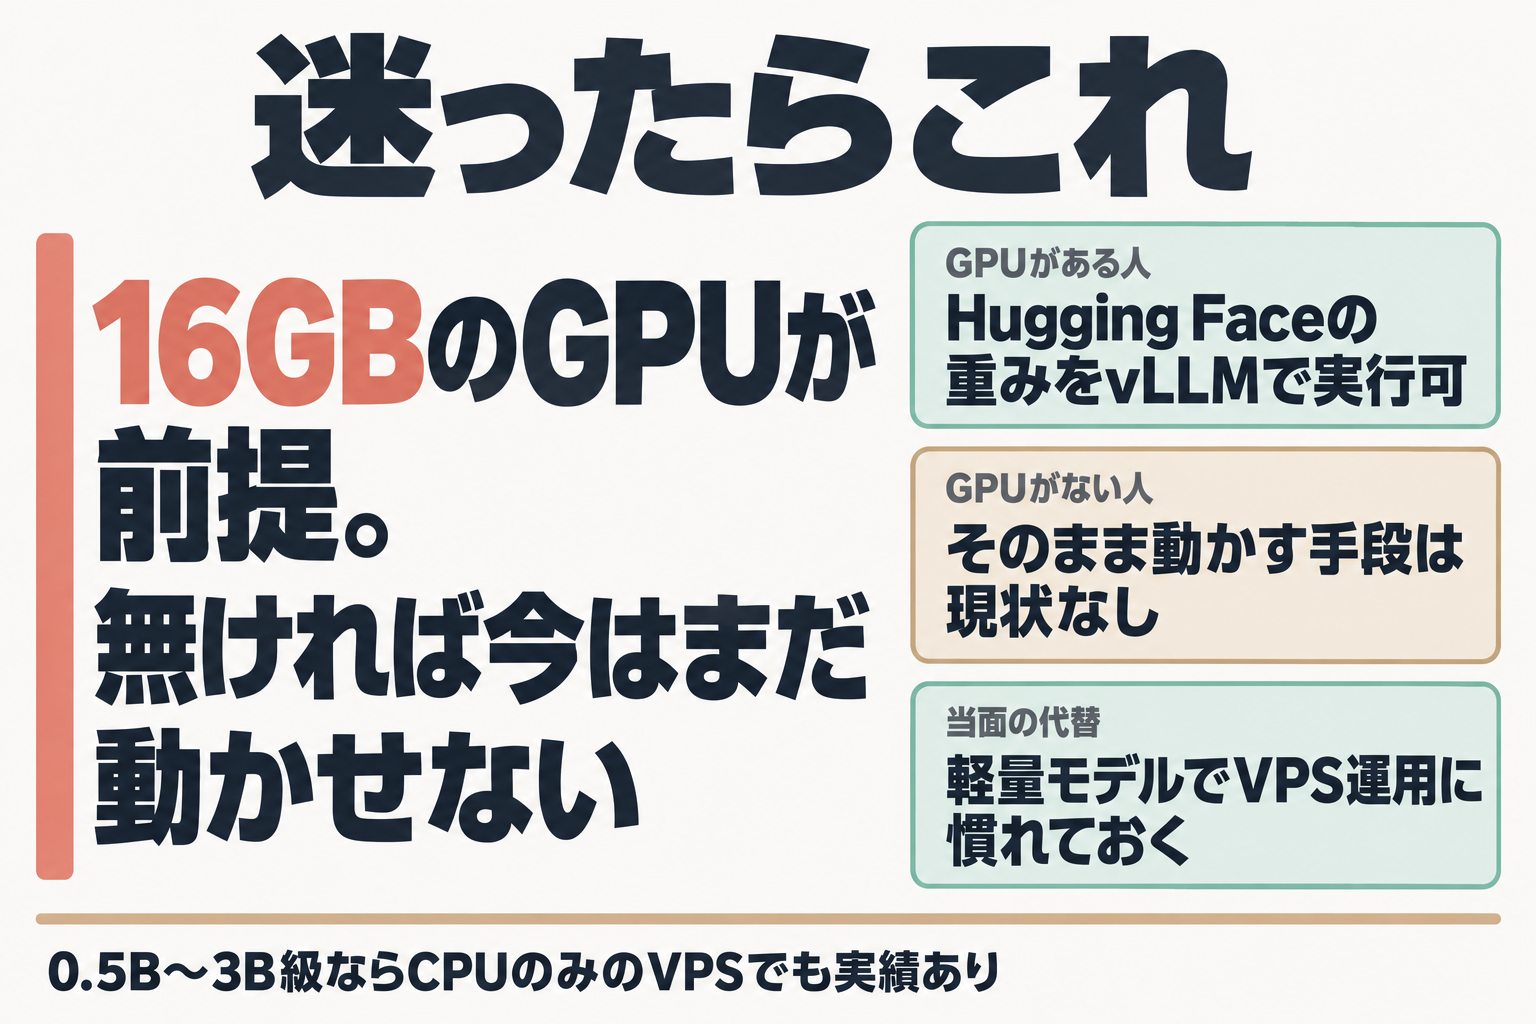
- 16GB以上のGPU環境をすでに持っている人: Hugging Faceで公開されている重み(
orcarouter/OrcaSAQ-2-27B)を、vLLM+OrcaSAQ2対応の連携で動かせば、公式発表の速度・コンテキスト長で試せます。 - GPU環境を持っていない・VPSで完結させたい人: OrcaSAQ-2をそのまま動かす手段は、今のところありません(後述)。まずは軽量なモデルでVPS環境に慣れておき、GPU対応の選択肢が広がったタイミングで乗り換えるのが現実的です。
軽量モデルでのVPS実測は、VPS Ollama実測|メモリ選びと外部公開にまとめています。0.5B〜3B級ならCPUのみのVPSでも動作実績がありますが、27B級・GPU前提のOrcaSAQ-2とは規模が2桁以上違うため、そのままの延長で判断はできません。
これまで(Before)→ いま(After)
Before: 27B級のエージェント向けモデルは、元の形式で54GBのメモリを必要とし、手元のGPUや1台のVPS・サーバーで動かすには大きすぎるという課題がありました。実際にweeveeで実測した範囲でも、CPUのみのVPSで安定して動くのは3B級まで(4GBプラン)で、7B以上は検証できていません。
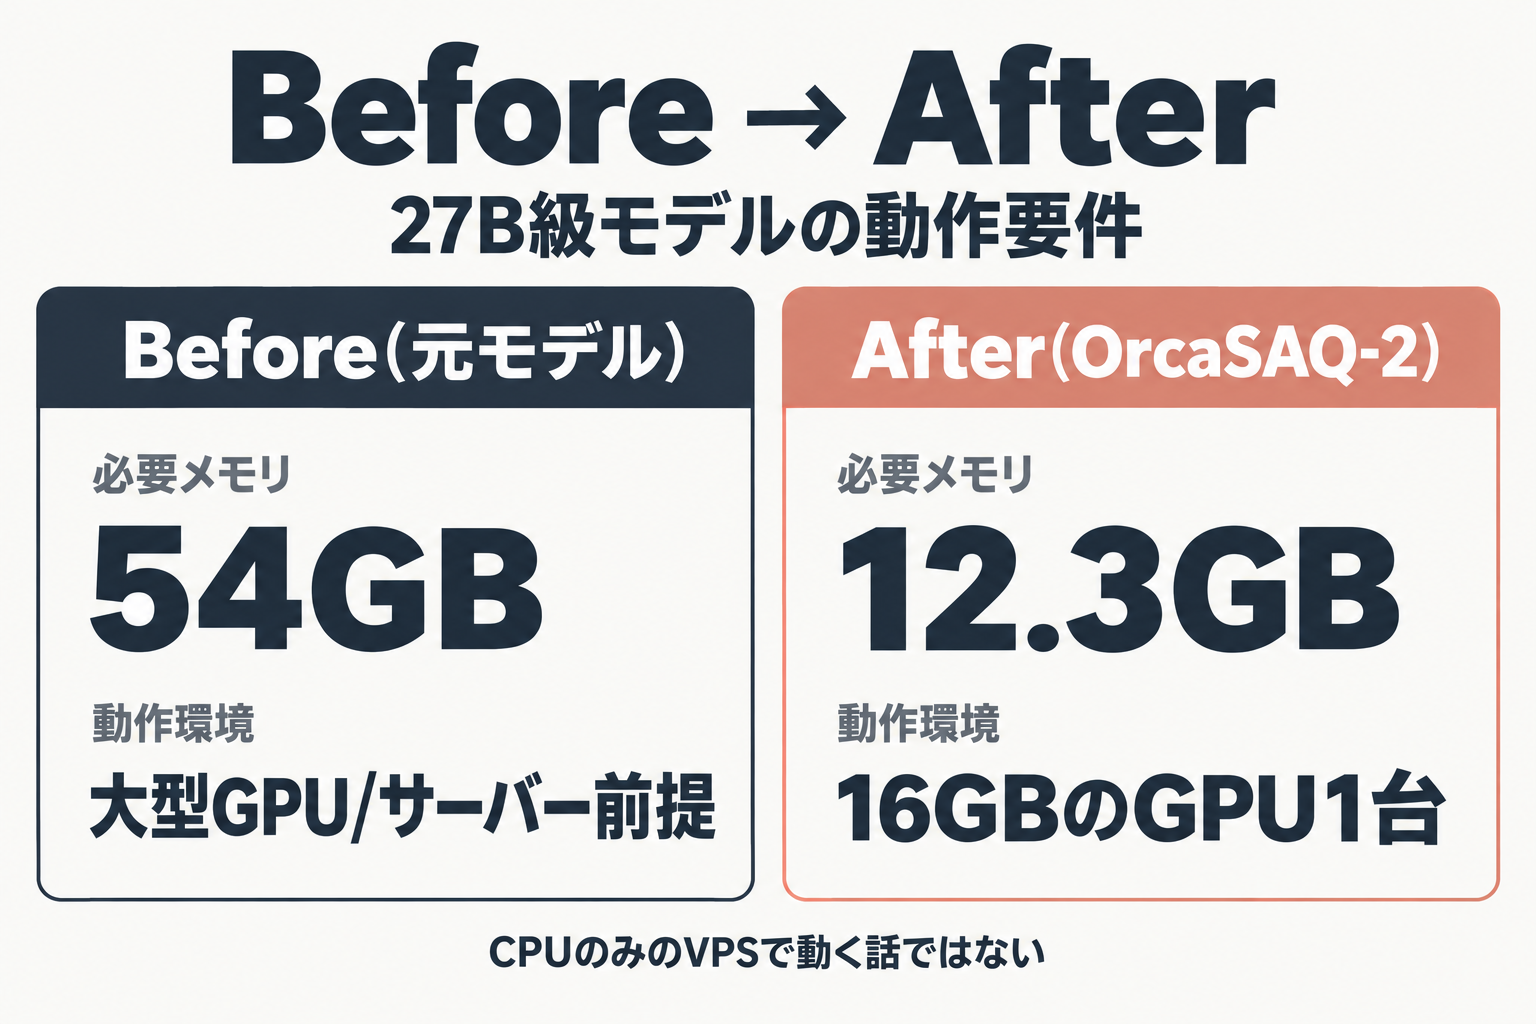
After: 公式発表によれば、OrcaSAQ-2 27Bは同じ27B規模のパラメータのまま、重みを12.3GBまで圧縮しました。16GBのGPUに収まるサイズになったことで、「1台のGPU搭載環境で動かす」という選択肢自体は現実的になっています。ただし前述の通り、これはCPUのみのVPSで動く話ではなく、GPUを搭載した環境が前提です。圧縮方式そのものの技術的な中身(量子化手法や精度配分の詳細)は、公式リリースの時点では非公開とされています。
圧縮の中身とベンチマーク数値(公式発表の範囲)
公式発表が明記しているのは、「モデルの各部分が圧縮の影響を受けやすいかどうかを見極め、精度の配分を変える独自の混合精度圧縮方式(OrcaSAQ2)」という説明までです。重み1つあたりの平均は3.21ビットで、影響の大きい部分に情報量を多く配分しているとされていますが、具体的な量子化手法・調整方法・パッキング方式は「現時点で非公開」と明記されており、これ以上の技術的な内訳は分かりません。
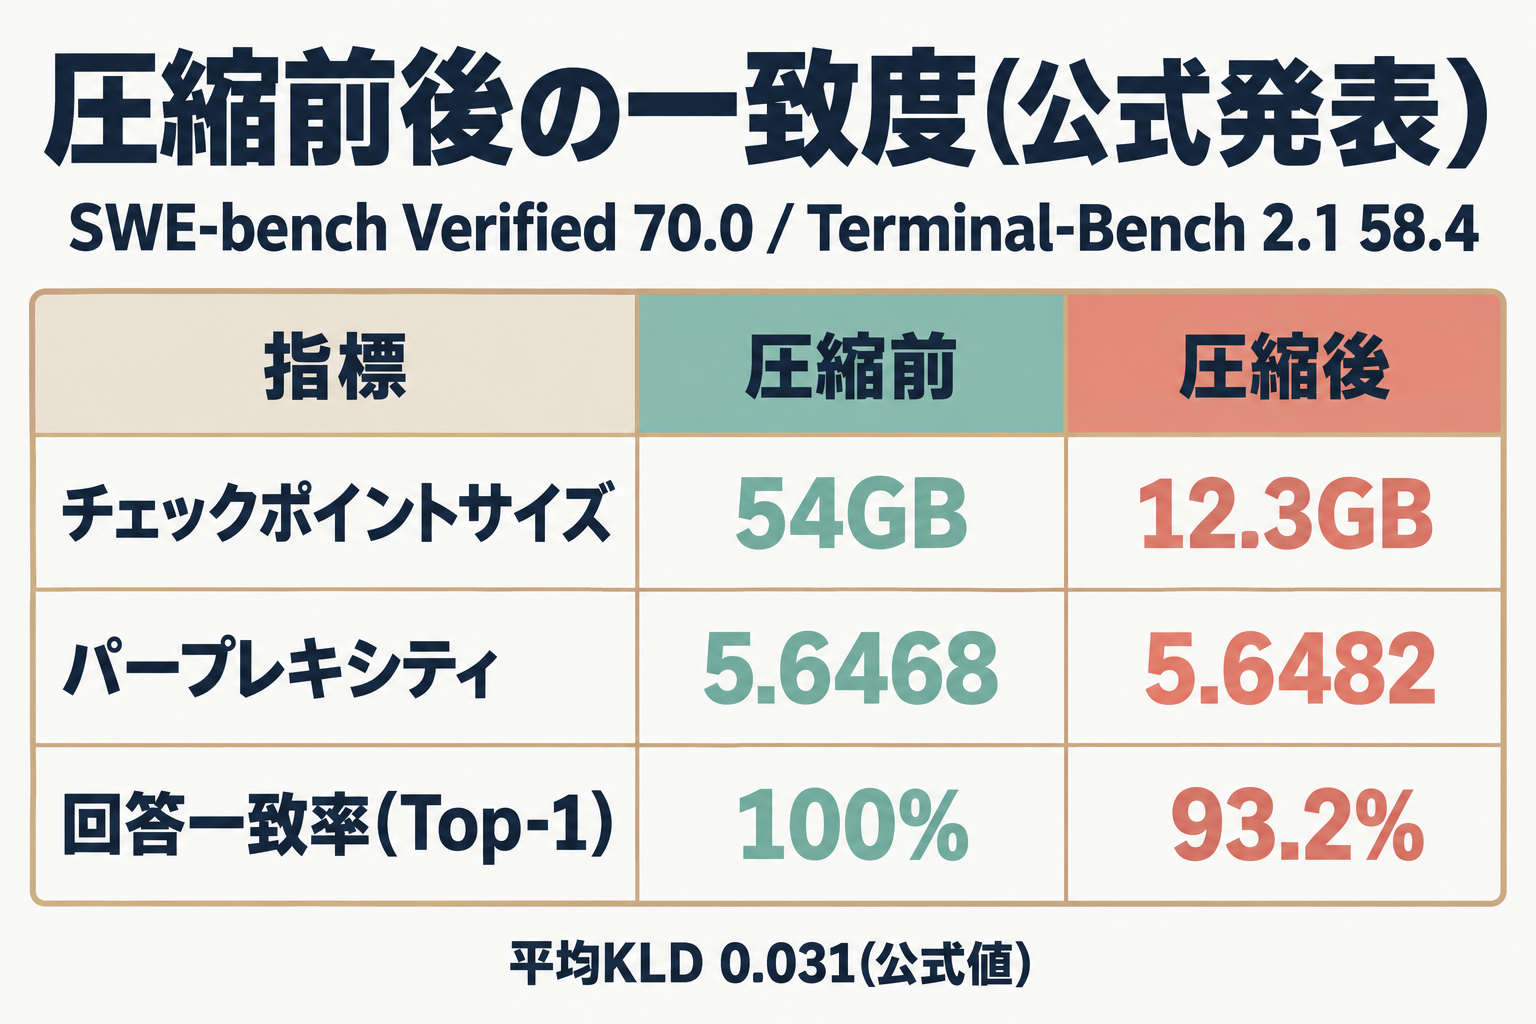
圧縮前後の一致度として、次の数値が公式から示されています。
| 指標 | 圧縮前 | 圧縮後(OrcaSAQ-2) |
|---|---|---|
| チェックポイントサイズ | 54GB | 12.3GB |
| パープレキシティ | 5.6468 | 5.6482(差+0.02%) |
| 回答一致率(Top-1) | 100% | 93.2% |
| 平均KLD(圧縮前後の確率分布のズレを示す値) | - | 0.031 |
エージェント向けのベンチマーク(性能を一定の基準で測るテスト)としては、SWE-bench Verifiedで70.0、Terminal-Bench 2.1で58.4という数値が示されています。ただし公式は「エージェントのベンチマークは、周囲の仕組み(ツール、推論の余裕、制限時間、実行環境)によって結果が変わる」「以下は公開されている値との参考比較であり、同一条件での直接比較ではない」と注記しており、他モデルとの順位を断定できる数値ではありません。
実行環境は、重み12.3GB(16GBのGPUに収まるサイズ)で、vLLM(推論サーバー)に「OrcaSAQ2」対応の連携を組み込んで動かす形です。速度はMTP(投機的デコーディング、次のトークンを先読みして生成を速める仕組み)が有効な場合で、1ストリームあたり毎秒90.1トークンと公式は説明しています。
コンテキスト長(AIが一度に読み書きできる文章の長さ)は仕様上26万2144トークンです。ただしHugging Faceのモデルページによれば、16GBのGPUではモデル読み込み後に残るメモリが約3.7GBのため、実用的な目安は約3万2000トークンとされています。画像入力には対応せず、テキストのみが対象です。
できるようになること・向いている使い方(公式が示す範囲)
公式リリースが明言している用途は、「コーディングやツール操作など実務に近い作業をこなすエージェント運用」です。長時間動き続けるAIエージェントは、途中の小さな判断のズレがその後の判断すべてに影響するため、「長期の作業で使えるか」を圧縮の評価軸に置いたと説明されています。
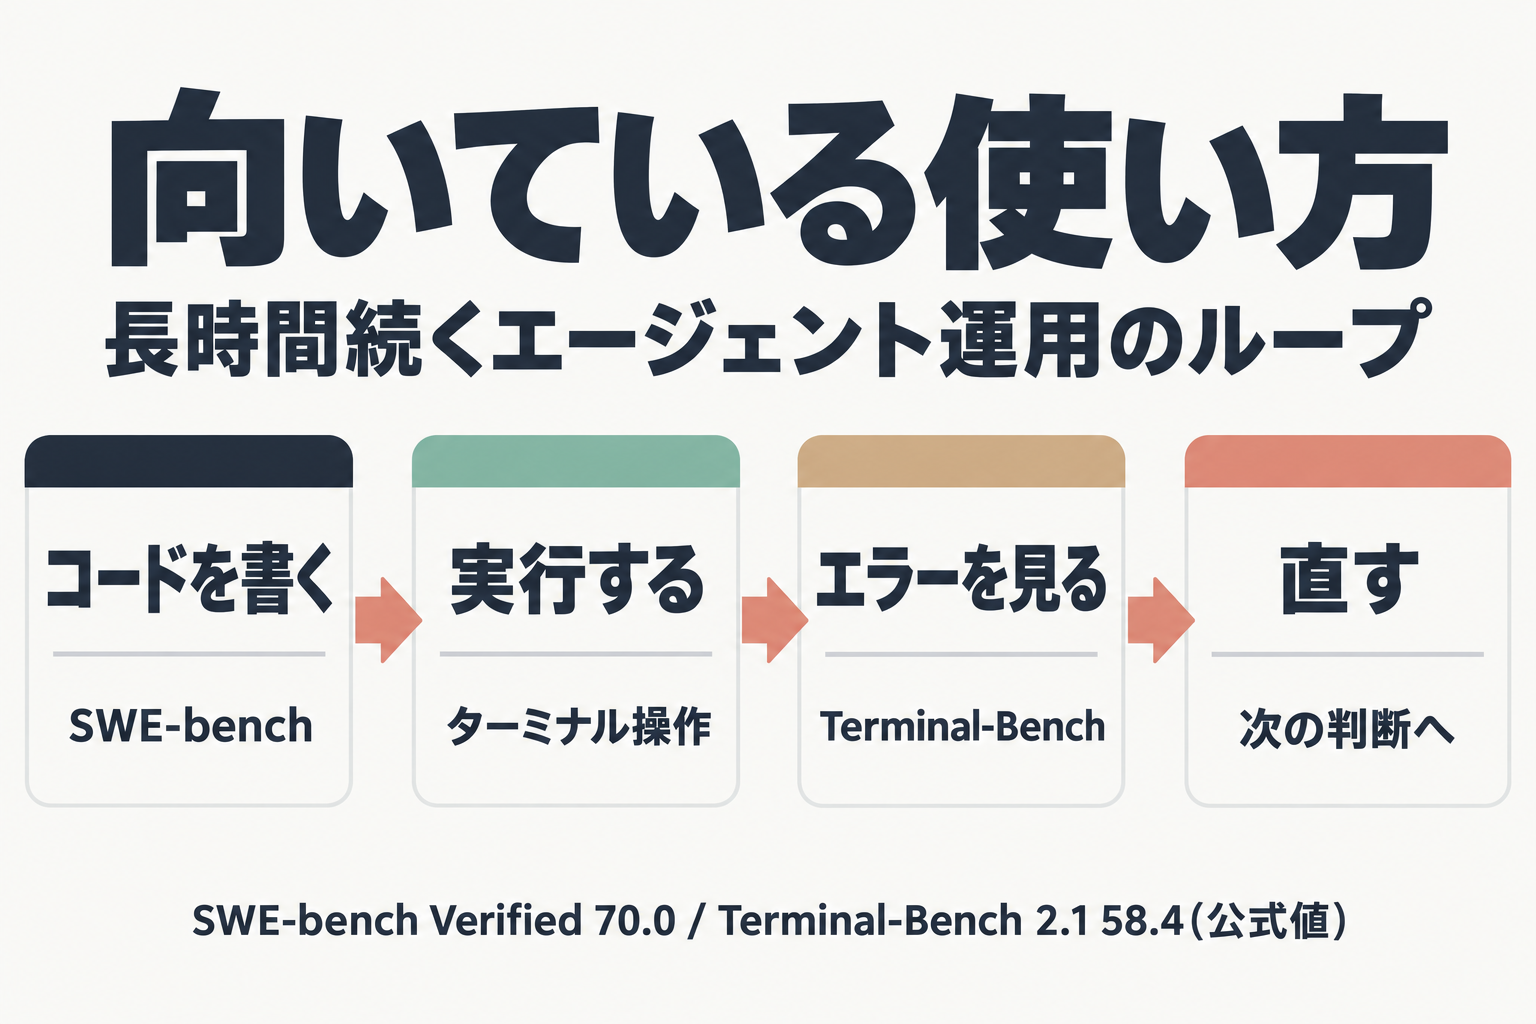
翻訳すると、想定されているのは「コードを書く→実行する→エラーを見る→直す、を何十回も繰り返すコーディング支援」や「ターミナル上でコマンドを実行しながら進める自動化作業」といった場面です。SWE-bench Verified(コーディングエージェントの評価)とTerminal-Bench(ターミナル操作の評価)という2つの指標が示されているのも、この用途を反映したものです。
「ノートPCで動く」「シングルGPUで動く」といった具体的な動作環境の言及は公式リリースにはなく、16GBのGPUが前提という記載以上のことは分かりません。
入手方法・提供条件を確認する
OrcaSAQ-2 27Bは、Hugging Face(orcarouter/OrcaSAQ-2-27B)で重みが直接公開されています。ライセンスはApache-2.0で、圧縮前のベースモデル(Qwen3.8-27B)のライセンスをそのまま引き継ぐとされています。料金については、プレスリリース本文に記載はありません。
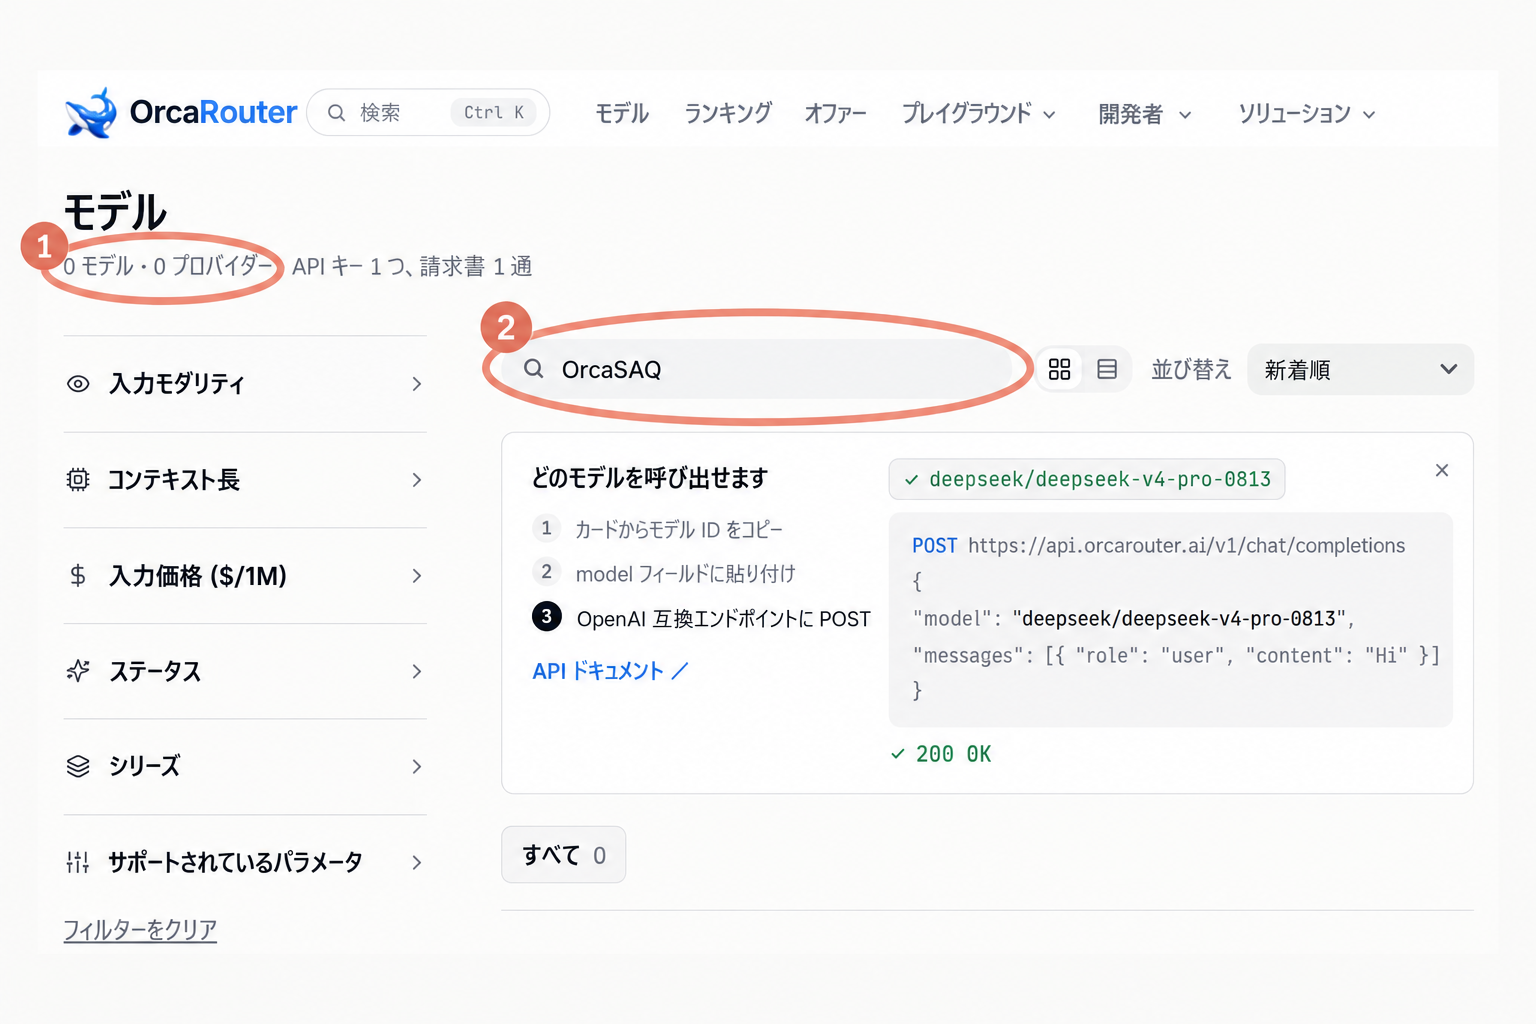
プレスリリースは「OrcaRouterの研究チームが開発した」というモデルの出自を説明していますが、OrcaRouterはOpenAI互換のAPIで200以上のモデルをまとめて使えるゲートウェイサービスで、その公式モデル一覧(2026年9月25日時点)を確認すると、「OrcaSAQ」に該当するモデルは掲載されていません。OrcaRouterの料金ページの例示モデルにも含まれていません。つまり現時点で実際に入手できる経路は、Hugging Faceからの重み直接ダウンロードのみです。
参考までに、OrcaRouter自体の料金体系は「Hacker(無料・永久無料・トークンの上乗せ0%)」「Team(カスタム)」「Enterprise(カスタム・SLA対応)」の3段階で、トークン費用はモデル提供元の公表レートがそのまま請求される仕組みです。ただしこれはOrcaRouterというサービス全体の説明であり、OrcaSAQ-2固有の提供条件ではありません。
現時点でわからないことTop3
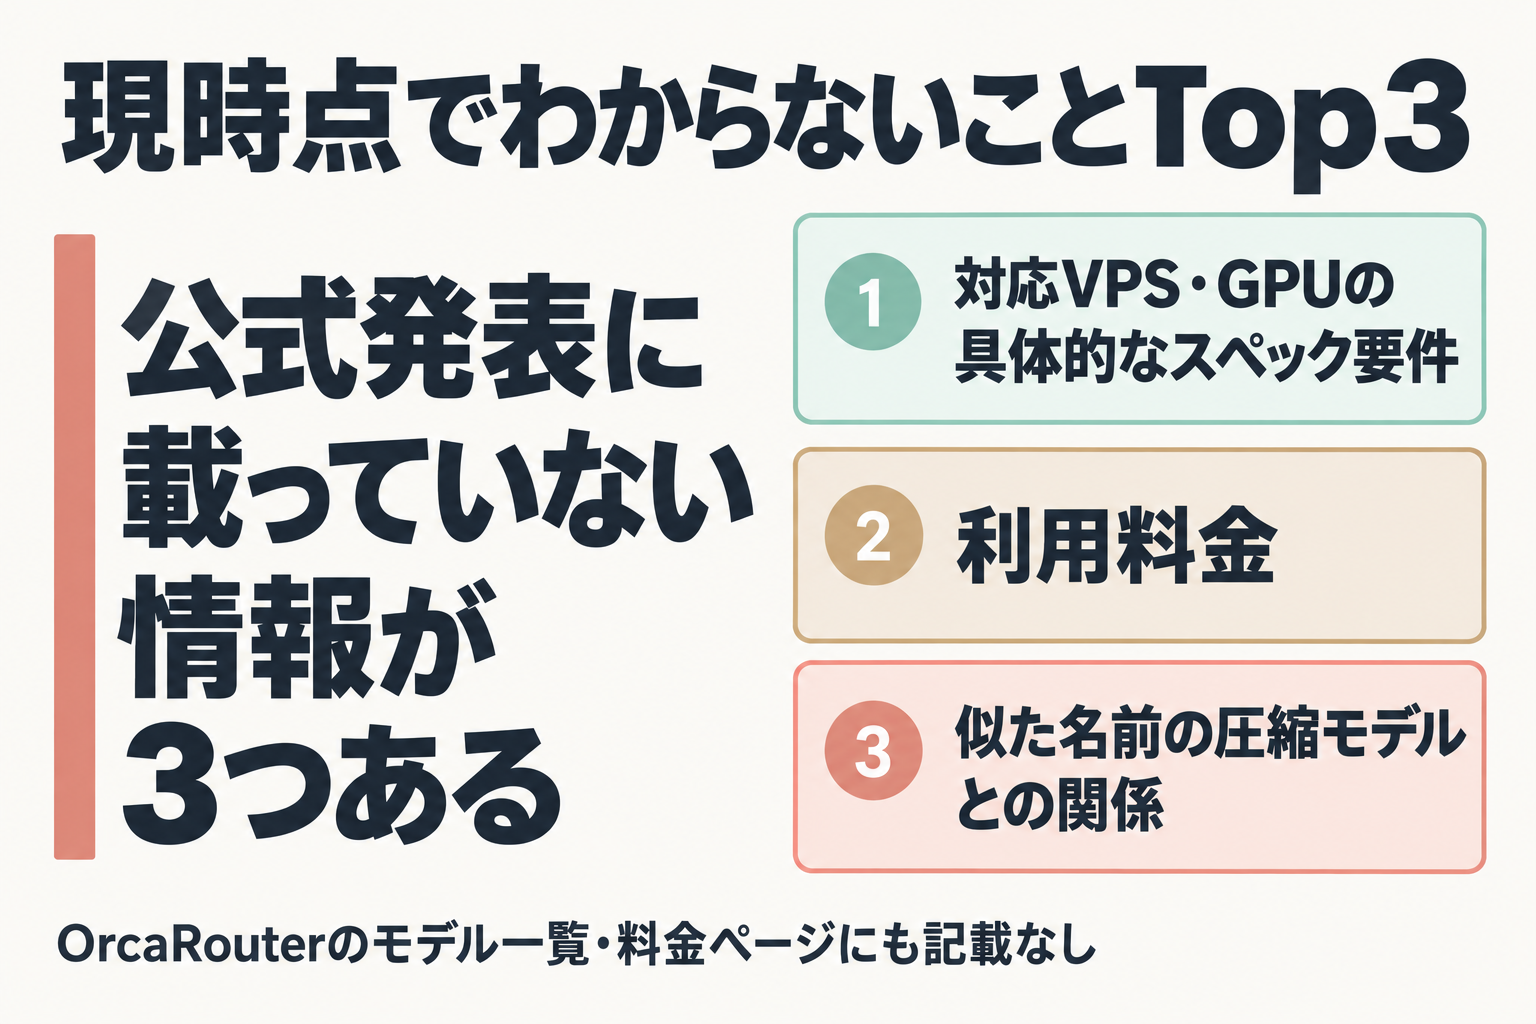
- 対応VPS・GPUの具体的なスペック要件: 公式が明示しているのは「16GBのGPU」という点までで、対応するGPUの機種やVPS事業者側のGPUプラン名までは記載がありません。
- 料金: プレスリリース・OrcaRouter公式サイトのいずれにも、OrcaSAQ-2の利用料金や無料枠の有無は記載がありません。
- 似た名前の圧縮モデルとの関係: OrcaRouterが関わる圧縮モデルは他にも存在しており、名前や技術方式が紛らわしいものがあります。関連プロジェクトのGitHub上のページでは、OrcaRouterは別の27B圧縮モデル(別の圧縮方式・別の開発元によるもの)にランタイム実装を提供したクレジット表記がありましたが、そのページに「OrcaSAQ」「OrcaSAQ2」という語への言及はありませんでした。組織としての接点はあっても、OrcaSAQ-2とは別モデル・別の圧縮方式と考えるのが妥当です。
今日試せる最初の一歩
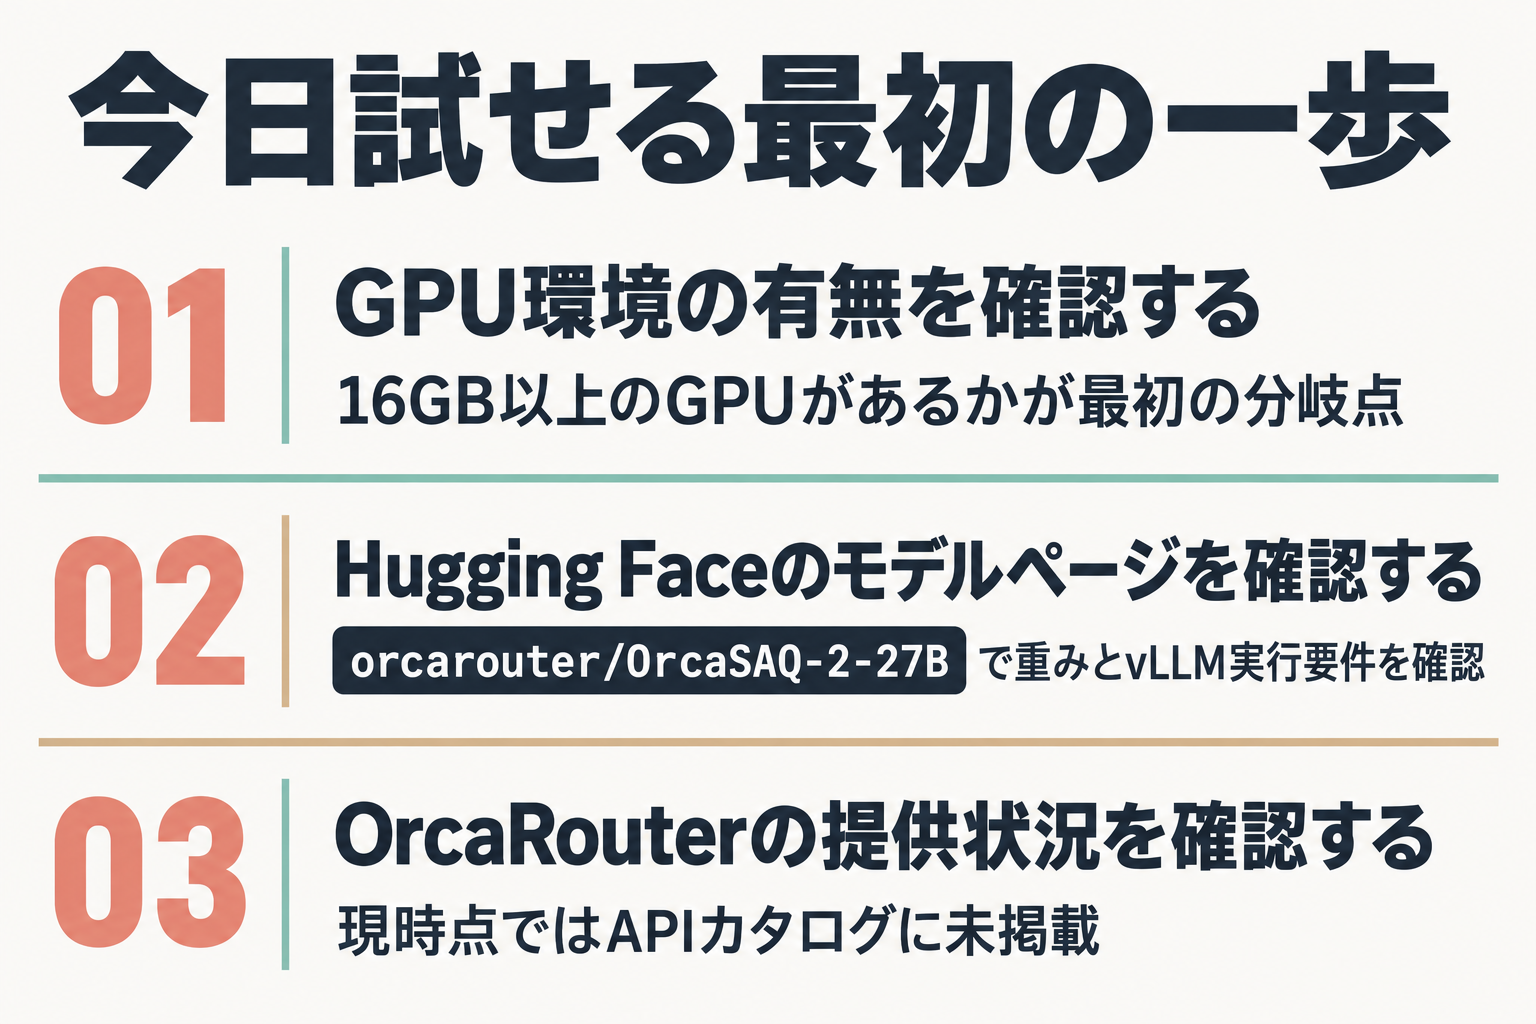
- GPU環境の有無を確認する: 16GB以上のGPUがあるかどうかが最初の分岐点です。ない場合、今のところOrcaSAQ-2をそのまま動かす手段はありません。
- Hugging Faceのモデルページを確認する:
orcarouter/OrcaSAQ-2-27Bのページで、重みのダウンロード方法とvLLMでの実行要件を確認します。 - OrcaRouterの提供状況を定期的に確認する: 現時点ではAPIカタログに掲載されていないため、API経由で使いたい場合は公式ページで今後の掲載を待つ形になります。
OrcaSAQ-2 27Bは16GBのGPUが前提のモデルで、GPUを搭載しない標準的なVPSではそのまま動かせません。ただし前述のとおり、0.5B〜3B級の軽量モデルならこのクラスのVPSでも動作実績があります。weeveeの実測では、メモリ4GBのVPSで3B級モデルまで安定動作を確認済みです(2GBでは3B級はメモリ使用率99.92%まで達し限界でした)。メモリ4GB〜8GBの実測でのVPS動作確認については、Discord Bot 24時間稼働|実測メモリで選ぶVPSをご参照ください。今すぐOrcaSAQ-2専用にVPSを選ぶ必要はありませんが、AIエージェントやワークフローを動かす基盤を先に整えておきたい人は、月額2,068円〜・初期費用無料・メモリ4GBから始められるプランで、まずこの3B級までの軽量モデル運用に慣れておくのが現実的です(GPU搭載は「GPUサーバー」という別プロダクトのため、このプランでOrcaSAQ-2そのものが動くわけではありません)。今日やるなら、料金ページで4GBプランの内容を確認するところから始められます。
2GBから8GBまで、必要なメモリ容量に応じて選べるVPS(月2,068円〜)
エックスサーバー の料金プランを確認する(公式)もっと詳しく
OrcaSAQ-2の対応VPSスペックや料金、実際の動作確認については、公式情報が更新され次第、別記事で取り上げる予定です。