日本テラデータは2026年9月29日、自然言語の指示とガイド付き実行だけで、データ分析からAIアプリ構築、インフラ運用までの複雑な業務を人手を挟まずに完遂する企業向けAI新機能を発表しました。関係するのは社内のデータ基盤・BI運用を担当する部門と、業務自動化への投資を判断する意思決定者です。今日できる最初の一歩は、公式の発表ページと製品ページで、自社が使っているプランが対象になるか・いつから使えるかを確認することです。
ここでの内容は公式発表・製品ページの記載(2026年9月29日時点)に基づいており、実際のアカウント登録や操作は行っていません。
これは何の続きか
テラデータには「Tera」という名前のAI機能がすでにあります。今回の発表は新しい製品の登場ではなく、この既存のTeraに3つの機能を追加する話です。位置づけを理解するには、テラデータの基盤全体の変遷を押さえておくと分かりやすくなります。
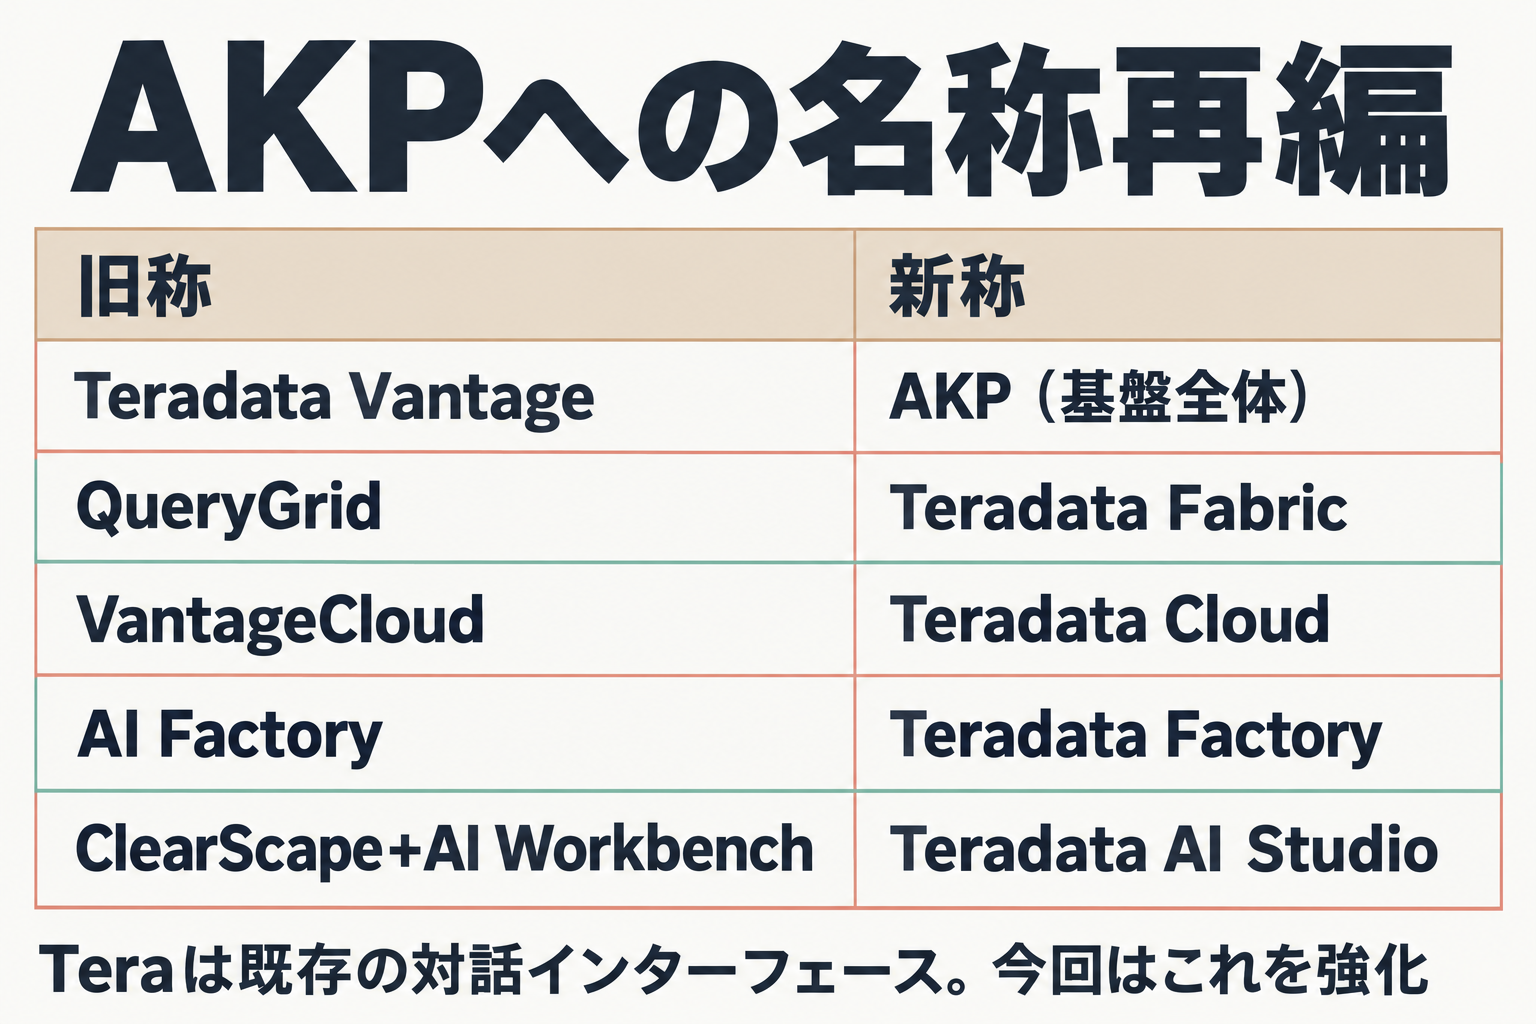
2026年5月7日、テラデータはデータ分析基盤「Teradata Vantage」を土台に、AIエージェントの開発・実行機能を統合した新基盤「Teradata Autonomous Knowledge Platform(AKP)」を発表しました。この統合に合わせて、関連製品も改称されています。データ仮想化機能の「QueryGrid」は「Teradata Fabric」に、クラウド版の「VantageCloud」は「Teradata Cloud」に、AI処理用アプライアンスの「AI Factory(旧IntelliFlex)」は「Teradata Factory」に、そして分析エンジン「ClearScape Analytics」とAI開発環境「AI Workbench」を統合したものが「Teradata AI Studio」になりました。「Tera」は、このAKP上で対話形式の操作を担うインターフェースとして、すでに提供されていた機能です。
つまり今回の発表は、「土台(AKP)を作る→運用基盤(Teradata Cloud/Teradata Factory)を整える→対話窓口(Tera)を強化する」という一連の流れの、直近のステップにあたります。実際、AKPは2026年7月15日付でクラウド版・オンプレミス版とも一般提供(GA)に到達したと発表されており(予告時点の「クラウド版は第3四半期・オンプレミス版は年内」より前倒し)、今回の機能強化はこの土台の上で行われています。
何が新しいのか
今回追加が発表されたのは3つの機能です。専門用語をひとつずつ、仕事の言葉に置き換えて説明します。
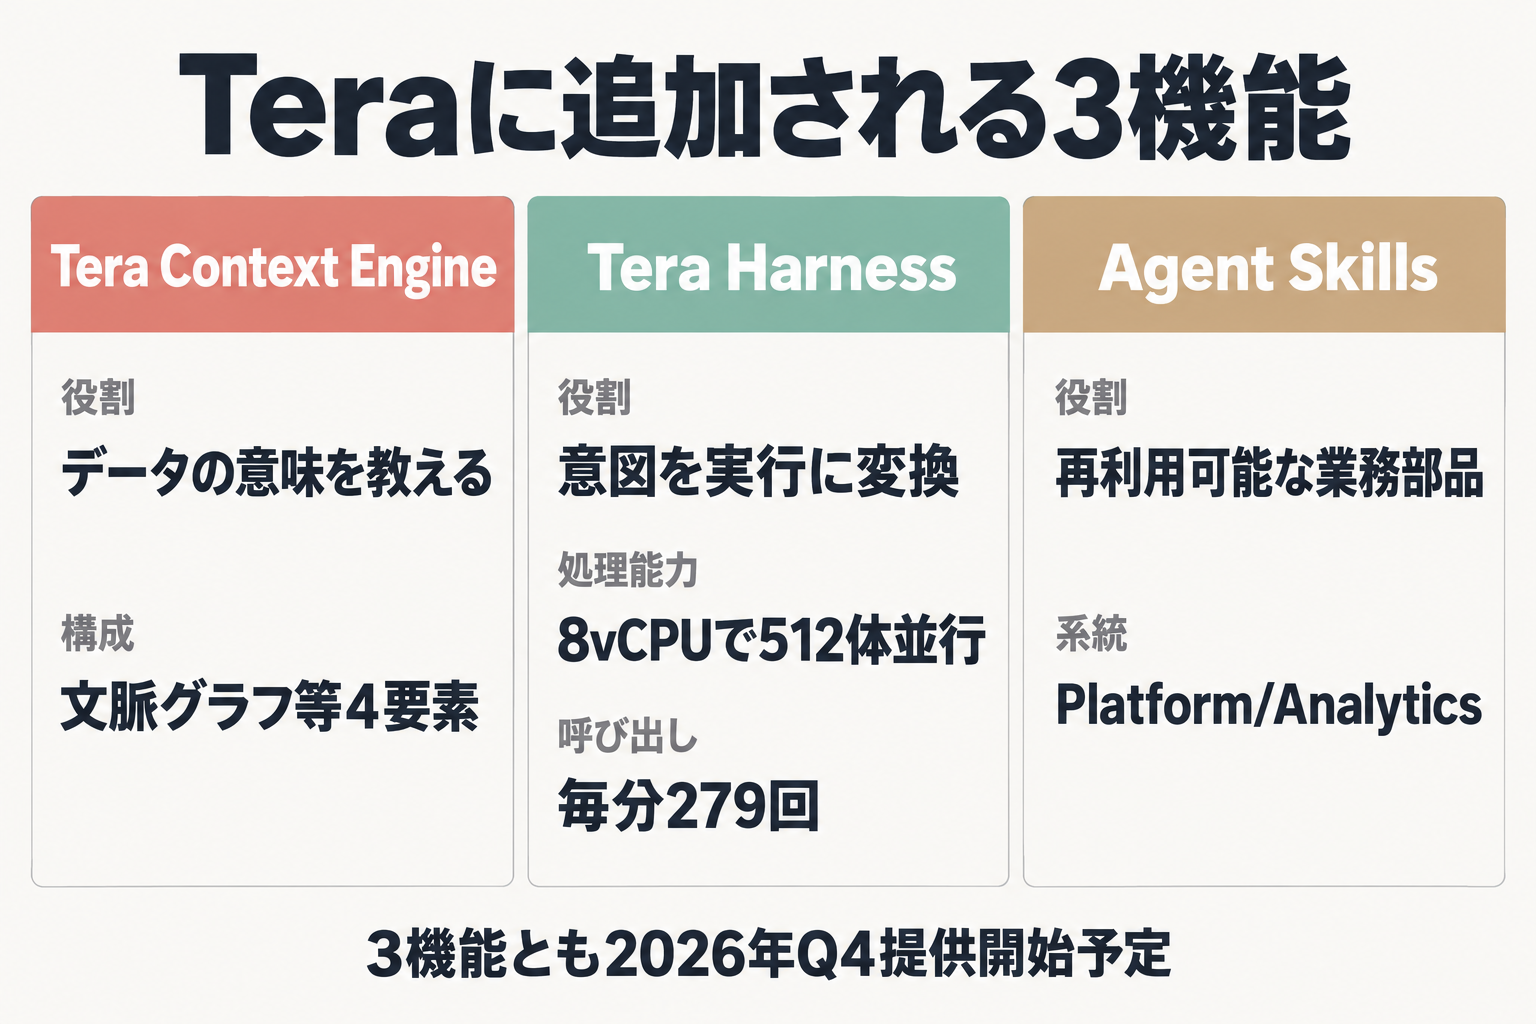
① Tera Context Engine(テラ・コンテキスト・エンジン) — 社内に散らばったデータの「意味」「関係」「使うべき道具」をAIに教える仕組みです。特定のベンダーやツールに縛られない「コンテキスト(文脈)・オーケストレーション(指揮)層」で、①データ同士のつながりを地図化する仕組み(Native Context Graph)②記号処理を組み合わせて推論の精度を上げる仕組み(Neurosymbolic Models)③クエリのコストを自動で管理する仕組み(Deterministic Query Economics)④自律動作の範囲をガバナンスで統制する仕組み(Governed Agentic Automation)の4要素で構成されています。要は「AIが会社のルールとデータの意味を知らないまま暴走したり、見当違いの答えを出したりしないよう、あらかじめ文脈を教え込んでおく層」です。
なお、AKPには2026年5月の発表時点で、データの意味・関係・来歴を一元管理し、AIエージェントが業務の文脈を踏まえて推論できるようにすることでハルシネーションを抑える基盤データ層「ナレッジコンテキスト」がすでに存在します。今回のTera Context Engineがこの「ナレッジコンテキスト」を拡張するのか、置き換えるのか、別レイヤーとして併存するのかは、2026年9月29日の発表原文には明記されていません。
② Tera Harness(テラ・ハーネス) — 「やりたいこと(意図)」を「実際の成果」に変換して実行する層です。Go言語とgRPCで組まれたエンジンで、8vCPUの仮想マシン1台で512個のAIエージェントを同時に動かし、毎分279回のツール呼び出しをさばける性能を持ちます。あらかじめ84パターンの実行パターンを学習済みで、AIが同じ処理をムダに何度も繰り返す「無駄打ち」を抑えるコスト最適化の仕組みも備えています。このHarnessは、テラデータが独自に公開しているオープンソースのエージェント基盤「Loom」の上に構築されており、Anthropicが策定したオープン標準「Agent Skills」(SKILL.md形式。Claude CodeやOpenAI Codex、Cursorなど32のツールが採用)を拡張する設計になっています。
③ Agent Skills(エージェント・スキル) — データエンジニアリング・分析・データサイエンスの現場でよく使うタスクを、再利用できる部品として提供する機能です。運用管理を担当する「Platform Agents」と、分析業務を担当する「Analytics Agents」の2系統があります。
テラデータの説明を借りると、一般的なAIアシスタントが単に「回答」を生成するのに対し、Teraは「成果」をもたらすとされています。今回の3機能は、Teraを「質問に答えるAI」から「データ整備・ツール呼び出し・実行管理までを含めて仕事を完遂するAI」に変えるための土台、という位置づけです。
何ができるようになったか
「成果をもたらす」と言われても抽象的なので、テラデータが自社で計測したベンチマーク結果を業務の場面に当てはめてみます。数値は公式発表(日本語版・英語版で完全一致することを確認済み)にあるものだけを載せ、記載のない場面には数値を書きません。
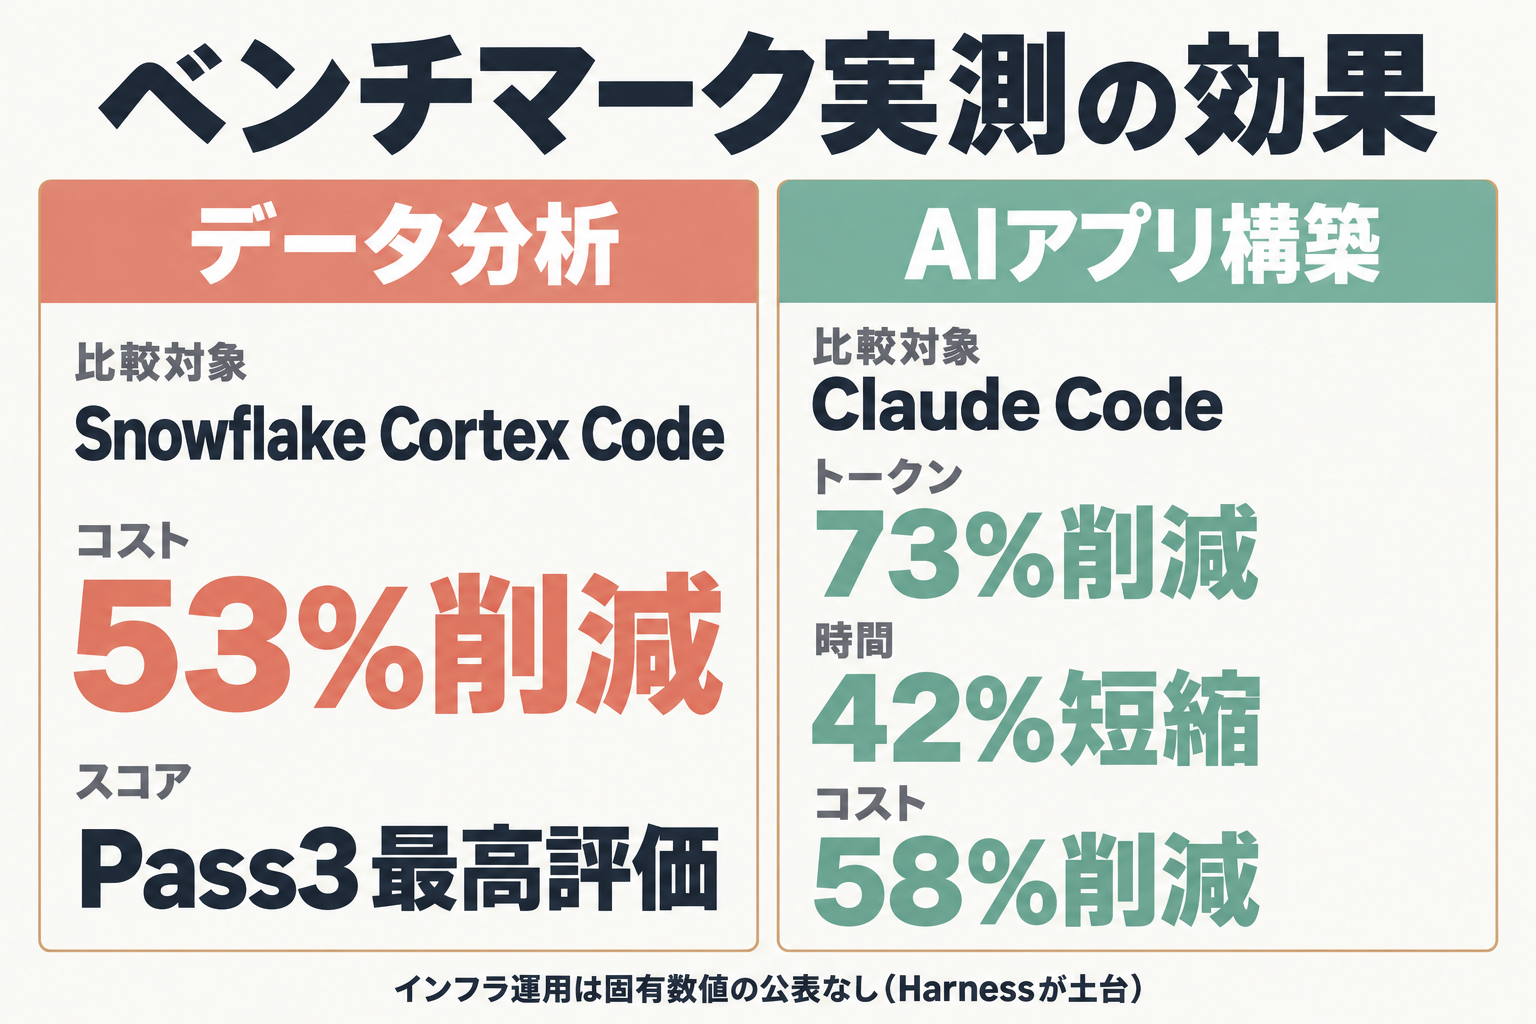
データ分析の場面 — Snowflake Labs・Bespoke Labsが策定したデータエンジニアリング向けベンチマーク「data-eng-bench」(公開データ使用)で、同じくOpus 5を使うSnowflake Cortex Codeと比較し、タスク1件あたりのコストが53%削減、Pass3スコア(3回試行して正解できた割合)で最高評価を獲得したとされています。分析担当のAnalytics Agentsが、これまで人がクエリを書いて試行錯誤していた作業の一部を肩代わりする場面です。
AIアプリ構築の場面 — ソフトウェア開発タスクのベンチマーク「SWE-bench Pro」で、同じくOpus 5を使うClaude Codeと比較し、トークン消費量73%削減・処理時間42%短縮・総コスト58%削減という結果が公表されています。加えてADE-benchでは最高スコアとタイの成績です。コーディングエージェントを使ったアプリ開発が、同じ規模の処理をより安く・速く終えられるようになった、という意味です。
インフラ運用の場面 — この場面に固有の業務効果の数値は公式発表に記載がありません。ただしTera Harnessの処理能力(8vCPUの仮想マシン1台で512エージェントの同時実行、毎分279回のツール呼び出し、84パターンの実行済みノウハウの適用)が、運用管理を担うPlatform Agentsを多数同時に動かすための土台になっています。
いずれも「同じ処理をより少ないコスト・時間で終える」という方向の改善で、テラデータ自身が今回の発表で強調しているポイントと一致しています。
対象と提供条件
対象ユーザーは「ビジネスアナリストからプラットフォームエンジニア、データベース管理者(DBA)に至るまで」と公式発表に明記されています。利用環境もクラウド・オンプレミス・ソブリン環境(自国内のインフラで完結させる環境)を問わず、ハイブリッド構成でも利用できるとされています。特定の料金プランや契約形態に限定するという記載は、今回の発表には一切ありません。
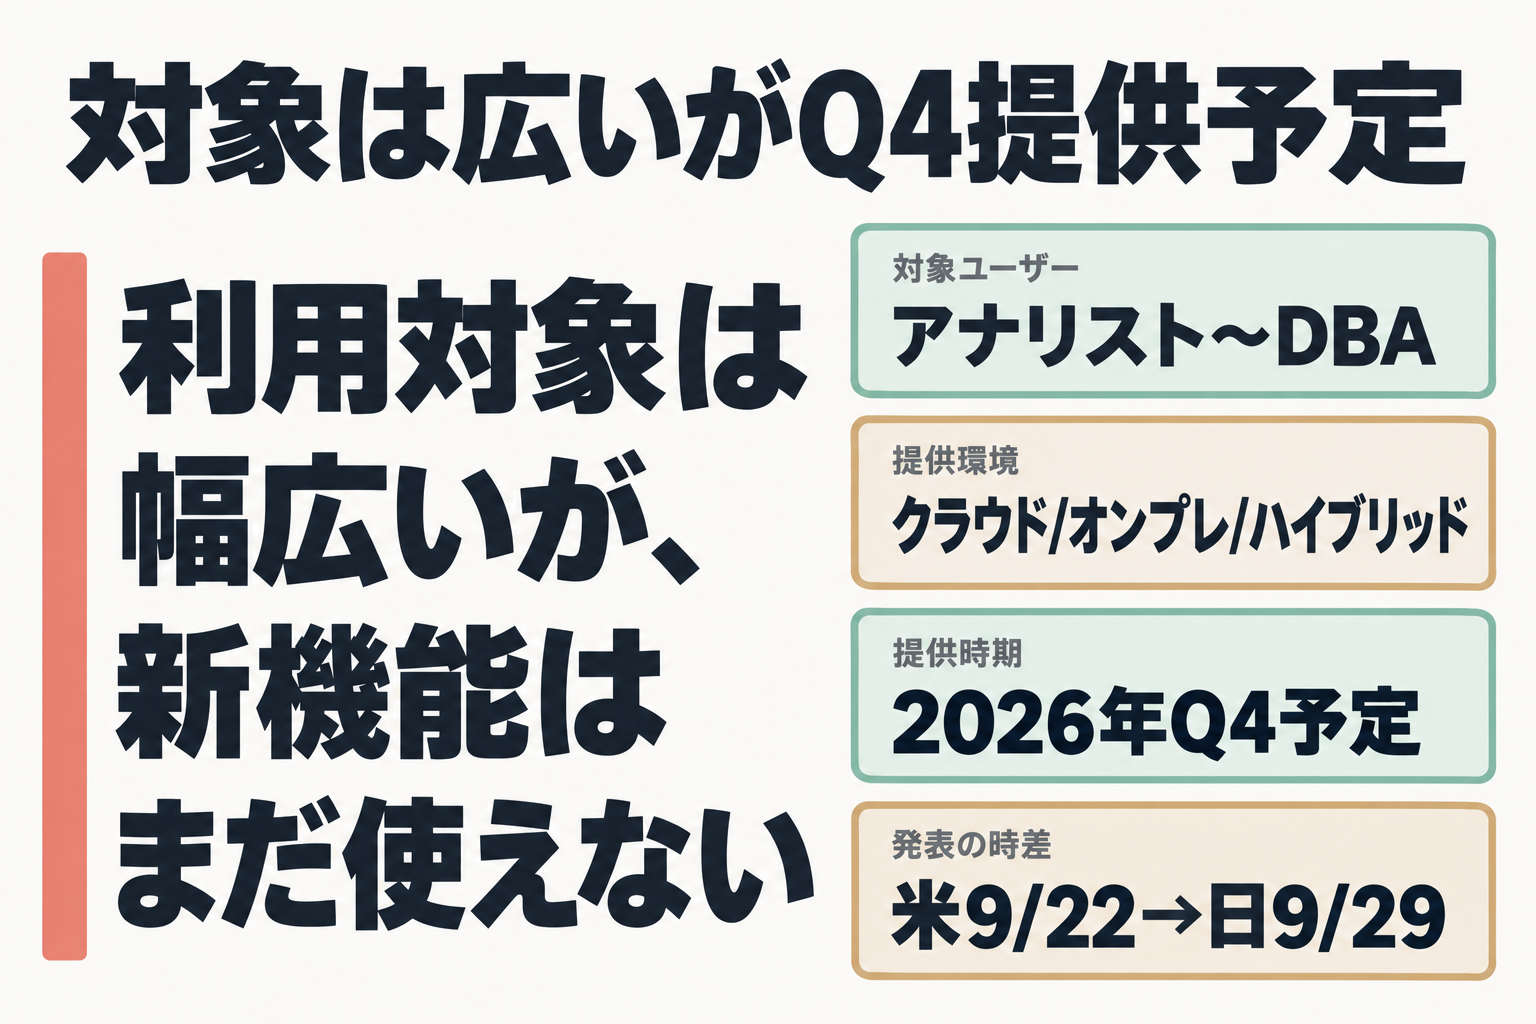
ただし、今すぐ使えるわけではありません。Tera Context Engine・Tera Harness・Agent Skillsの3機能は、公式発表の原文で「2026年第4四半期に提供開始予定」と明記されており、2026年9月29日時点ではまだ利用できません。この点は英語版・日本語版の発表内容で一致しています。
なお、日本語のPR TIMES発表は9月29日付ですが、元になった英語版のプレスリリースは1週間前の9月22日(米国サンディエゴ)に公開されたものです。過去のAKP発表でも米国5月7日に対し日本語版は5月27日という、同様の時差があったパターンが確認されています。テラデータの発表は「米国先行→日本語版が約1週間後」という流れが定着しているようです。
試せるのか・向いている人
個人や小規模チームが無料で今回の新機能を試せる窓口は、2026年9月29日時点で公式サイトに見当たりません。
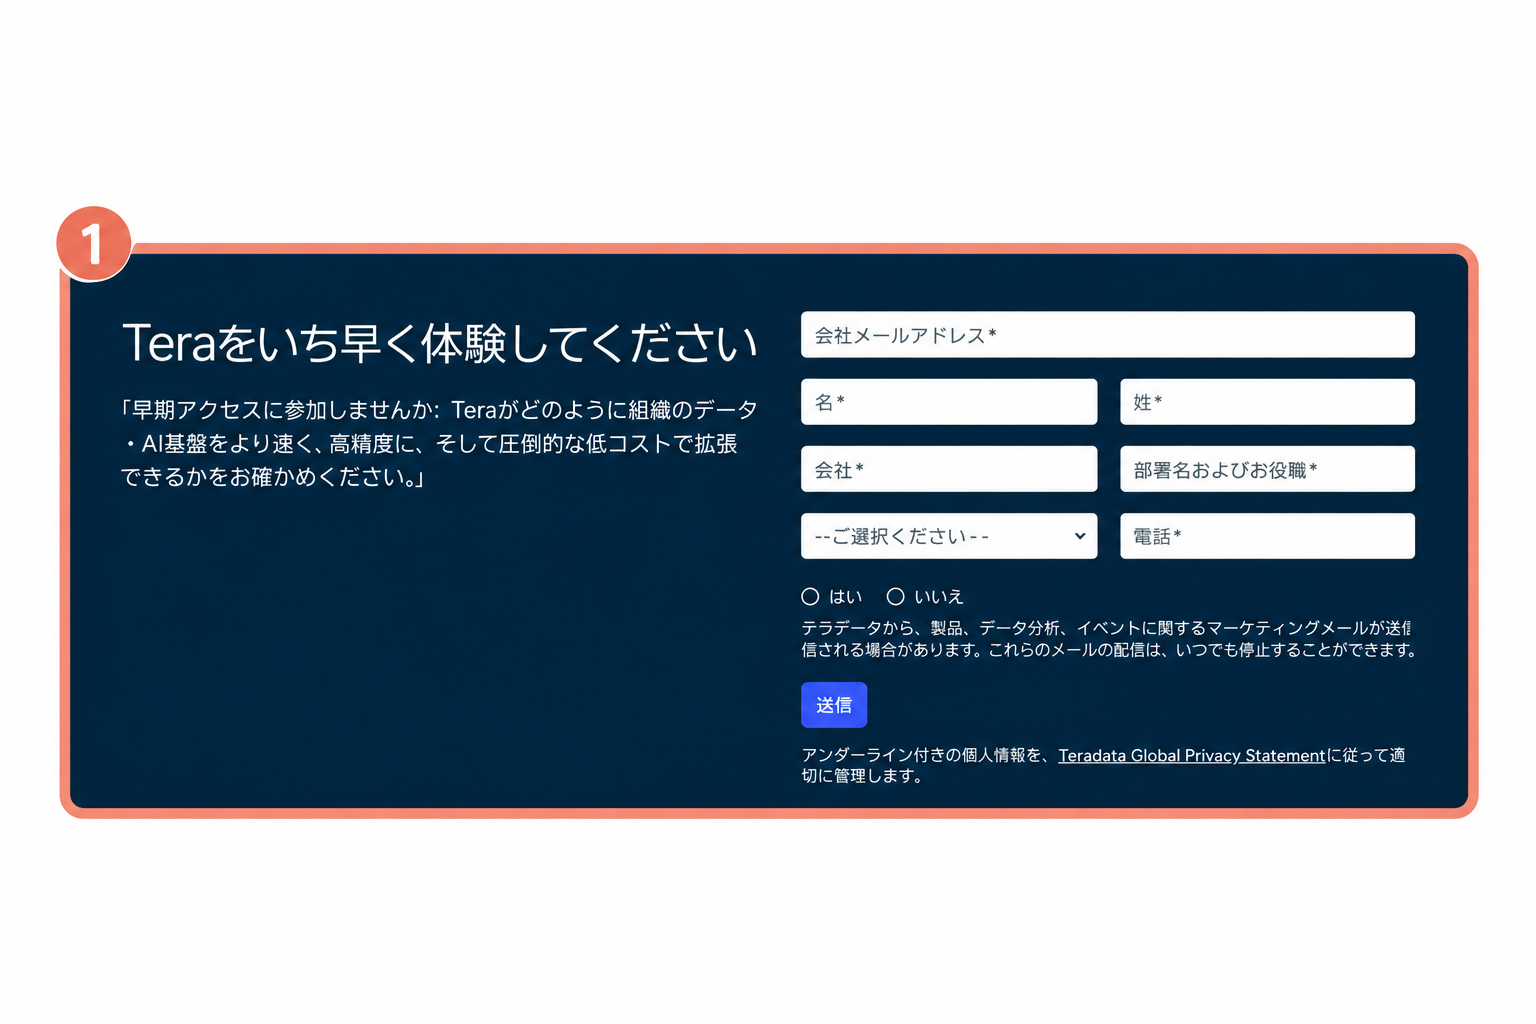
テラデータには、分析基盤Vantageの機能をカード登録不要・無料で試せる既存のトライアル環境「ClearScape Analytics Experience」があります(250以上の業界別ガイド付きデモを用意)。ただし2026年9月29日時点で、このトライアルページに今回発表のTera Context Engine・Tera Harness・Agent Skillsへの言及はありません。今回の新機能専用の窓口としては、Tera製品ページにある「早期アクセスを申し込む」フォーム(会社メールアドレス・氏名・会社名・部署名や役職・電話番号が必須項目)のみです。新機能が既存の無料トライアルに含まれるかどうか、対応する料金プランがどうなるかは、公式発表に記載がありません。
向いているのは、すでにTeradata Vantage(現AKP)を導入していて、Teraの機能強化を早めに知っておきたいデータ基盤・BI運用の担当者です。個人が興味本位で無料の範囲だけ触ってみる、という使い方は今回の新機能では想定されていません。
今日できる一番確実な一歩は、Tera製品ページの「早期アクセスを申し込む」フォームに登録し、Q4の提供開始と同時に情報を受け取れる状態にしておくことです。必須項目は会社メールアドレス・氏名・会社名・部署名や役職・電話番号のみで、その場で完了します。
補足として、社内にプラン担当の窓口がある場合は「Q4提供の新機能が自社の契約に含まれるか」を合わせて確認しておくと導入判断が早まります。本格的な導入を検討する段階になれば、テラデータの導入支援サービス「Teradata AI Services」への相談も次の選択肢です。テラデータ自身、AIの実証実験(PoC)の95%が失敗する原因を「技術的な限界ではなく、優先順位付け・ガバナンス・実行の不備」と分析しており、こうした支援サービスの存在は、導入のハードルが技術面より運用体制にあることを示しています。
データ基盤運用者向け:SWE-bench実測でコスト58%減。
テラデータ Tera(Autonomous Knowledge Platform) を申し込む(公式)もっと詳しく
導入実績はあるのか
テラデータの公式ケーススタディには、クレディセゾンが統合データ基盤としてTeradata Vantage(現AKPの前身)を採用した事例が掲載されています。ただし具体的な利用者数やシステム連携数は、公式ケーススタディのページに記載がなく確認できていません。
雪印メグミルクもTeradata Vantageの導入企業として紹介されることがありますが、今回のTera Context Engine・Tera Harnessに関する活用内容を示す一次情報は本稿執筆時点で確認できなかったため、確認できたクレディセゾンの事例のみを扱います。
「自律型協働AI」という呼び方について
テラデータは今回、TeraをAgentic Coworker(自律型協働AI)と位置づけています。一方でテラデータの他の発表や紹介記事では、複数のAIエージェントが分業してタスクを処理する「エージェント型AI」という呼び方も使われています。今回の発表文には、この2つの呼び方の関係を整理した説明は含まれていません。導入を検討する際は、呼称の違いにとらわれず、今回のTera新機能を指しているかどうかを直接確認するのが確実です。
導入支援サービスの中身
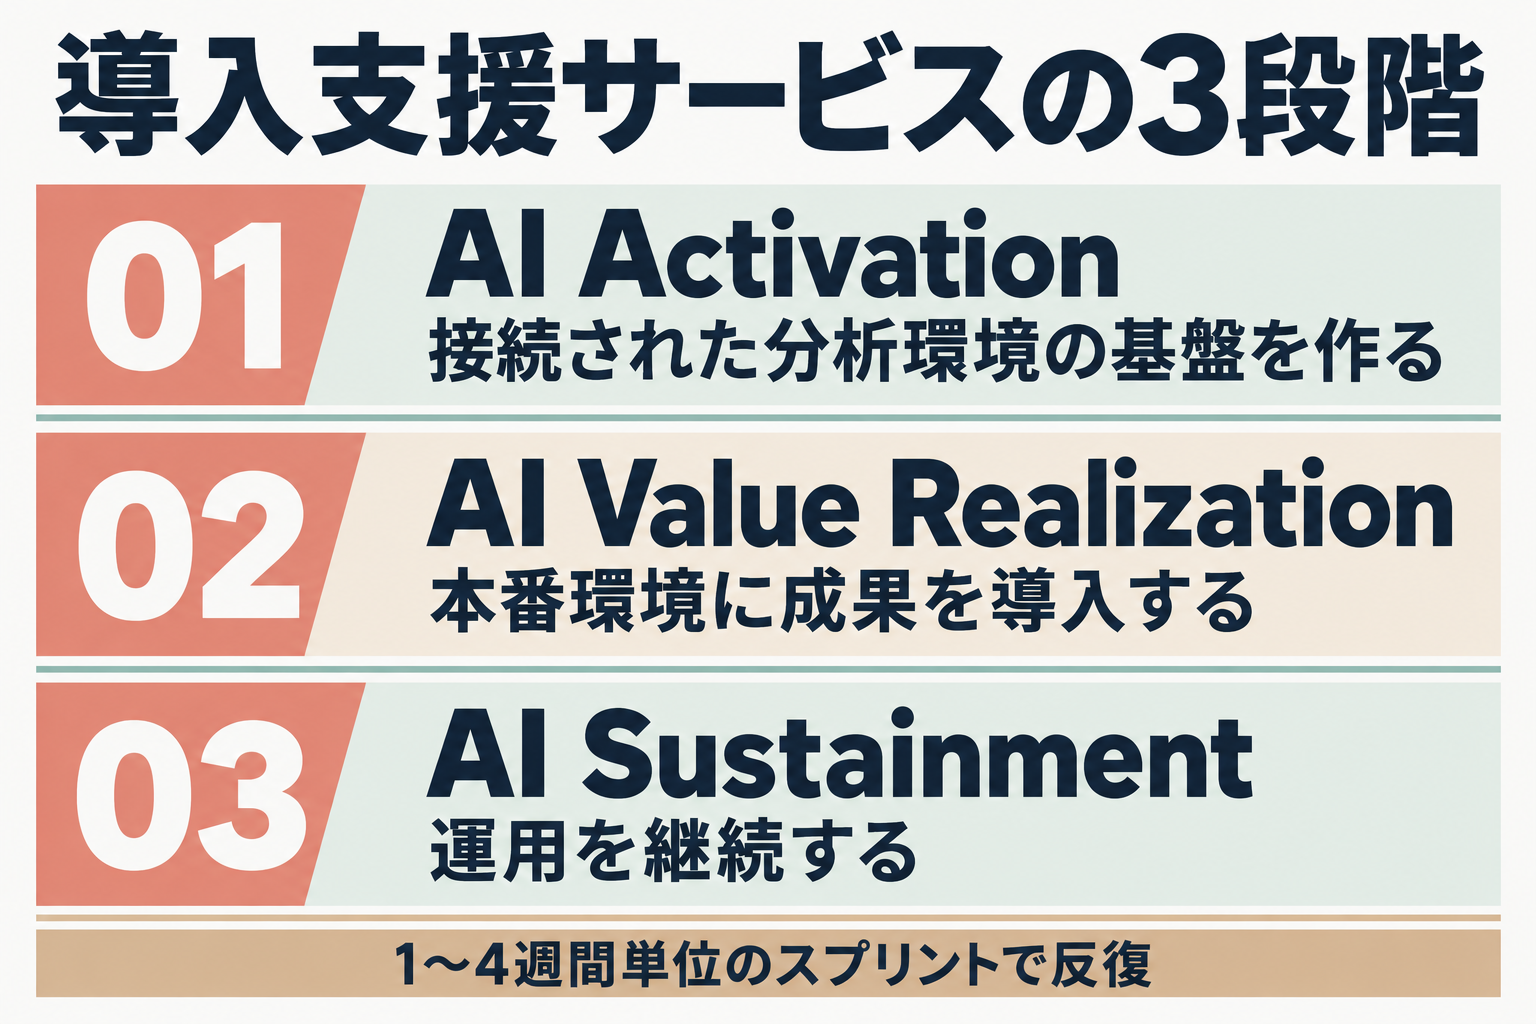
テラデータは、AIエージェントの本番運用を段階的に支援するコンサルティング「Teradata AI Services」を提供しています。1〜4週間単位の「スプリント」を繰り返しながら、①接続された分析環境の基盤を作る「AI Activation」②本番環境に成果を導入する「AI Value Realization」③運用を継続する「AI Sustainment」の3段階で進める方式です。今回の発表でも、導入を加速させたい組織向けにこのサービスが案内されています。