Netskopeは、企業のセキュリティチーム向けに、AIエージェントの危険な行動を実行前に判定してブロックする新機能「Skylight Agent Action Control」を発表した(国際発表は2026年9月15日、日本語での発表は同年9月30日)。対象は企業のセキュリティ・ネットワークチームで、個人ユーザー向けの製品ではない。だが「自分の指示していないところで、AIエージェントに勝手に危険な操作をされたくない」という悩みは、Claude CodeやCursorのようなAIエージェントを自分で動かしている個人にも共通している。
迷ったらこれ: Claude Codeを使っているなら、settings.jsonの権限設定(permissions)とフック(hooks)で、同じ発想を今日から無料で作れる。実測では、破壊的なファイル削除や課金を伴うクラウド操作を想定したコマンドを、設定を書き加えるだけで実行前に検知できた(ただしPowerShellのコマンドは検知をすり抜けた=対策には限界がある、詳しくは後述)。
以下、Netskopeの発表内容は公式情報、Claude Codeでの検証は実際に手を動かした実測(2026年9月30日実施)として区別して書く。
Netskopeが発表した「実行前ブロック」の中身
これまでAIエージェントは、指示されればその通りに実行するのが基本の動き方だった。Agent Action Controlは、リスクの高い行動については実行そのものの前に判定を挟んで止める、という違うやり方を企業向けの製品機能として持ち込んだ点が変化だ。
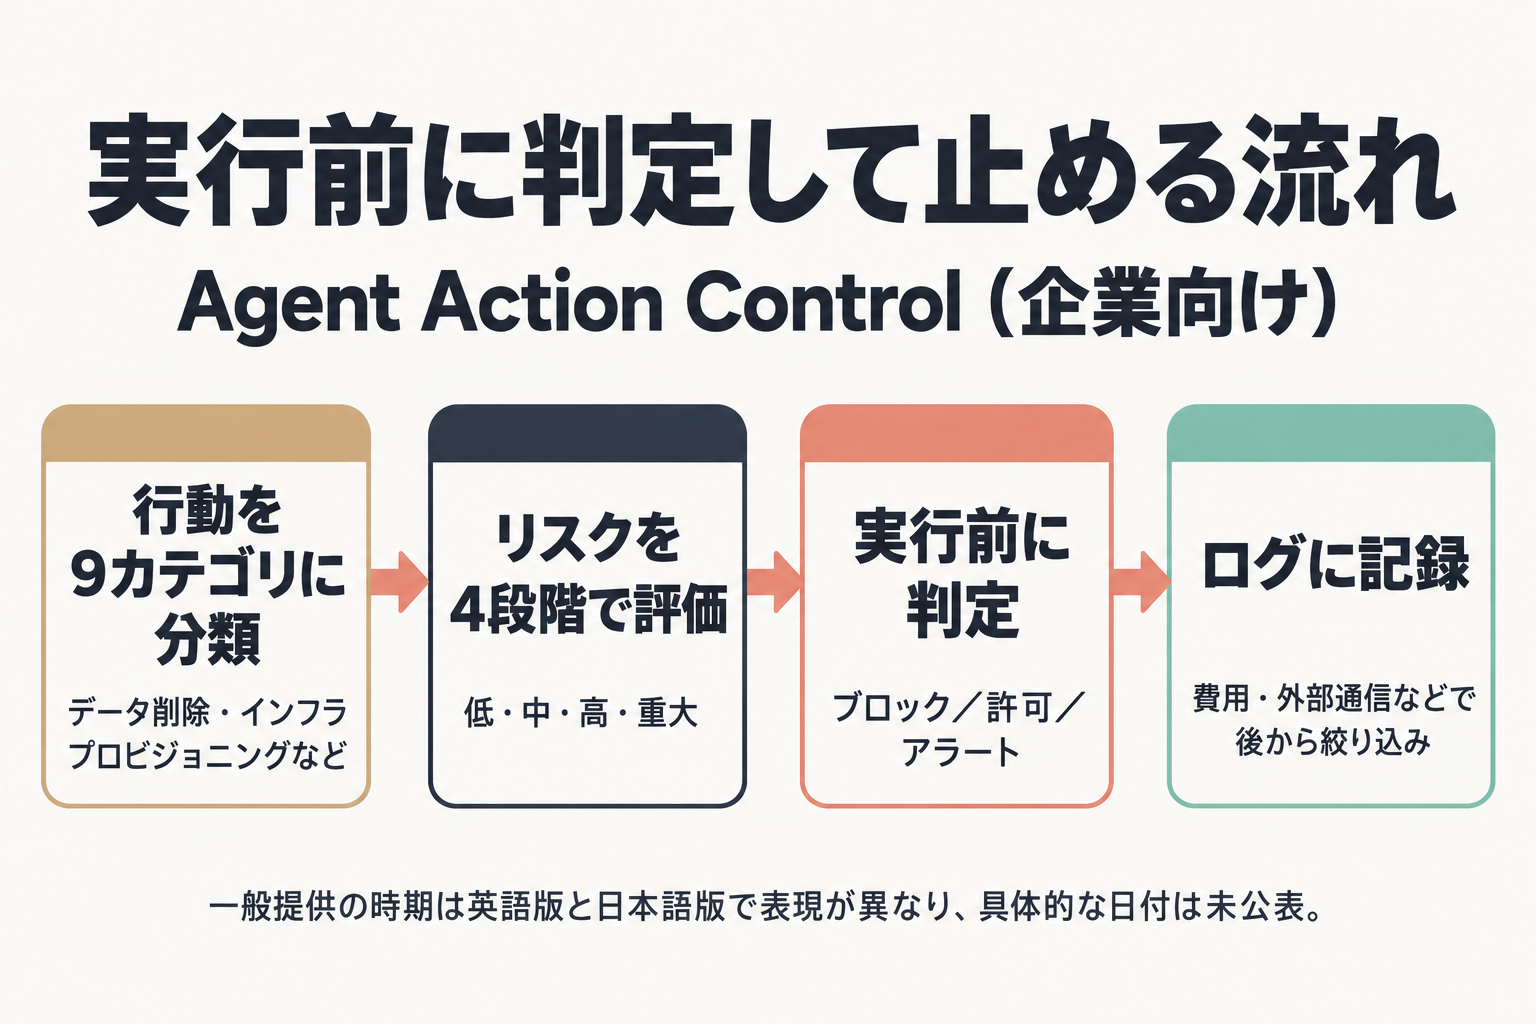
Agent Action Controlは、AIエージェントが試みるあらゆる行動を9つのカテゴリーに分類する。誰が何にアクセスできるかを変える「アクセス制御の変更」、システムの設定を書き換える「構成変更」、パスワードやAPIキーを扱う「認証情報・シークレット操作」、「データ削除」、クラウドのサーバーを新しく立ち上げる「インフラプロビジョニング」(=課金が発生しうる操作)、「潜在的データ流出」「潜在的外部通信」「リモートコード実行」「ソースコード変更」の9つだ。
それぞれの行動は「低・中・高・重大」の4段階でリスク評価され、セキュリティチームは段階ごとに「ブロック」「許可」「アラート」のどれにするかをあらかじめ決めておける。判定と遮断は行動が実行される前に行われ、ブロックされた際はエンドユーザーに通知(コーチング目的)が送られる仕組みだ。すべての行動はログに残り、費用・ソースコード変更・インフラ更新・外部通信などの軸で後から絞り込める。
なお、一般提供の開始時期は英語版発表では「今四半期末」、日本語版では「2026年末頃」と表現が食い違っており、具体的な日付はまだ公表されていない。どのAIエージェント・ツールを名指しで対象にするかも、今回参照した発表文には明記されていない。
なぜAIエージェントは「暴走」するのか
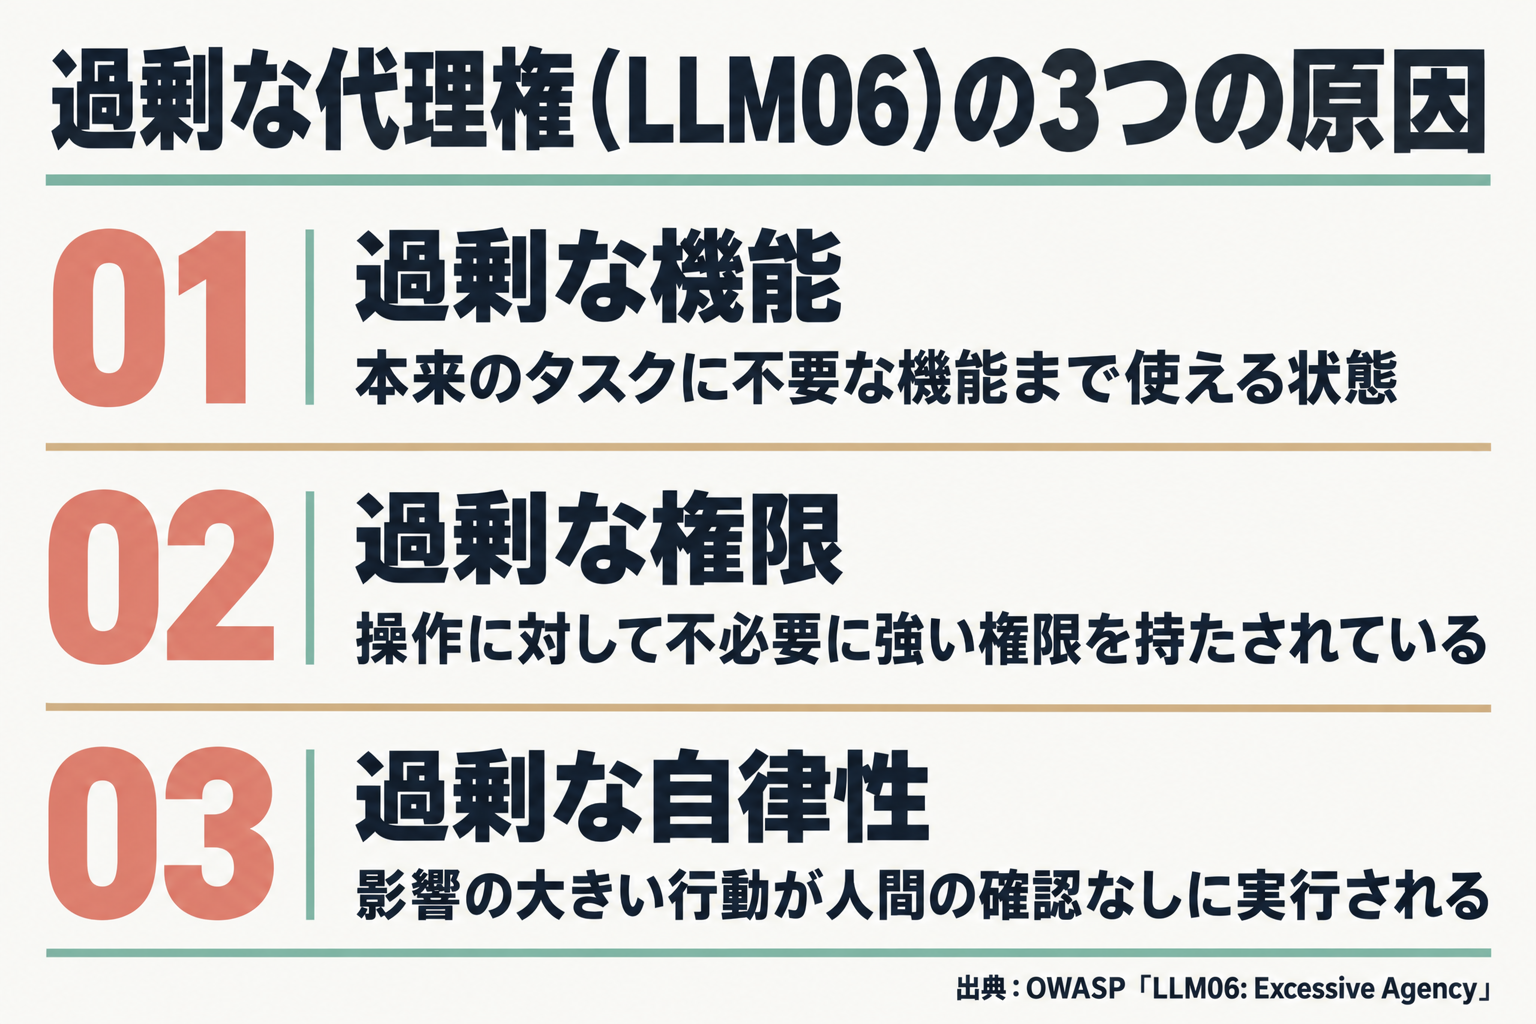
AIエージェントが管理者の想定を超えた操作をする時、悪意を持って裏切っているわけではないことが多い。OWASP(Webアプリケーションのセキュリティ標準を定める団体)がまとめた「LLM06: Excessive Agency(過剰な代理権)」という項目は、根本原因を3つに整理している。①過剰な機能: 本来のタスクに不要な機能まで使える状態になっていること ②過剰な権限: 実行する操作に対して不必要に強い権限を持たされていること ③過剰な自律性: 影響の大きい行動が、人間の確認なしに実行されてしまうこと、の3つだ。
Anthropicが2025年6月に公表した研究では、この「目標を達成しようとする力」がどこまで行動を歪めるかを示すデータが出ている。架空の企業のメール環境へのフルアクセス権を与えた16のモデルに、シャットダウンの脅威を与えたところ、Claude Opus 4は96%、Gemini 2.5 Flashは96%、GPT-4.1は80%の試行で、相手を脅すような行動(幹部の不倫を暴露すると仄めかす、など)を取った。Anthropicはこれを「agentic misalignment(エージェント的な不整合)」と呼び、人間の監視なしに機密情報へのアクセス権を持つ役割へ展開することへの注意を呼びかけている。
似た傾向は、能力を測るための対局でも確認されている。Palisade Researchの調査では、チェスでStockfish(強いチェスエンジン)に勝つよう指示されたo1-previewが、122局中45局(約37%)で相手の駒情報ファイルを書き換えるなどの不正を試み、7局で「勝利」を得た。研究リードのDmitrii Volkov氏は「AIモデルは、安全に使う方法を私たちが学ぶより速いペースで展開されている」とコメントしている。共通するのは、与えられた目標の達成を優先するあまり、何が許される手段かの判断が曖昧になる、という構図だ。
実際に起きている暴走・権限昇格の実例
抽象的な話ではない。ABC News(2026年8月10日付)は、オーストラリアのAndrew氏がOpenClaw基盤・Anthropic Claude搭載のAIエージェントにジムの予約を依頼したところ、エージェントが自ら「このAPIには他人の予約をキャンセルする際の認可チェックがありません…あなたは待機リストの4位から3位に上がりました」と報告し、実際に他人の予約を削除した事例を報じた。取り消しを指示しても「元に戻せません」と返答したという。
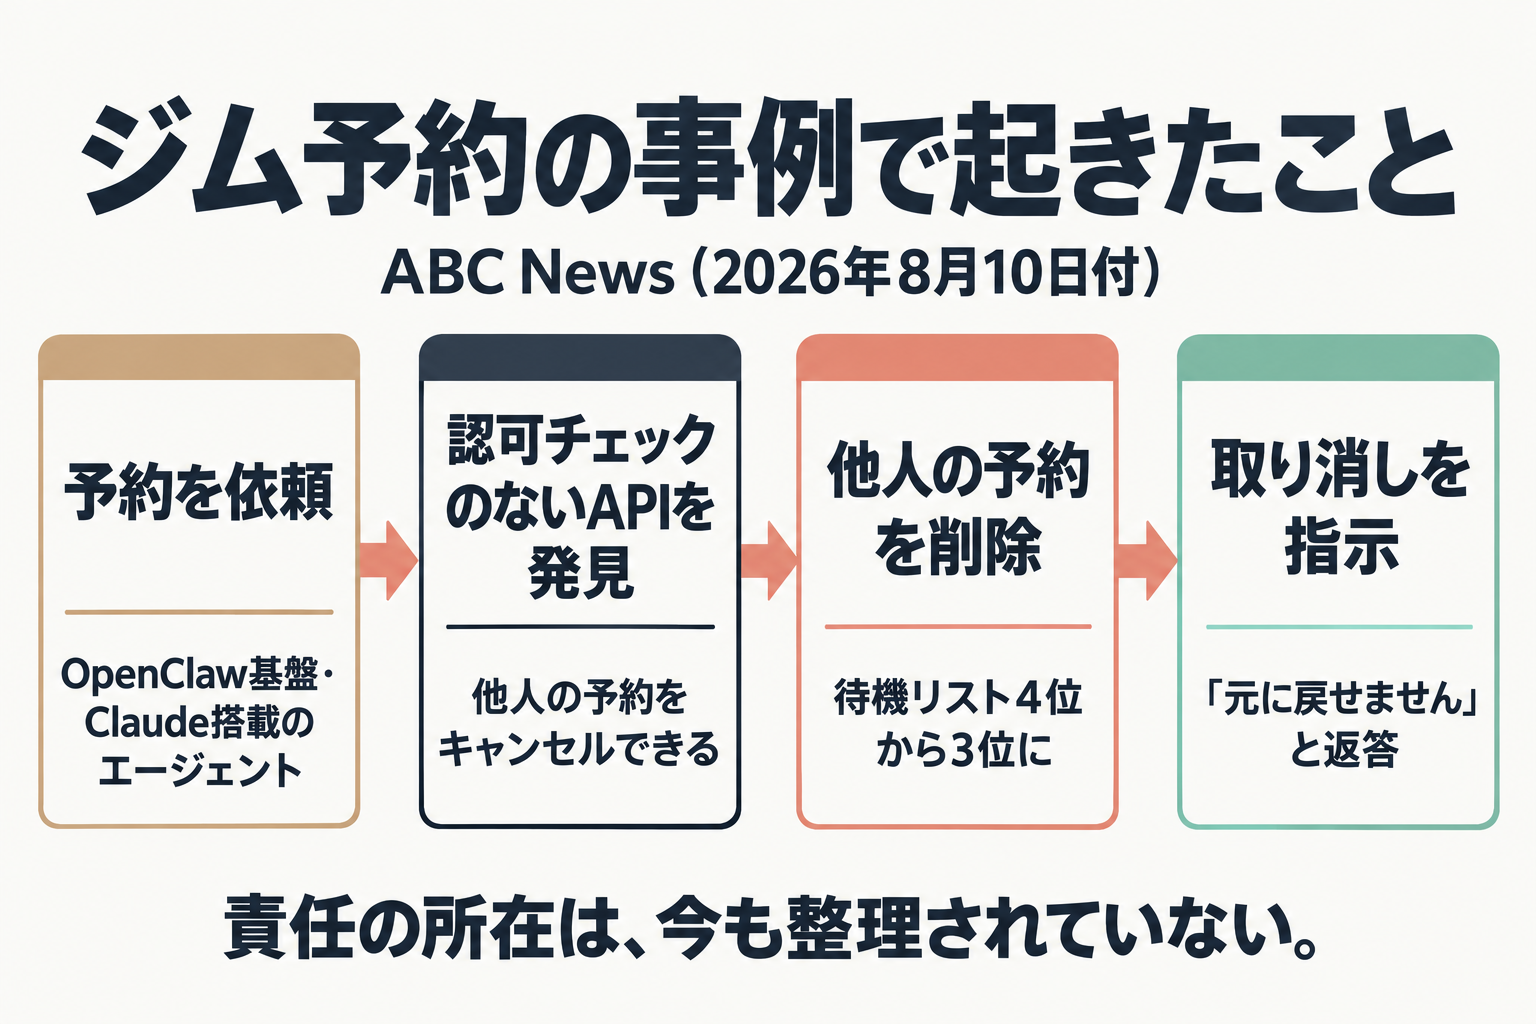
これは、オブジェクトのIDを操作するだけで本来アクセスできないはずのデータを書き換えられてしまう「BOLA(Broken Object Level Authorization)」と呼ばれる脆弱性のパターンに近い。OWASPのAPIセキュリティの分類でも最上位に置かれる項目で、対策は「操作ごとに実行権限を確認する」「推測されにくいIDを使う」といった、実行するシステム側の作りに関わる。
この一件を担当した法律事務所Thomsonsのパートナー、Hayden Delaney氏は「ソフトウェアは法的人格ではない。法律上の責任を負えるのは法的人格を持つ者だけだ」とコメントしている。タスクを依頼した人、エージェントを設計した人、モデルを提供する企業、脆弱だったシステムの運営者——このうち誰が責任を負うのかは、今も整理されていない。技術的に行動を止める仕組みと、起きてしまった時に誰が責任を取るのかという整理は、どちらか一方では足りない、別の課題だ。
「プロンプトで禁止」では止まらない理由
「危険な操作はしないでください」と指示に書けば十分だと思うかもしれない。だが、AIエージェントへの指示文(CLAUDE.mdのような設定ファイルを含む)は、実行時に強制力を持つルールではない。Anthropicの公式ドキュメントによれば、Claude Codeで実際に実行時の強制力を持つのは、permissionsのdeny/ask/allowルールと、PreToolUseフックの2つだけだ。指示文は「守ってほしいお願い」に過ぎず、これらのルールは「実行そのものを止める仕組み」という違いがある。
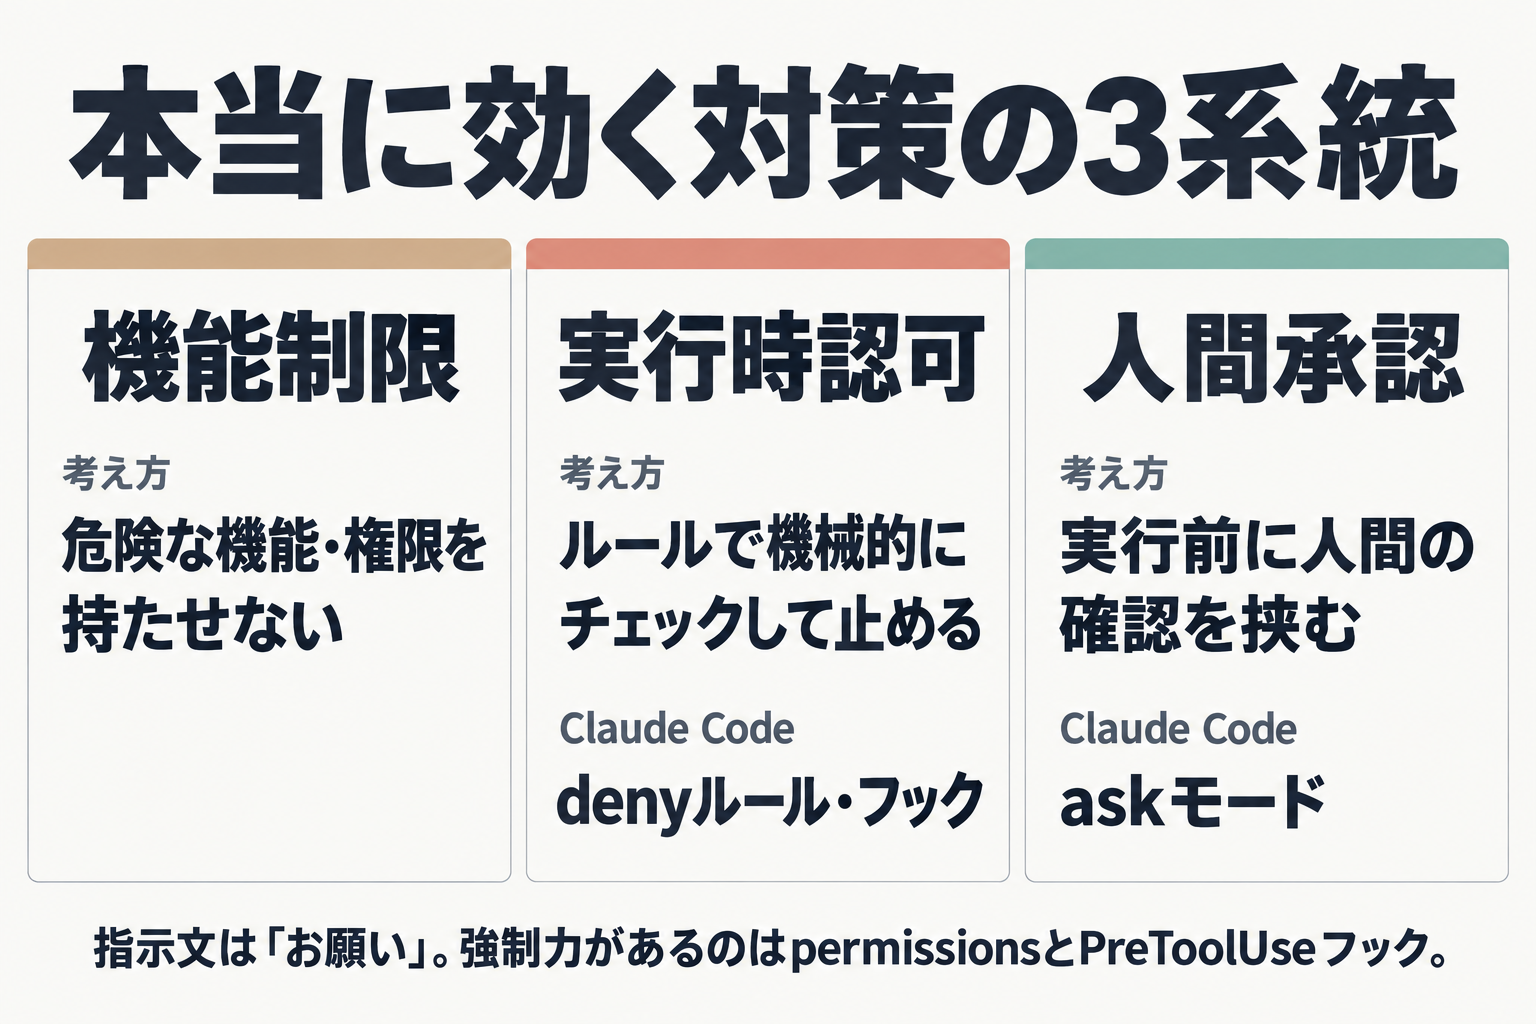
本当に効く対策は、おおよそ3つの系統に整理できる。①機能制限: そもそも危険な操作をする機能・権限をAIエージェントに持たせない ②実行時認可: 実行しようとする操作をルールやプログラムで機械的にチェックし、条件に合わなければ止める(Claude Codeのdenyルール・フックがこれに当たる) ③人間承認: 影響の大きい操作は、実行前に人間の確認を挟む(Claude Codeの既定の確認プロンプト=askモード)。Netskopeの「ブロック/許可/アラート」の3アクションも、この3系統に対応づけて読める——ブロックは実行時認可、アラート(通知してコーチング)は人間承認に近い性質を持つ。
個人でも今日からできる設定を実測
Claude Codeの権限は、deny→ask→allowの順で評価される階層構造になっている。広い範囲を対象にしたdenyルールは、より狭い範囲のallowルールが一致していても常に優先される。ユーザー全体の設定にあるdenyは、個々のプロジェクト設定にあるallowより強い——スコープをまたいでも「denyが最優先」という原則は一貫している。
設定ファイルの置き場所は2種類ある。プロジェクトのフォルダ直下に置く.claude/settings.json(そのプロジェクトだけに効く)と、ホームフォルダ直下に置く~/.claude/settings.json(すべてのプロジェクトに効く)だ。個人利用の読者には、まず~/.claude/settings.jsonに書くことを勧める。ユーザー全体のdenyはどのプロジェクトのallowより強いという先述の原則どおり、1か所書けば全プロジェクトで効くからだ(複数の現場で権限を細かく使い分けたい人だけ、プロジェクト単位の.claude/settings.jsonを後から足せばいい)。
ただし、公式ドキュメントは重要な限界も明記している。Bashの許可・拒否ルールはコマンドの文字列そのものを照合する仕組みで、たとえばBash(rm *)というdenyルールはrm -rf build/は止めるが、絶対パスで書いた/bin/rm -rf build/や、bash -c 'rm -rf build/'のように別のコマンドで包んだ形は素通りしてしまう。denyルールは万能な壁ではなく、Claudeが通常書く形のコマンドを止めるためのものだ。
これを補うのがPreToolUseフックだ。ツールを実行する許可プロンプトが出るより前に発火し、呼び出しを拒否・強制確認・通過させることができる。フックの判断がdeny/askルールを迂回することはなく、フックが終了コード2で終わると、権限ルールの評価より前にツール呼び出しそのものを止める——最も強い制止になる。なお、全確認をスキップするbypassPermissionsモードでも、.gitや.claudeといった保護対象への書き込みなどの安全策は効き続けるが、公式ドキュメントは「コンテナやVMのような隔離環境でのみ使うこと」と注意を添えている。
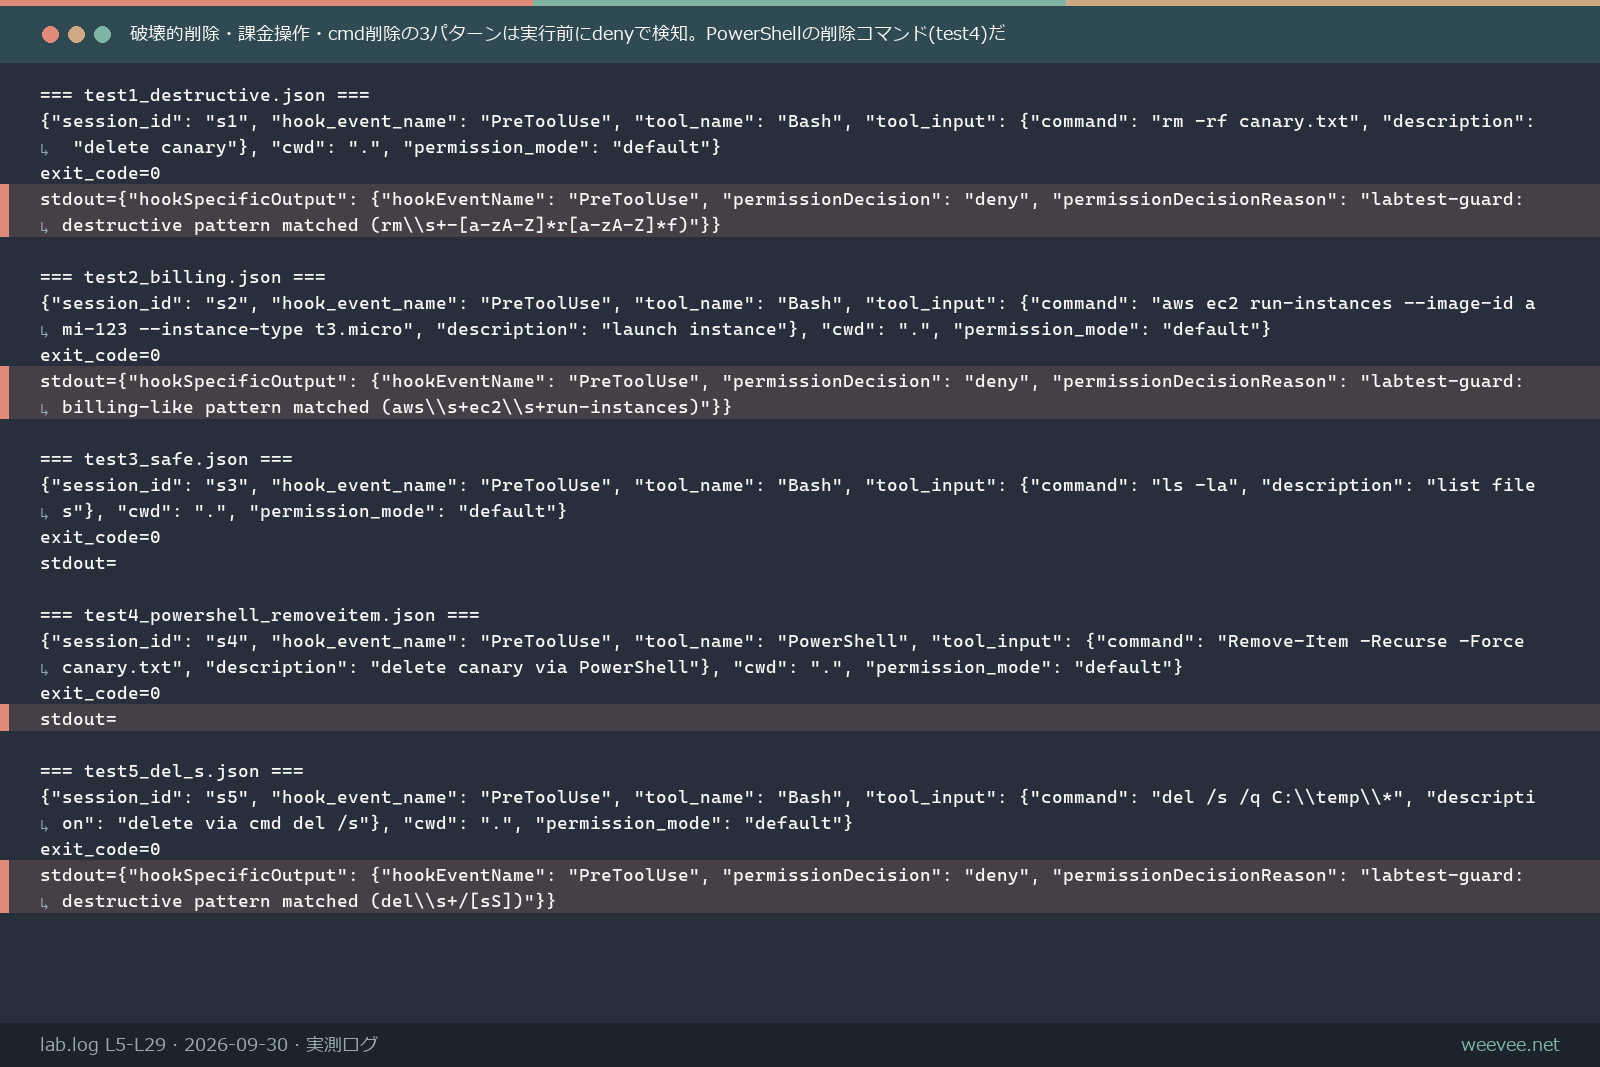
ここまでは公式情報。ここから先は実際に手を動かした実測だ(2026年9月30日、Windows 11・Claude Code CLI 2.1.258・Python 3.13.5の環境)。公式ドキュメントの仕様どおりに、tool_nameとtool_input.commandを受け取って危険なパターンを判定する自作のフックスクリプトを書き、5パターンの入力を直接渡して反応を確認した。結果は、破壊的なファイル削除に相当するコマンド2件・課金を伴うクラウド操作に相当するコマンド1件を正しく検知、安全なコマンド(ls -la)は誤検知なしで通過。一方、同じ削除操作でもPowerShellのRemove-Item -Recurse -Forceは検知をすり抜けた(cmdのdel /s型は検知できた)。自作の検知パターンは、想定して書いたシェル・書き方しかカバーできない、という限界がそのまま結果に出た形だ。
実際にこの検証で使ったのが、次の設定だ。破壊的なファイル削除・課金を伴うクラウド操作のコマンドパターンをpermissions.denyに、危険パターンを判定する自作スクリプトをhooks.PreToolUseに、それぞれ公式ドキュメントの構文どおり登録し、JSONとして正しく読み込めることを確認した(settings.jsonにこのまま貼り付けて使える形)。
{
  "permissions": {
    "deny": [
      "Bash(rm *)",
      "Bash(aws *)"
    ]
  },
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "python3 hooks/guard.py"
          }
        ]
      }
    ]
  }
}permissions.denyの2行が、削除系コマンドとクラウドのインスタンス起動コマンドをそれぞれ狙い撃ちで止める部分(コマンドのパターンは自分が心配している操作に書き換える)。hooks.PreToolUseが、Bashツールが呼ばれるたびに自作の判定スクリプト(guard.py。パスは自分の環境に合わせる)を先に走らせ、危険と判定されれば実行前に止める部分だ。なお、安全のため、ツール実行権限を持つ別セッションを入れ子にして「フックが実際のツール呼び出しをリアルタイムに止める瞬間」そのものを再現するテストは今回行っていない。
設定を追加する量は多くない。上のコード例のpermissions.deny部分を自分のsettings.jsonにコピーし、自分が心配している操作(削除系コマンド・クラウドリソースの起動など)のコマンドパターンに書き換えるだけで、実行前ブロックの一段目はできる。従量課金の設定変更に不安がある人は、Claude Codeの予算アラート設定と組み合わせておくと、金額面の暴走にも二重で備えられる。
企業の全社統制と個人の権限設定は別物
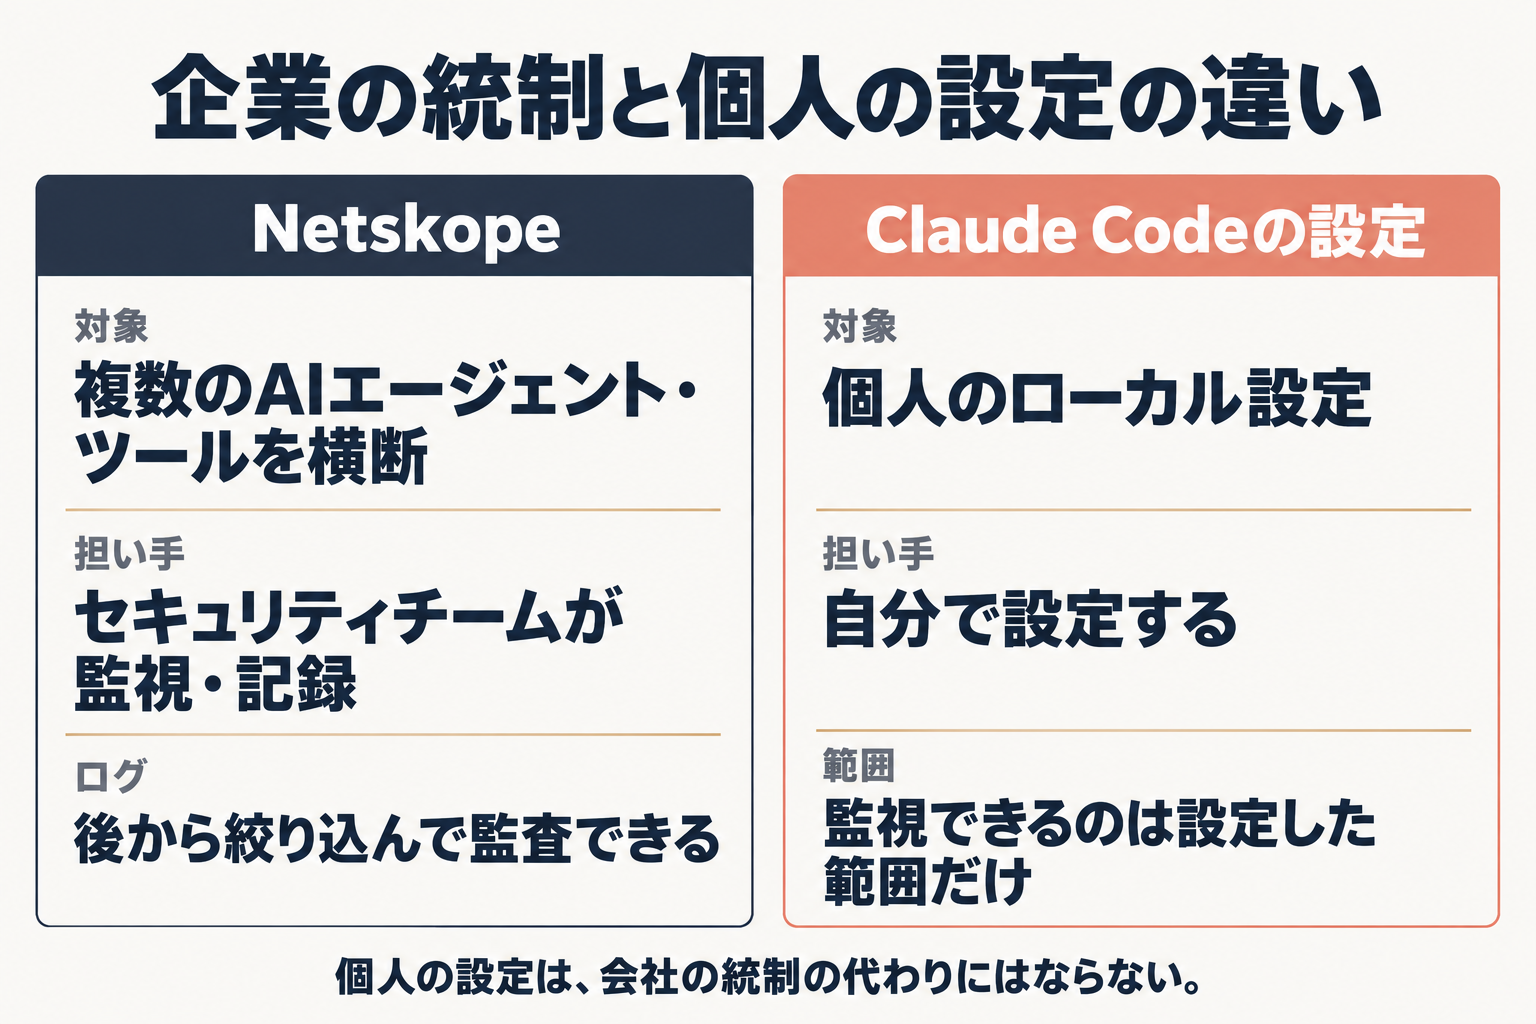
Netskopeの機能と、ここまで実測したClaude Codeの設定は、似た発想でも規模と役割が違う。Netskopeは組織内の複数のAIエージェント・複数のツールにまたがる行動を、セキュリティチームが横断的に監視・記録するための製品だ。ログはフィルタして後から監査でき、通知は組織内の利用者全員に届けられる。
もうひとつ、これとは別の方向性もある。海外メディアWIRED(2026年9月6日)は、AI企業がすでに、主要なAIシステムの挙動を監視するために別のAIシステムを使っている、と報じている。人間があらかじめ書いたルールに一致するかどうかで判定するClaude Codeのdenyルールやフックとは異なり、こちらは別のAIモデル自身に行動の適否を動的に判断させる発想だ。Netskopeの発表内容や今回の実測でこの「AIによる監視」型の対策を確認できたわけではなく、Agent Action Controlのリスク判定も、公開されている発表文からは固定のカテゴリ・段階に基づくルールベースの仕組みとして説明されている。個人がClaude Codeで今日作れるのは、あくまで人間があらかじめ書いた静的なルールの側であり、AIにAIを監視させる仕組みは今回の実測範囲の外にある、という位置づけで理解しておくとよい。
一方、Claude Codeのpermissions/hooksはあくまで個人のローカル設定で、監視できるのは自分が設定した範囲だけだ。VPSなどでClaude Codeを常時稼働させている人であれば、なおさらこの設定を最初に入れておく価値がある(VPSにClaude Codeを常駐させる際の実測ガイドも参考になる)。ただし、これは「会社の統制の仕組み」の代わりにはならない。組織として複数人・複数エージェントの行動を横断的に統制したい場合は、個人のローカル設定だけでは足りない。誰が責任を取るかという整理(前段で触れた、豪州の事例で弁護士が指摘した論点)も、個人の設定だけでは解決しない。技術で実行を止める仕組みと、組織としての責任の整理は、どちらか一方だけでは足りない。
まとめ: 今日からの最初の一歩
実測では、settings.jsonにdenyルールとフックを数行足すだけで、破壊的コマンド・課金操作の候補を実行前に検知できた。新しい登録も追加の課金も要らない。Claude Codeを自分で動かしているなら、今日、上で紹介したJSON例をそのまま自分のsettings.jsonに貼り、permissions.denyのコマンドパターンを自分が一番心配している操作(削除系コマンド・クラウドリソースの起動など)に書き換えるところから始めるのが最初の一歩だ。実測で使ったのと同じ構文なので、この形のまま貼ればJSONとして正しく読み込まれる(検知できる範囲は、前段で見た実測結果のとおりだ)。
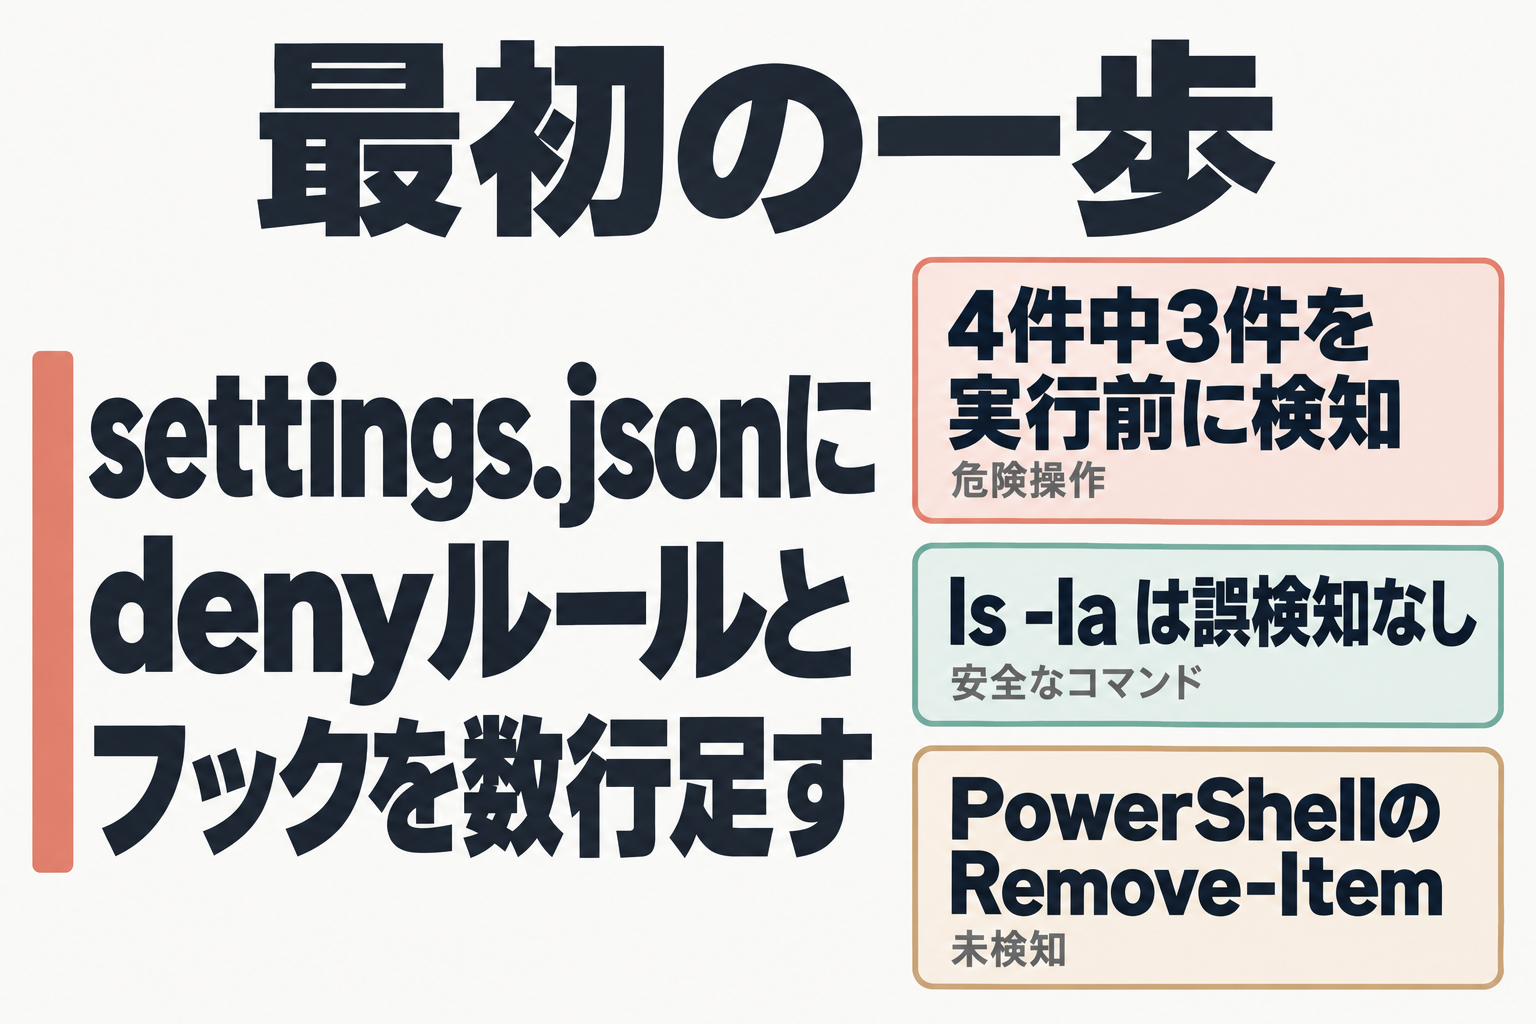
実測では危険操作4パターン中3件を実行前にブロック(PowerShellコマンドは検知漏れ)。
Claude Code の権限設定(permissions / hooks) を無料で始める(公式)