2026年9月1日、Anthropicは最上位モデル「Claude Fable 5.1」をリリースしました。Claude CodeやAPIで日常的にモデルを切り替えて使っている人に関係する話です。この記事で分かるのは、Fable 5.1が必要になるのはどんな場面かと、Opus 5・Sonnet 5との料金・性能差です。仕様は公式ドキュメントの直接照合、性能差はweeveeが3モデルに同じ課題を解かせた実測に基づきます(2026-09-02実施)。
迷ったらこれ:Fable 5.1が要る人・不要な人
推奨: ほとんどの人はOpus 5のままで十分です。 理由は3つです。

- 後述の実測では、コーディング・読解・推論のどの課題でも3モデルとも満点で、正答率に差が出ませんでした
- Fable 5.1はOpus 5の2倍の料金(入力$10 vs $5、出力$50 vs $25)で、公式のレイテンシ区分も「Slower」です
- Fable 5.1が強いのは長時間のエージェント作業や、資料の完成度を求める場面。日常のコーディングやチャットでは差が出にくい領域です
Fable 5.1が合うのは、Opus 5でエフォート設定(AIにどれだけ深く考えさせるかの強度。デフォルトはhighです)を上げても評価が伸び悩む人、長時間のエージェント作業やドキュメント作成を任せたい人です。
実測:3モデルに同じ課題を解かせてみた
公式発表のベンチマークだけでなく、weevee自身でも3モデル(Fable 5.1・Opus 5・Sonnet 5)にテキスト専用の実行で同じ課題を解かせて比較しました。課題は次の3つです。

- コーディング: バグを3箇所仕込んだPython関数を渡し、テストが通る修正だけを出力させる
- 読解: 約7,700字の文書に事実を5つ分散配置し、5問の一問一答で正答数を採点する
- 推論: 正解が一意に決まる論理パズルを解かせる
各課題を3モデル×2回、計18回実行しました。
| タスク | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|
| コーディング(秒) | 10 / 8 | 7 / 7 | 10 / 16 |
| 読解(秒) | 10 / 15 | 8 / 7 | 6 / 6 |
| 推論(秒) | 9 / 11 | 9 / 12 | 15 / 13 |
正答率は3モデル・全18回とも100%(コーディングはpytestで4/4合格、読解は5/5正解、推論は一意解と完全一致)。今回のような難度の課題では、モデル間の正答率の差は検出できませんでした。
差が出たのは所要時間だけですが、こちらも公式のレイテンシ区分(Fable 5.1「Slower」<Opus 5「Moderate」<Sonnet 5「Fast」)通りのきれいな序列にはなりませんでした。Sonnet 5がコーディングで16秒、推論で15秒とFable 5.1より遅くなる回もあり、数十秒規模の短いタスクでは公式区分ほどの体感差は出にくいというのが実測から言えることです(試行回数2回×3課題のため、傾向として断定できるほどのサンプル数ではありません)。
つまり、「Fable 5.1のほうが賢い」という差は、今回程度の難度の課題では体感できません。Fable 5.1の価値は、今回試したような数十秒で終わる単発タスクではなく、公式が想定する長時間のエージェント作業や複雑な推論で発揮されると考えられます。
Mythos 5.1との違い
「Claude Mythos 5.1」という名前も同時に見かけますが、これは招待制の別ルートです。「Project Glasswing」という取り組みの参加組織だけが使え、仕様・料金はFable 5.1と完全に同じです。一般ユーザーがAPIやClaude Codeで使えるのはFable 5.1のほうです。
料金・仕様の横並び比較
| モデル | コンテキスト窓 | 最大出力 | 入力(MTok) | 出力(MTok) | レイテンシ | 知識カットオフ |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 | $50 | Slower | 2026年6月 |
| Claude Opus 5 | 1M | 128K | $5 | $25 | Moderate | 2026年5月 |
| Claude Sonnet 5 | 1M | 128K | $2 | $10 | Fast | 2026年1月 |
| Claude Haiku 4.5 | 200K | 64K | $1 | $5 | Fastest | 2025年2月 |
出典: platform.claude.com/docs/ja/models/fable-5-1/overview(2026-09-02確認)
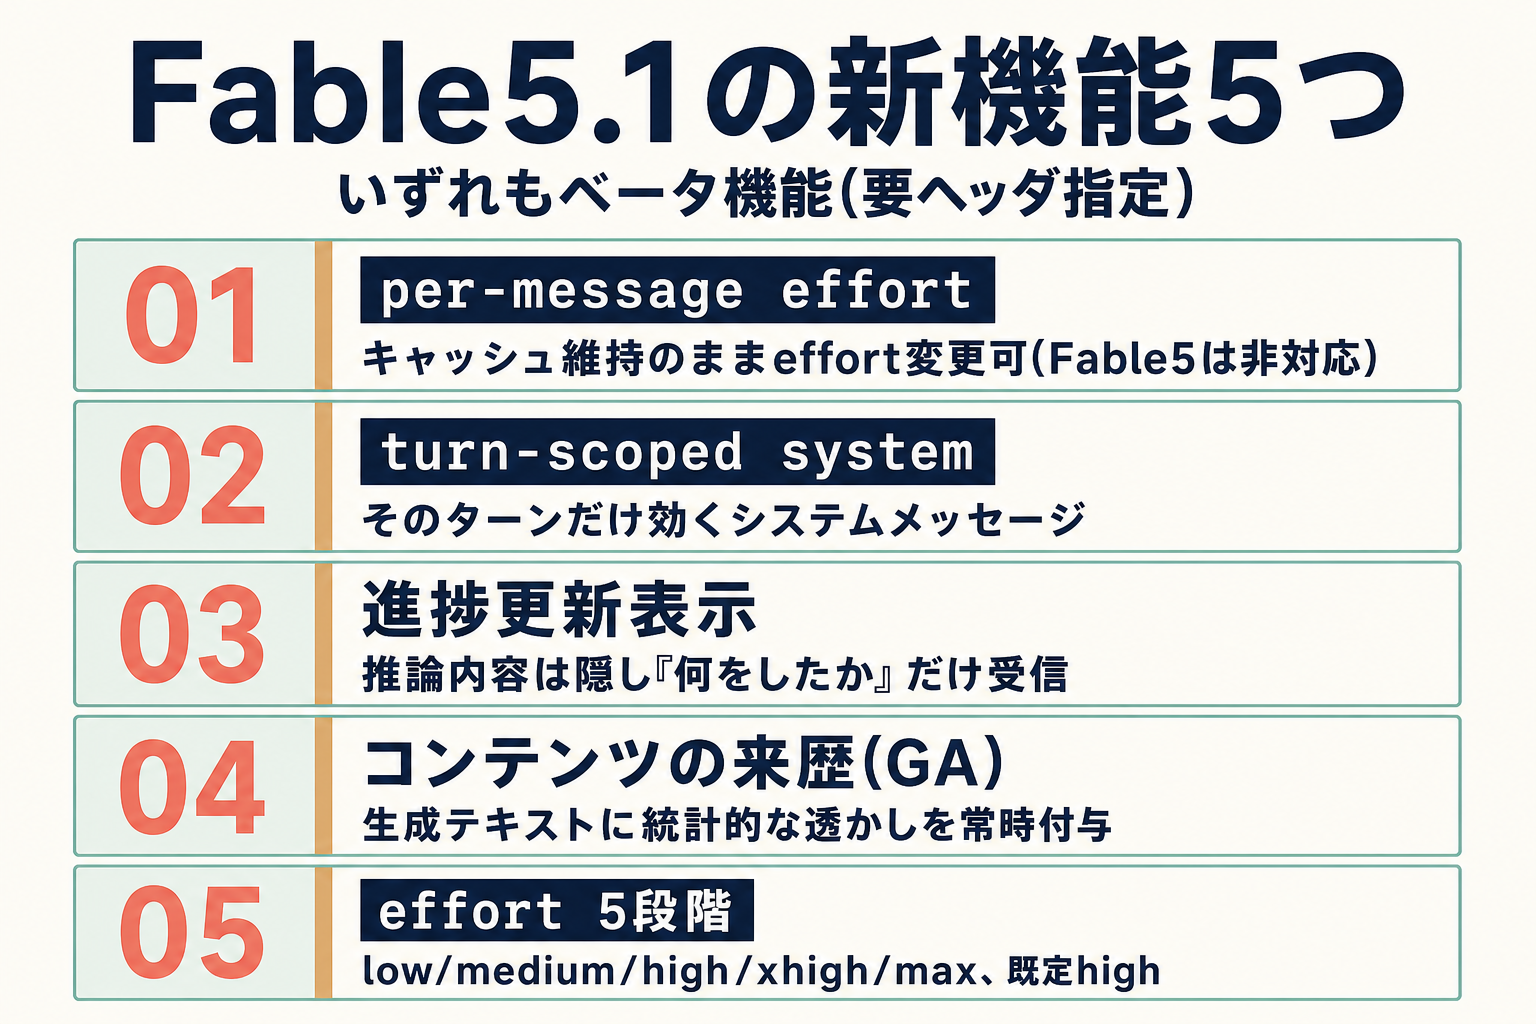
Fable 5.1で唯一Fable 5から変わったのはキャッシュ読み取り価格です。基本入力価格の2.5%($0.25/MTok)に引き下げられ、他モデルの標準(10%)より安くなっています。入出力の基本価格はFable 5と同額のまま据え置かれています。バッチAPI(即時性を求めない処理向けの割引経路)を使うと入出力とも通常価格の50%になります。
使い始めの最短手順
Claude Codeでモデルを切り替える方法は次の通りです。

- セッション中に
/model claude-fable-5-1と入力する(引数なしで一覧から選ぶピッカーも起動できます) - 起動時に
claude --model claude-fable-5-1を指定する
現在のモデルは /status で確認できます。なお、この切り替え操作の画面そのものは本記事では確認していません。上記は公式ドキュメントの記述に基づく手順です。
よくある勘違い
「Fable 5.1はまだ噂の段階」: リリース直前まで「公式に5.1という記述はどこにもない」とする見方もありましたが、現在は公式ドキュメントと公式アナウンスの両方で存在と仕様が確認されています。
「予算を指定すれば思考の量を絞れる」: Fable 5.1は思考モードが常時オンで、旧来の budget_tokens 指定はエラーになります。思考量をコントロールしたい場合はエフォート設定(デフォルトはhigh)を使います。
次の一歩
Fable 5.1を試すのに追加登録は不要です。既存のAPIキーやClaude Codeのセッションでモデルを切り替えるだけで使えます。今回の実測が示す通り、日常のタスクでは体感差が小さいので、まずは普段使っているタスクをそのまま投げて料金と速度の違いを見るのが手軽な確認方法です。
Claude Codeをリモート環境で使っている方は、こちらの記事も参考になります → Claude CodeをVPSでリモート操作する方法
もっと詳しく

公式発表のベンチマーク(Anthropic公式発表・引用)
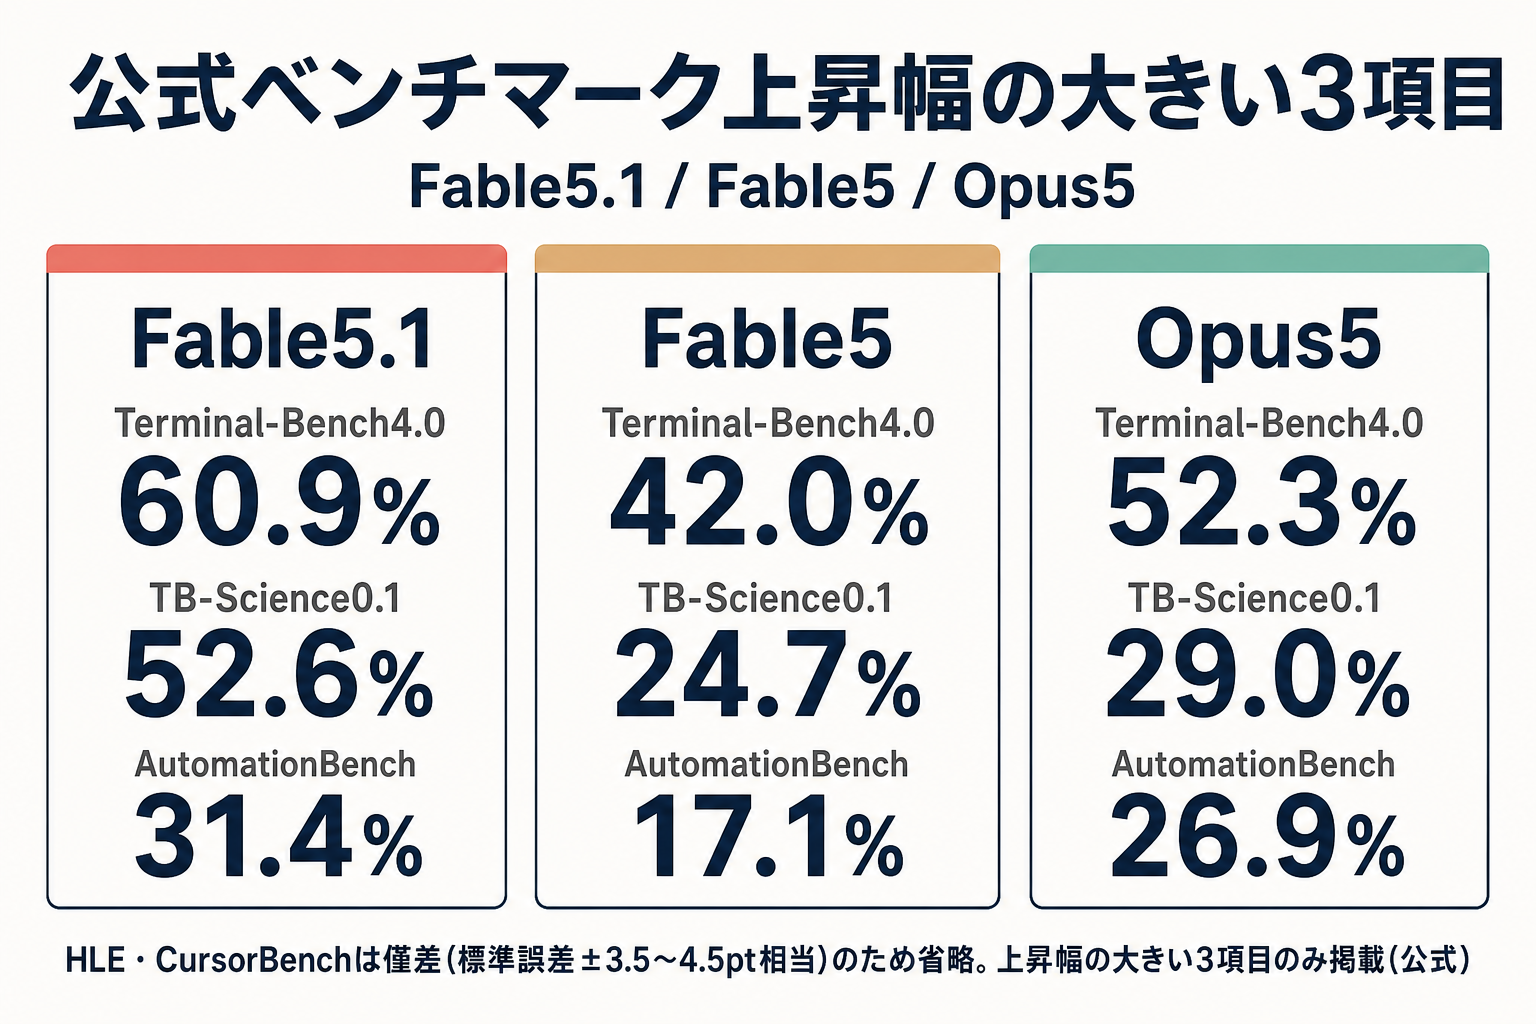
Anthropicの発表では、Terminal-Bench 4.0でFable 5.1が55.8%(Fable 5は42.0%)、専門知識を問うTerminal-Bench-Science 0.1でFable 5.1が52.6%(Fable 5の2倍以上のスコア)と報告されています。出典はAnthropic公式Xアカウント(@claudeai)の発表投稿および公式アナウンス(anthropic.com/claude-fable-and-mythos-5-1、2026-09-02確認)です。
あわせて、サイバーセキュリティ分野での安全対策の誤介入が平均約60%減、生物学分野の過剰反応が約85%減少したとAnthropicは説明しています。
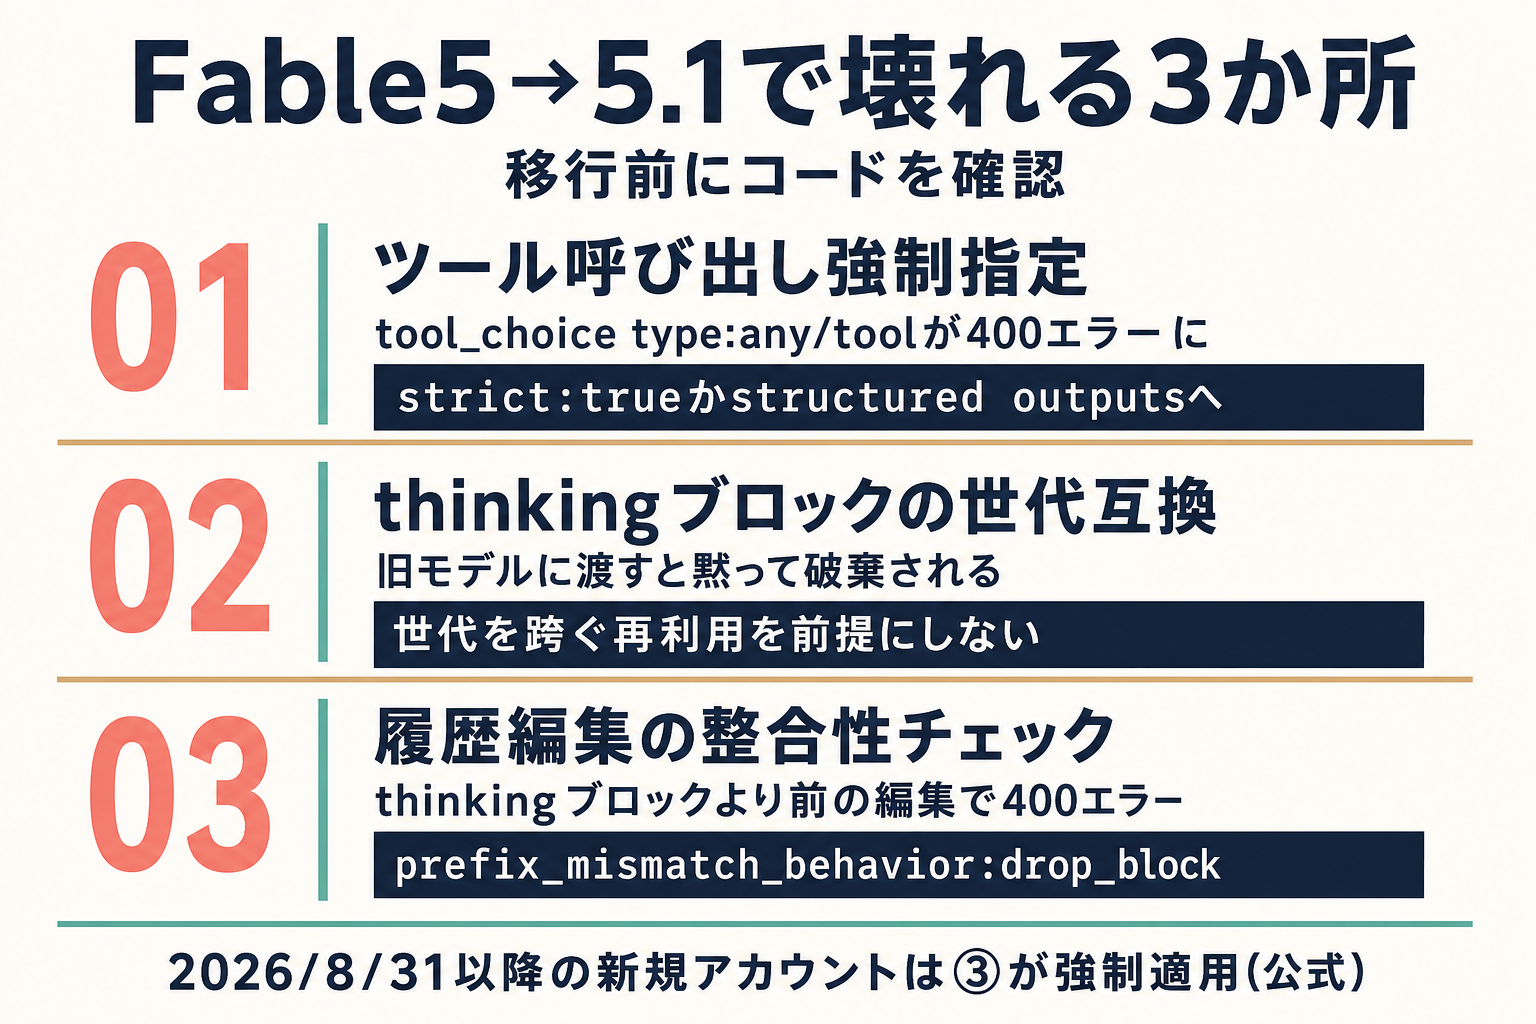
API利用者向けの主な変更点
- 思考モードは常時オンで、強制的なツール指定(
tool_choiceのany/特定ツール名)は400エラーになります - Fable 5.1が生成した思考ブロックは旧モデルでは読み取れません(モデルを跨ぐ場合は自動的に削除されます)
- データ保持期間は30日間必須で、明示的な許可がない限りゼロデータ保持では利用できません