ElevenLabsは2026年9月29日、新しい音声合成モデル「Eleven v4」と、低遅延版の「Eleven v4 Turbo」を発表した(プレスリリースは同日10:30配信、公式ブログの投稿日は9月28日)。音声合成(TTS = テキストを音声に変換する技術)は、これまでもナレーションや音声エージェントの読み上げに使われてきた分野だ。
今回の核心は、公式が「これまでで最も表現力豊かなモデル」「ボイスアクターのように台本を読む」と説明している点にある。つまり、誰が話しているか・直前に何が起きたか・各セリフをどう届けるべきかを踏まえて、声の表情をAIが判断する方向に進んだということだ。
関係するのは、ナレーションや音声コンテンツを作る人、カスタマーサポートの音声応答・音声エージェントを開発する人、動画やポッドキャストの制作でAI音声を使う人。この記事は公式発表・公式ドキュメント・第三者ベンチマーク(Artificial Analysis)の記載を一次ソースで確認して整理した内容で、実際にサインアップしての音声生成は行っていない。
迷ったらこれ: 声の表現力を優先するナレーション・オーディオブック制作はEleven v4、応答速度を優先する音声エージェント・カスタマーサポートはEleven v4 Turboが候補になる(公式情報)。無料プランでも毎月1万クレジット(音声生成のたびに消費するポイント)まで使える。今日できる最初の一歩は、公式サイトでデモ音声を聴いて自分の用途に合うか確認すること(詳しくは記事末尾)。
Eleven v4・v4 Turboとは何か
Eleven v4は「まったく新しいアーキテクチャ」(音声を生成する仕組みの土台)で構築されたモデルで、公式は「これまでで最も表現力豊かなモデル」と位置づけている。誰が話しているか・直前に何が起きたか・各セリフの届け方を理解するとされ、感情やオーディオイベント、臨場感のあるサウンドスケープを重ねた音声を作れるとしている。
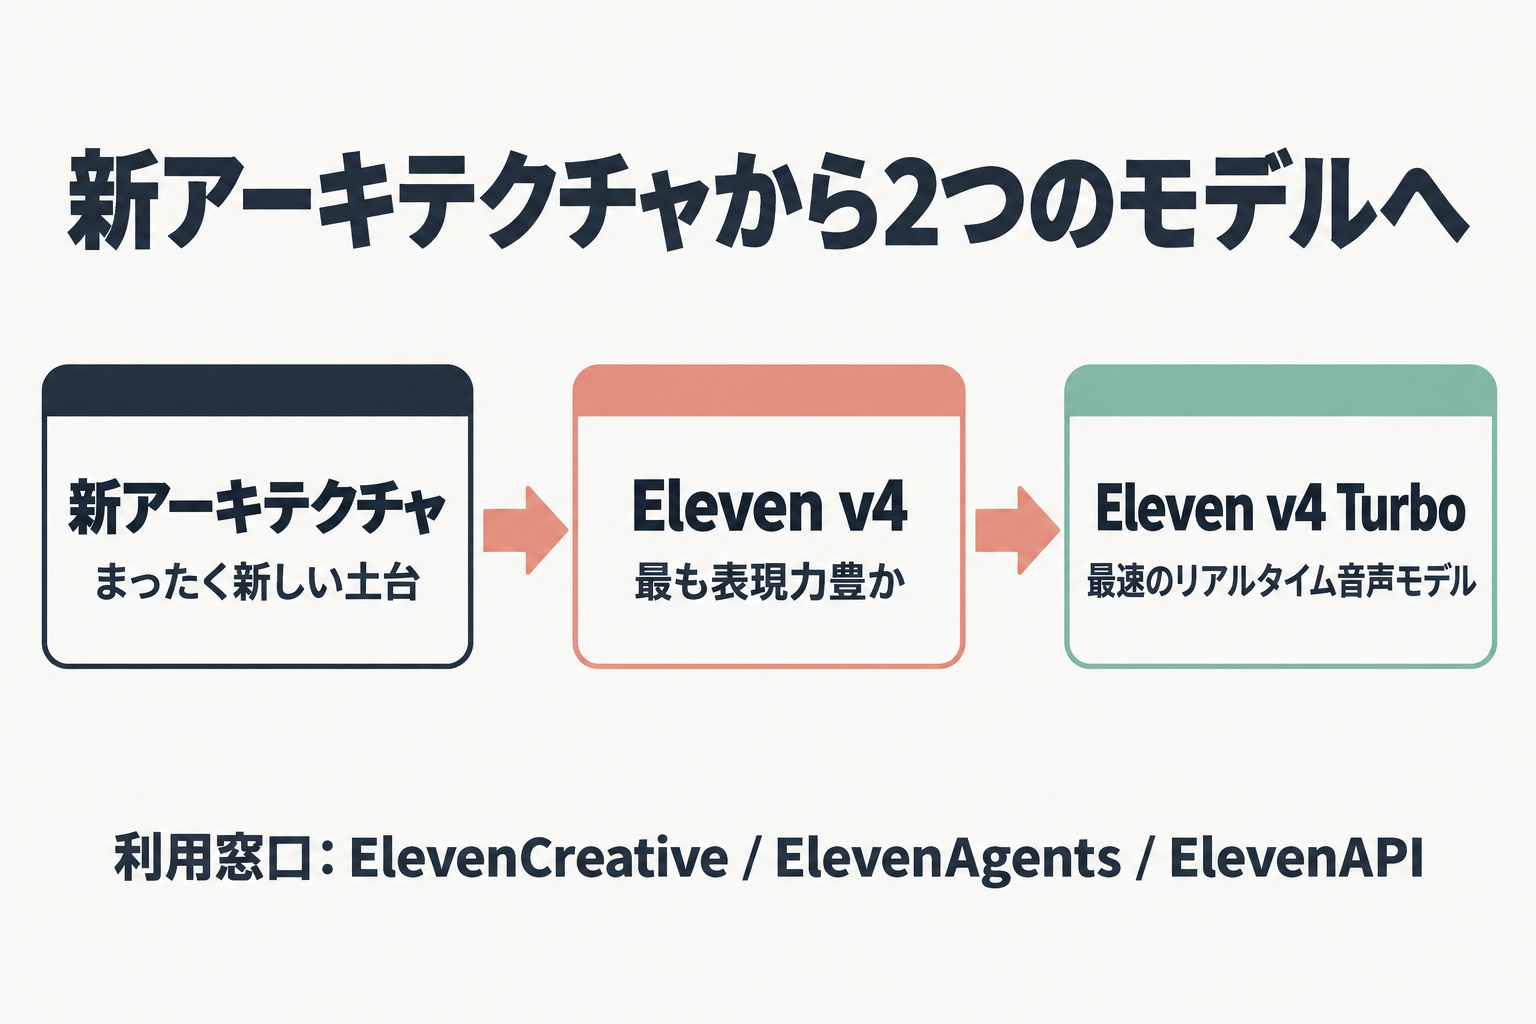
Eleven v4 Turboは「Eleven v4の表現力を備えた最速のリアルタイム音声モデル」で、APIと後述のElevenAgentsで利用できる。
両モデルは、クリエイター向けの「ElevenCreative」、音声エージェント向けの「ElevenAgents」、開発者向けの「ElevenAPI」という3つの製品面で利用できる。どの窓口から使うかは用途で変わる。
v3以前との違い:何が変わったか
現行モデル「Eleven v3」以前と比べて何が変わったのかを、公式ドキュメントの記載で整理する。
演出指示タグへの追従性が上がった
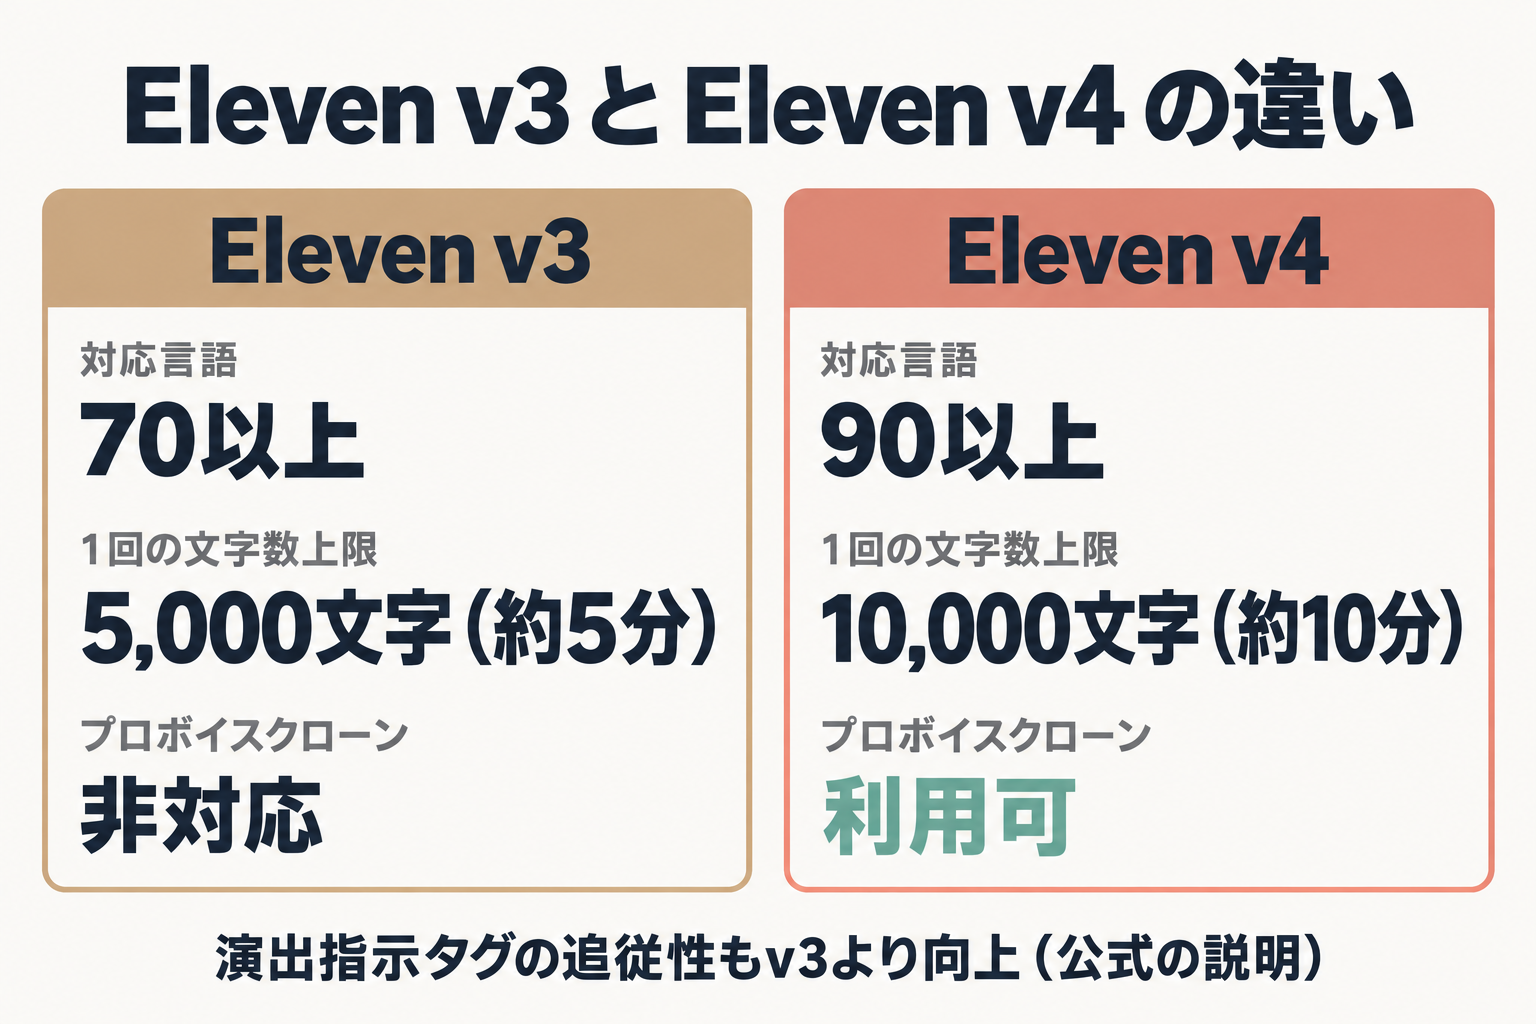
以前のモデルにも、台本に[laughs](笑う)[whispers](ささやく)[door slams](ドアが閉まる音)のような演出指示タグを書き込む機能があった。Eleven v4は、このタグが連続する場面でもv3より確実に指示に従うようになったと公式は説明している。あわせて、誰が話しているか・直前に何が起きたかを踏まえて声の届け方を判断するともしており、タグを書かなくても文脈から声の表情を補う方向に進んでいる。
対応言語が70以上から90以上に拡大
Eleven v3は70以上の言語に対応していたが、Eleven v4・v4 Turboはともに90以上の言語に対応する(公式ドキュメントのモデル一覧ページで確認)。
1回に生成できる文字数が2倍に
1リクエストあたりの文字数上限は、Eleven v3が5,000文字(約5分の音声)だったのに対し、Eleven v4は10,000文字(約10分の音声)まで増えた。
プロフェッショナルボイスクローンが復活
より高い再現性を狙う「プロフェッショナルボイスクローン」は、Eleven v3では非対応だったが、Eleven v4で再び利用できるようになった。
このほか、「コンテキスト接続」によってどんな長さの台本でもペースと話し方を安定して保つとされ、同じ文を50回やり直しても同じ人物が話しているように聞こえる、という声質の安定性も公式は訴求している。長尺のオーディオブックや、複数話者が登場する台本でも活用しやすい設計だ。
数字で見る性能:遅延・対応言語・第三者評価
Eleven v4 Turboの応答速度について、英語版の公式サイト・公式ブログは「推論レイテンシー(音声を作るのにかかる処理時間)の中央値は約100ミリ秒、最初の音声が出るまでの時間(発話開始までの時間)の中央値は約150ミリ秒」と、2つの指標を区別して記載している。
一方、日本語版の公式ページでは「推論レイテンシーの中央値は約150ミリ秒」「発話開始までの時間は中央値150ミリ秒」と、どちらも150ミリ秒と表記されている(2026年9月29日確認時点)。プレスリリースでは「音声が出るまでのモデル推論時間は中央値で約100ミリ秒」という表現も使われており、数値を比較する際はどのページ・どの指標を見ているかに注意したほうがよい。
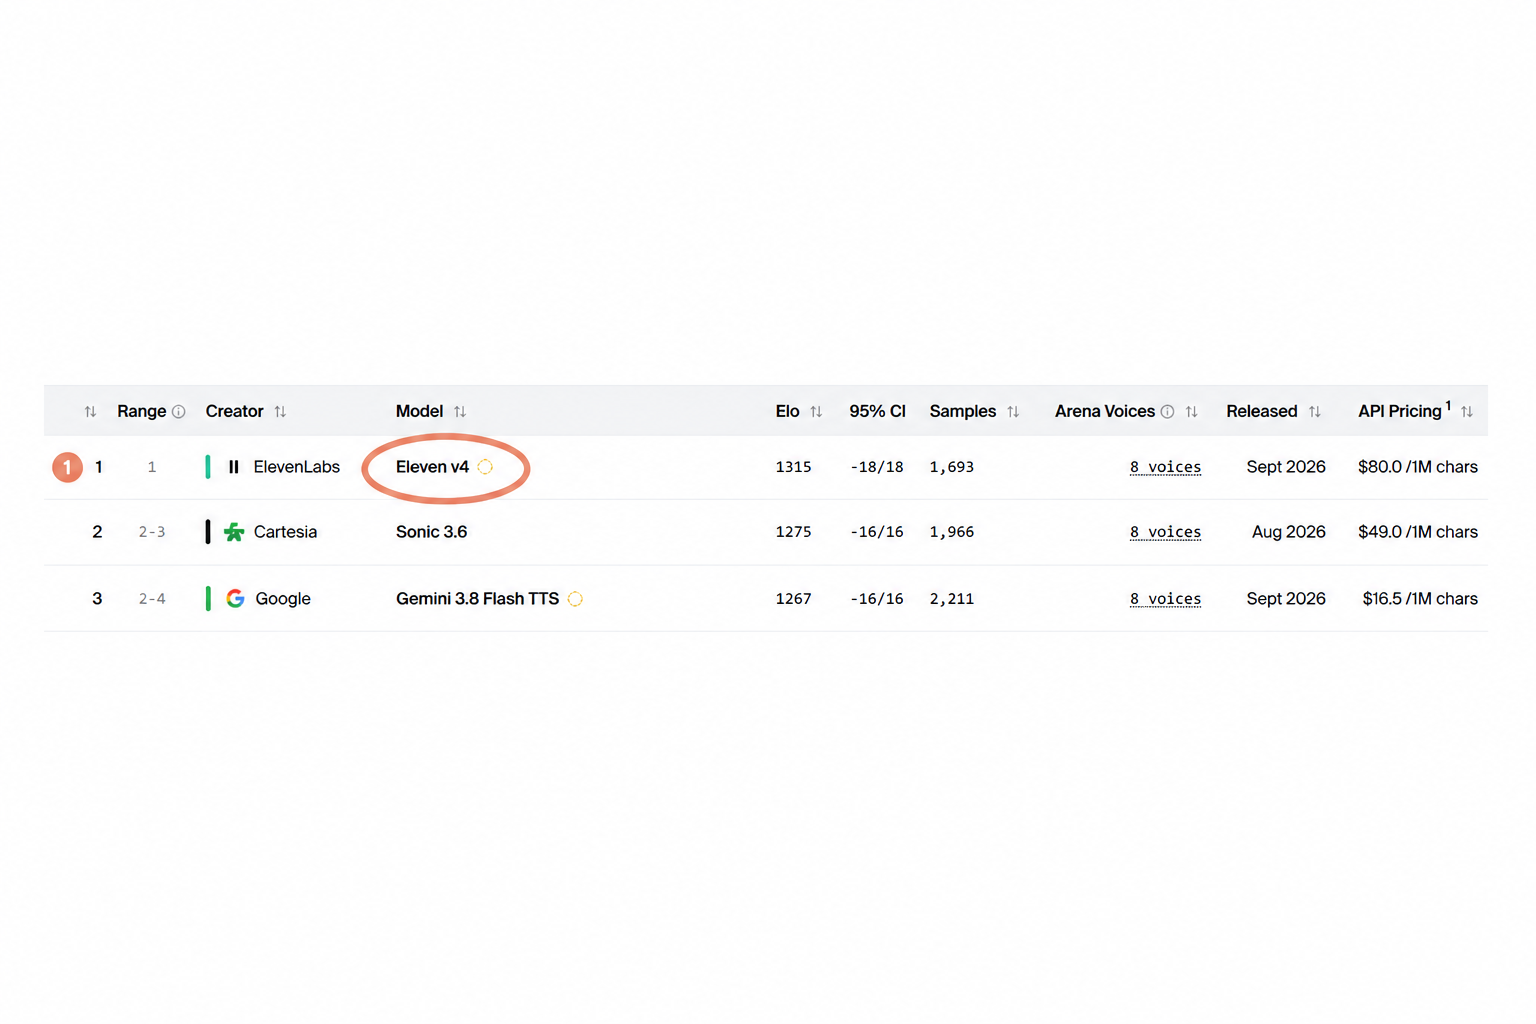
第三者機関Artificial Analysisが運営する「Provider Voice TTS Arena」(同一テキストから生成した2つの音声をユーザーが聴き比べ、より自然な方を選ぶブラインド方式の評価。Eloは対戦成績から算出する強さの指数)では、Eleven v4が1位。Elo 1315(95%信頼区間±18、比較件数1,693件、2026年9月公開、API価格は100万文字あたり80.0ドル)で、2位のCartesia Sonic 3.6(Elo 1275、$49.0/100万文字)、3位のGoogle Gemini 3.8 Flash TTS(Elo 1267、$16.5/100万文字)を上回った(2026年9月29日確認時点のスナップショットで、投票の蓄積により順位・数値は変動する)。
v4とv4 Turboの使い分け
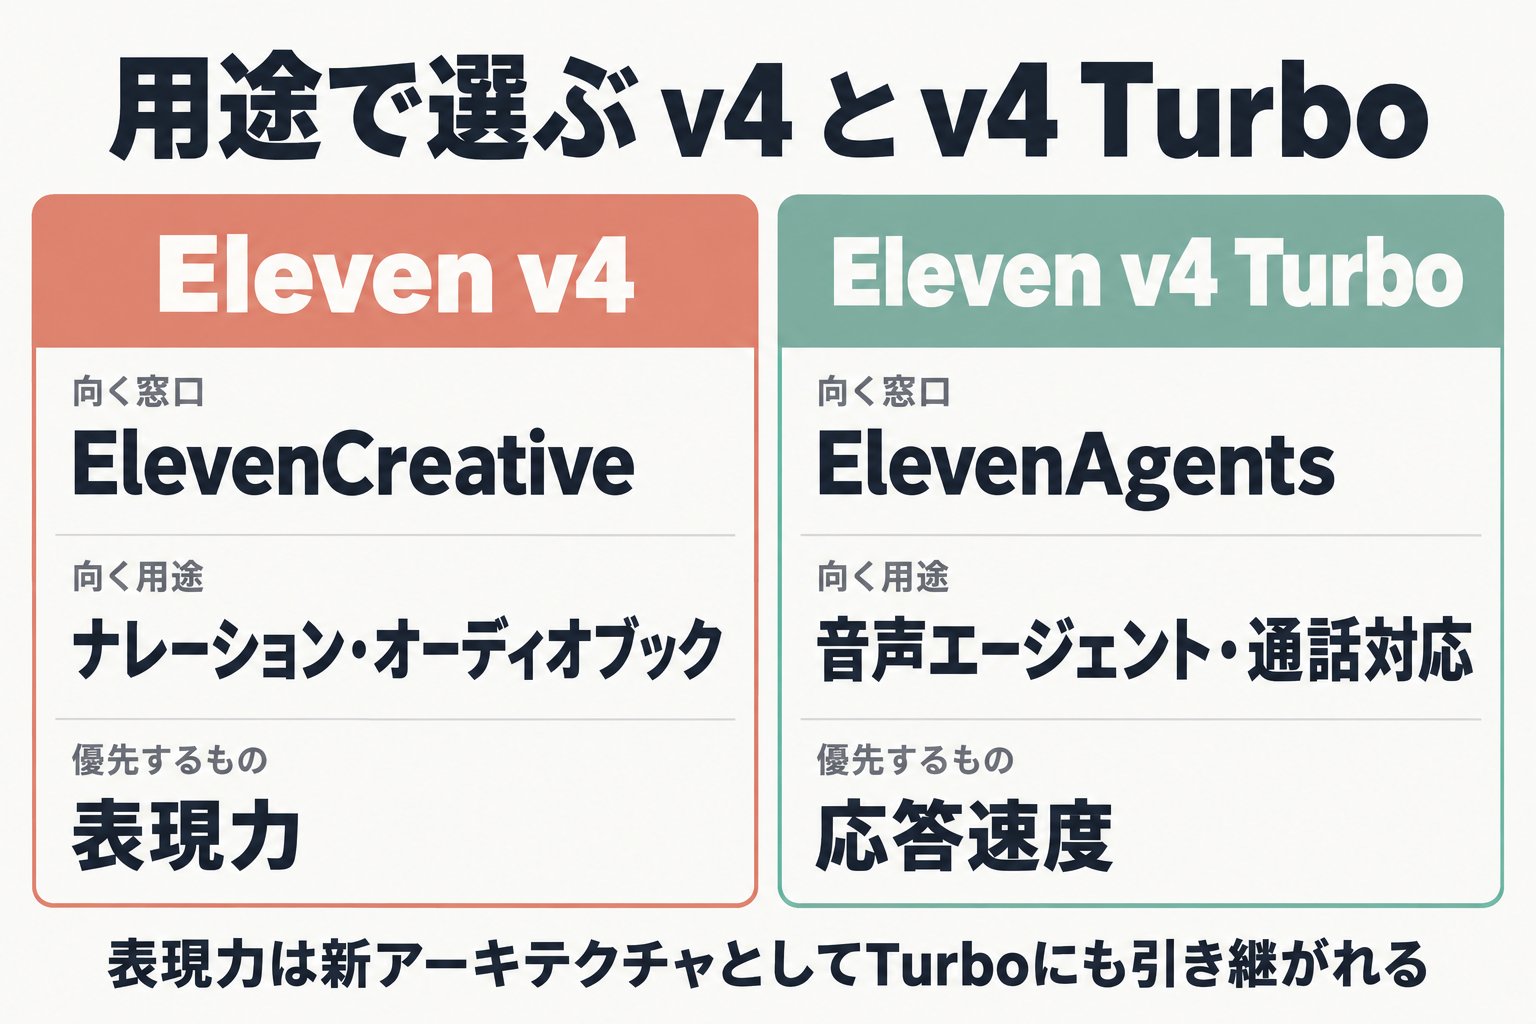
用途で分けると分かりやすい。Eleven v4はElevenCreative向けで、ナレーションやオーディオブックなど時間をかけて作り込む非リアルタイムのコンテンツ制作で表現力を優先するモデル。Eleven v4 TurboはElevenAgents向けで、音声エージェントや通話対応などリアルタイムの対話で応答速度を優先するモデルだ。どちらも同じ新アーキテクチャがベースで、表現力そのものはTurboにも引き継がれている。
音声クローニング機能
声を再現する機能は2種類ある。
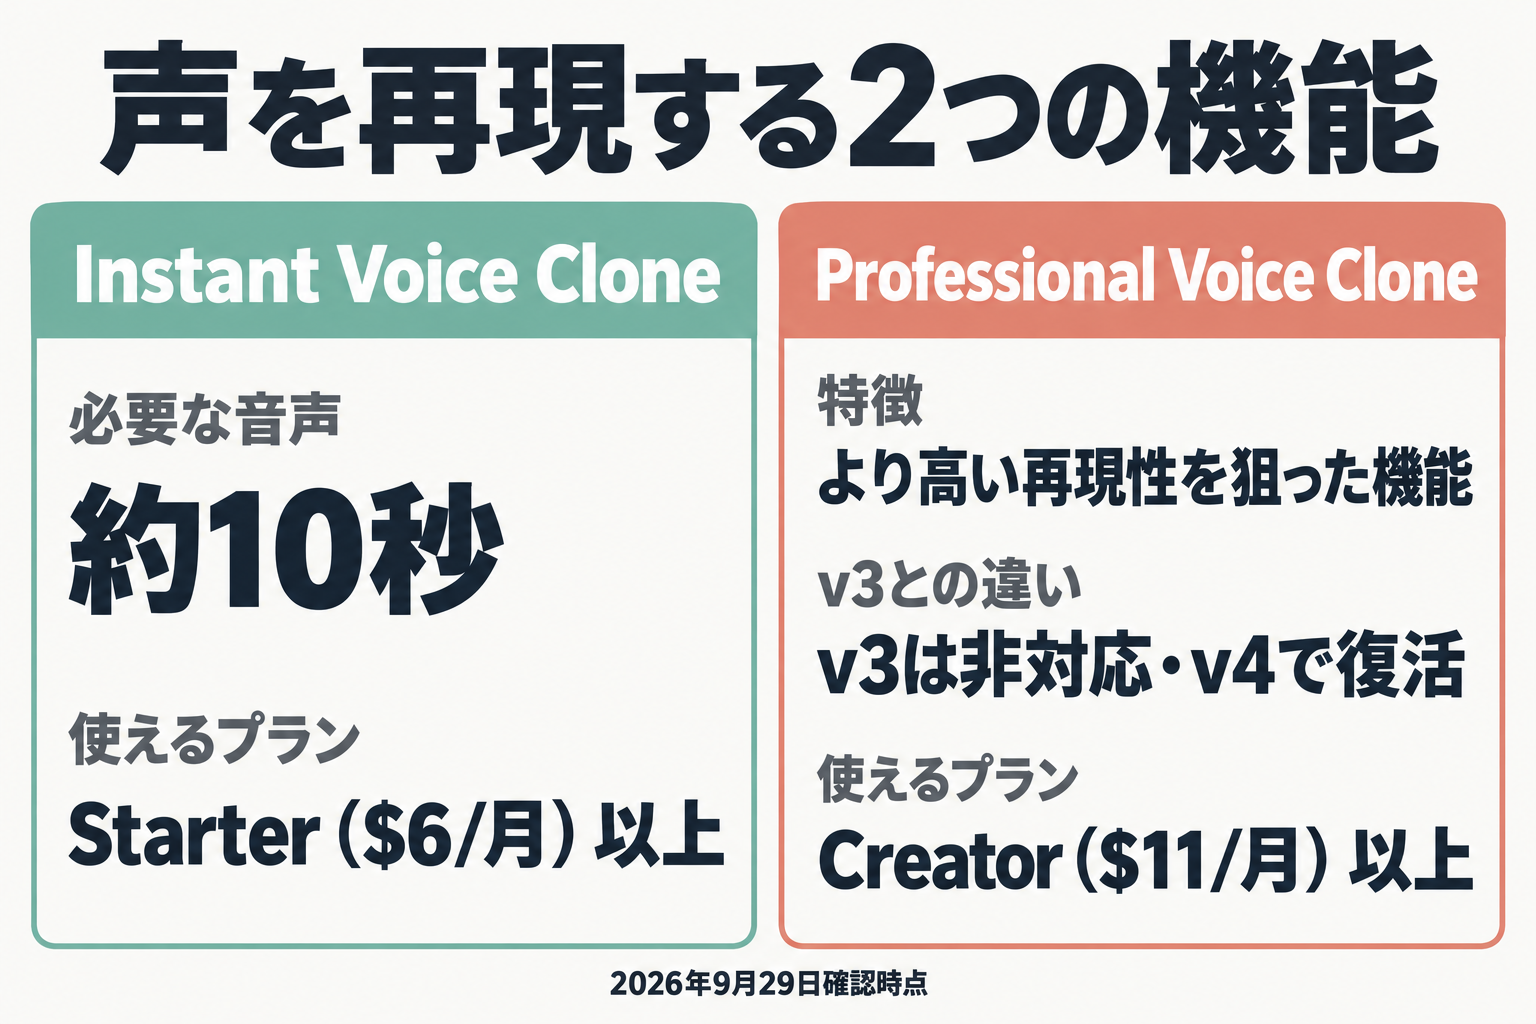
- Instant Voice Clone: 約10秒の音声から声を再現できる
- Professional Voice Clone: より高い再現性を狙った別機能(前述のとおりv3では非対応・v4で復活)
料金・提供形態
ElevenCreativeの月額プランは次のとおり(2026年9月29日確認)。
| プラン | 月額 | クレジット/月 |
|---|---|---|
| Free | $0 | 10,000 |
| Starter | $6 | 30,000 |
| Creator(Popular表示) | 初月$22・以降$11 | 121,000 |
| Pro | $99 | 600,000 |
| Scale | $299 | - |
| Business | $990 | - |
| Enterprise | 個別見積もり | - |
無料プランにはInstant Voice Cloningが含まれない。Instant Voice CloningはStarter($6/月)以上、Professional Voice CloningはCreator($11/月)以上で使えるようになる。
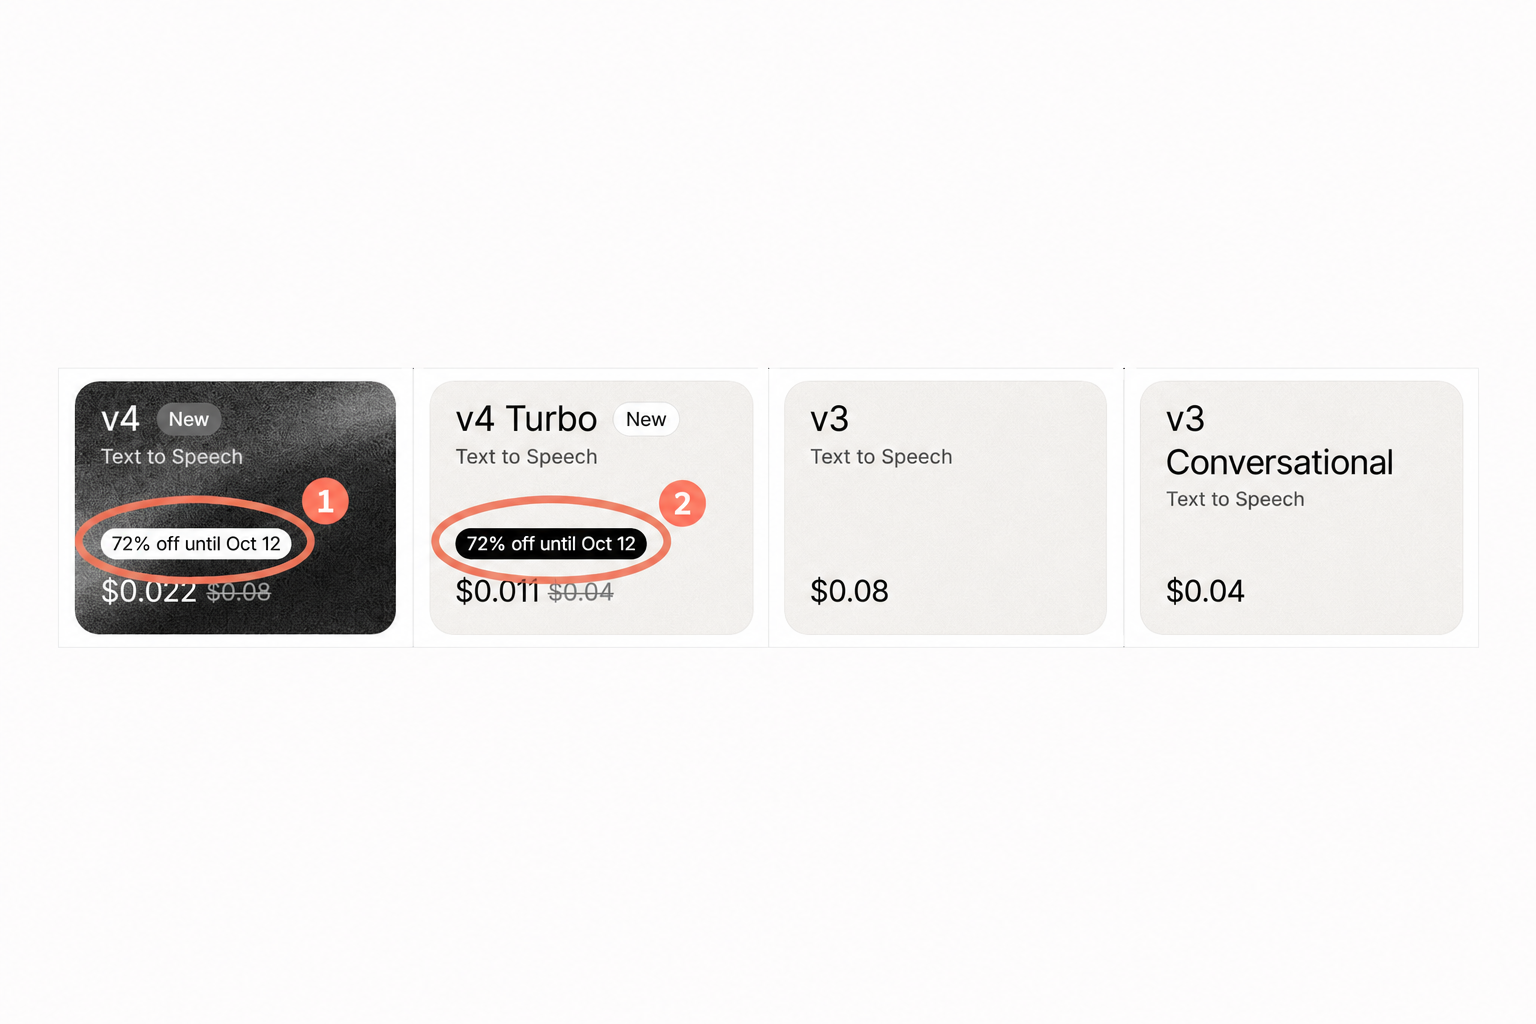
開発者向けのElevenAPIは従量課金で、通常価格はEleven v4が1,000文字あたり0.08ドル、v4 Turboが0.04ドル。現在(2026年10月12日まで)は期間限定でそれぞれ0.022ドル・0.011ドル(約72%オフ)に割り引かれている。告知どおりなら10月12日で終了し通常価格に戻ると読み取れるが、公式はそこまで明記していない。比較対象のEleven v3は0.08ドル、v3 Conversationalは0.04ドルで、こちらは割引表示がない。
向いている人・向かない人
向いている人
- ナレーション・オーディオブックなど、時間をかけて作り込む音声コンテンツを作る人(Eleven v4)
- カスタマーサポートの音声応答や音声エージェントなど、リアルタイムの応答速度が要る人(Eleven v4 Turbo)
- 日本語を含む90以上の言語で音声コンテンツを作る人
- 長尺の台本でも声の一貫性を保ちたい人
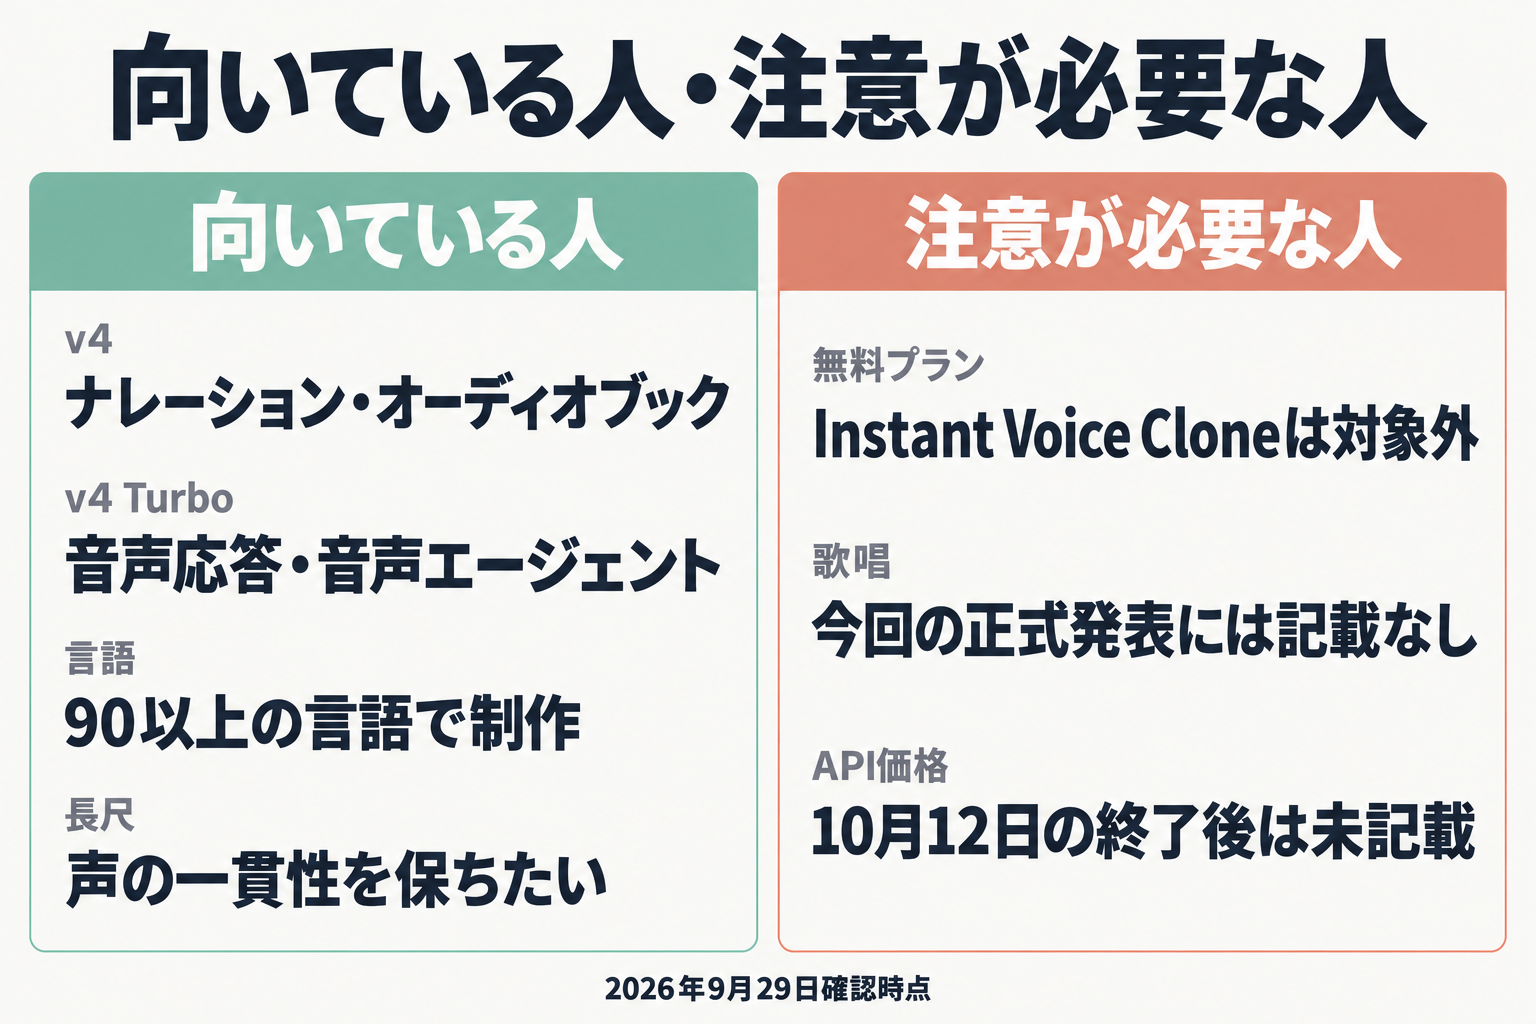
向かない人・注意が必要な人
- 無料プランのままInstant Voice Cloningを試したい人(Starter以上が必要)
- 2026年6月のプレビューで話題になった「歌唱」機能を期待していた人(今回の正式発表には記載がない。2026年9月29日確認時点)
- API従量課金の期間限定価格(10月12日まで)をそのまま前提に予算を組みたい人(終了後の価格は公式に明記されていない)
なお、2026年6月にワルシャワで予告されていた「歌唱」や、翻訳時の声の表情まで保つとされた「D2ダビング」という名称は、今回の正式発表(公式ブログ・v4ページ・プレスリリース)のいずれにも見当たらない。ダビングに関する記載は既存機能「Dubbing v2」への接続のみで、独自機能としては確認できなかった(2026年9月29日確認時点)。6月のデモを覚えている人は、今回のv4はまず「表現力とリアルタイム性」の2軸が正式リリースされた段階と捉えるとよい。
今日できる最初の一歩
今日やることは一つ。公式サイト(elevenlabs.io)でEleven v4のデモ音声を聴き、自分が作りたい声のトーンに合うか確かめることだ。
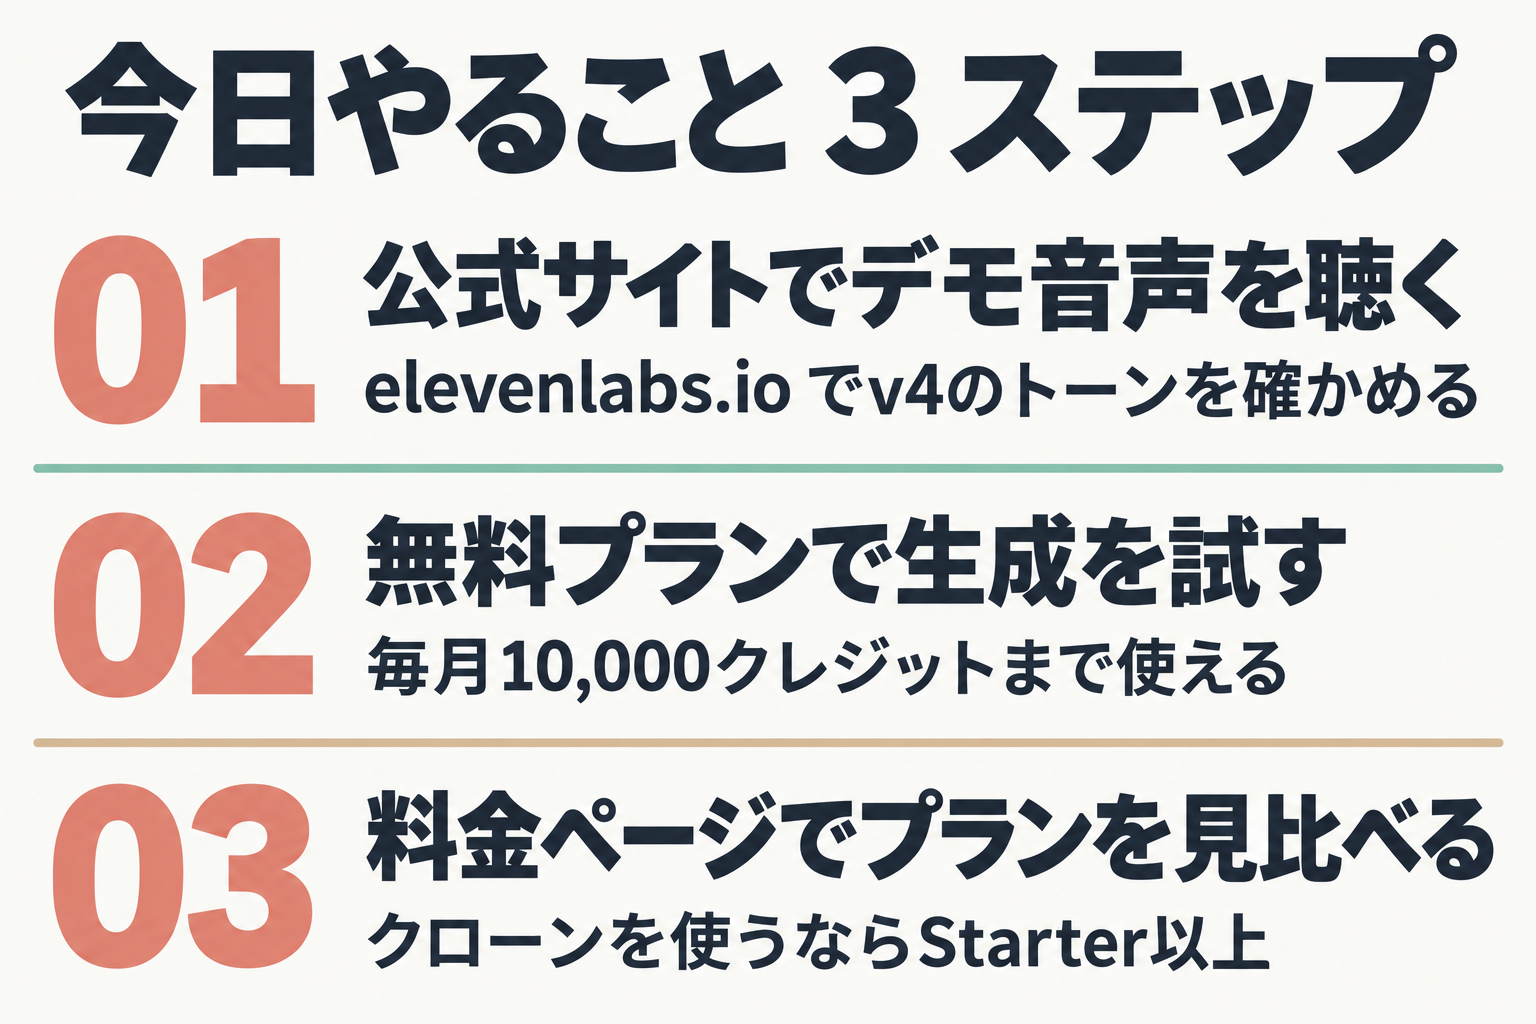
無料プランは毎月10,000クレジットまで使える(公式情報)。声のクローンまで試したい場合はStarter($6/月)以上でInstant Voice Cloning、Creator($11/月)以上でProfessional Voice Cloneが解放されるので、まず無料プランでデモとテキスト入力の生成を試し、必要な機能が使えるプランかを料金ページで見比べるとよい。
無料プランは月10,000クレジット。
ElevenLabs(Eleven v4) の料金プランを確認する(公式)もっと詳しく
音声コンテンツと合わせて文字起こしツールも検討している場合は、実測比較記事も参考になる: AI文字起こし実測比較|Notta/Rimo/tl;dv
Text to Speech以外の機能(Speech to Text、Music、Dubbing Studio等)へのEleven v4アーキテクチャの適用範囲は、2026年9月29日確認時点で公式に明記されていない。