Ollamaが「メモリが足りない」と止まったとき、この記事で分かることは2つです。①今起きているのが本当にメモリ不足(OOM=Out of Memory)かを確認する方法、②無料のswap(仮想メモリ)追加・量子化(軽量版モデルへの切替)・VPSプラン見直しという3つの対処のうち、どれを選ぶべきかの判断基準です。
実測は主に量子化モデルの切替について、ローカルのWindows機(GPU搭載・Ollamaネイティブサービス)で行いました。実際のLinux VPS上でのswap追加前後の比較は今回計測できていません(未計測の箇所は本文中に明記します)。
対象読者: 4GB前後の小さなVPSでOllamaを動かしていて、メモリ不足でモデルが起動しない・応答が返ってこない状態に陥った人。向かないケース: 32GB以上のハイエンド環境で30B超の大型モデルを動かしたい人(本記事は小型〜中型モデル・小規模VPSでの対処が対象です)。
迷ったらこれ:まずswapを追加、それでも直らなければ量子化
結論から言うと、対処は3段階です。①無料のswapを追加→②それでも直らなければ無料の量子化(Q4)に切り替え→③量子化後もメモリが足りない、または複数モデルを同時に使いたい場合はVPSのメモリ帯を上げる、の順で試してください。
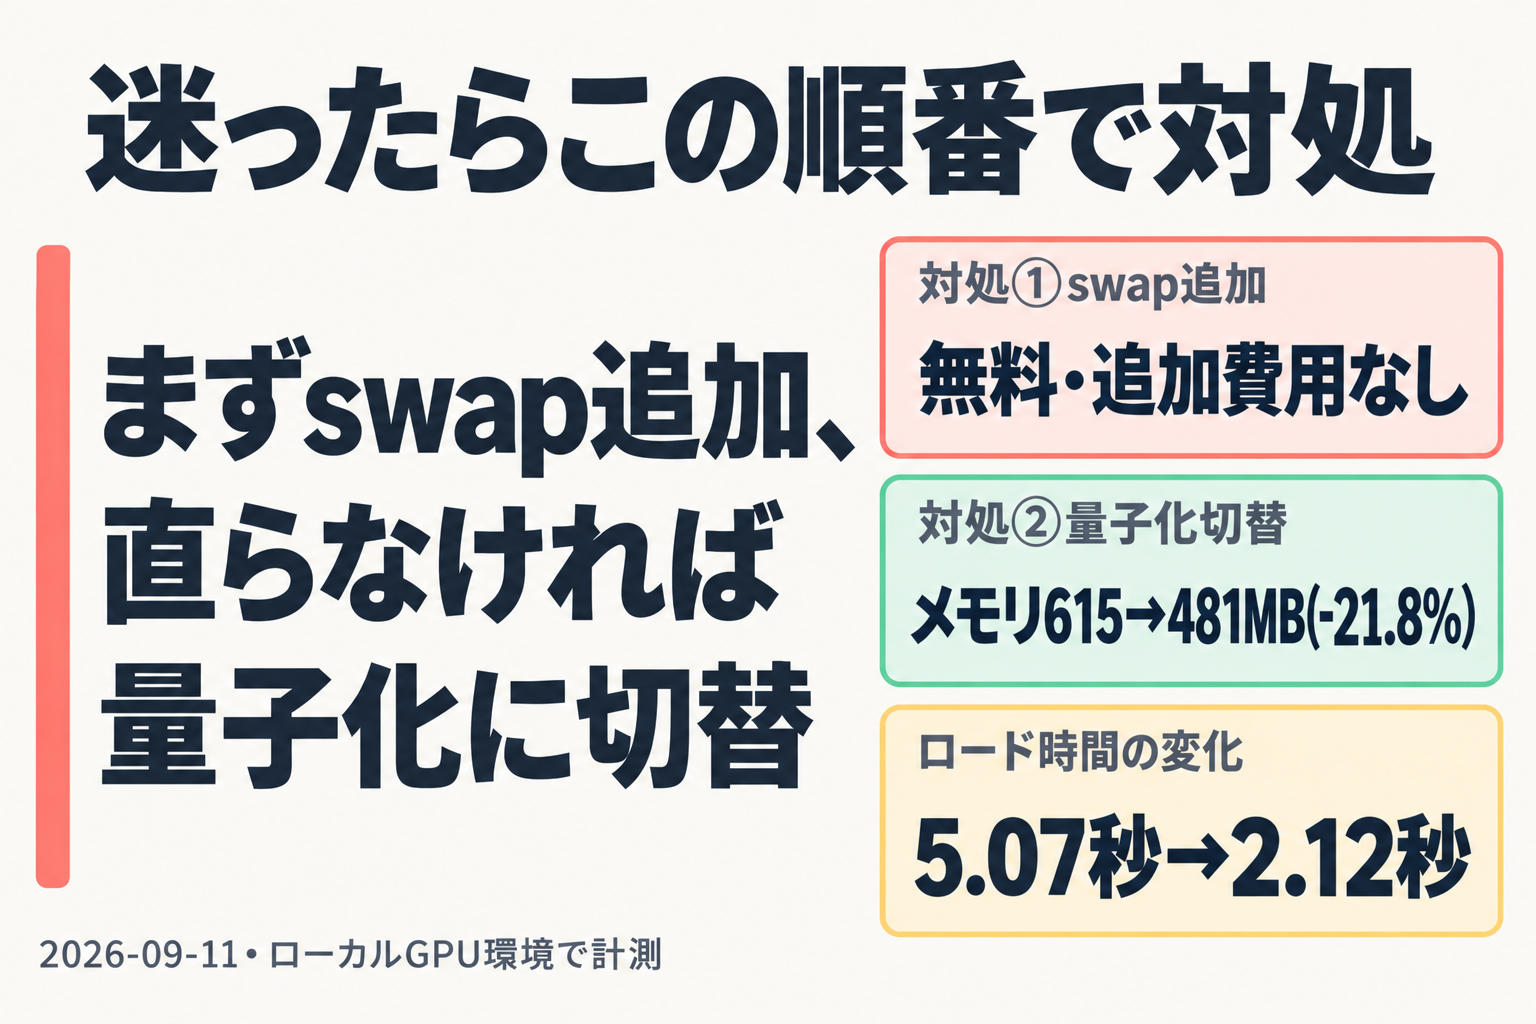
量子化で足りるか、VPS増強が要るかの分かれ目は「複数モデルを同時に使うか」「0.5Bより大きいモデルも動かしたいか」です。迷ったら、まず無料のswapと量子化(Q4)を試し、それでも足りなければXServer VPSクラウドでメモリ帯を上げてください。実測ではQ4量子化への切替でロード後メモリを615MB→481MB(-21.8%)まで削減できています。
まず swap(VPS/Linuxでは swap ファイル、ローカルの Windows 機ではページファイル)を追加してください。無料で、特別な契約や購入をせずに試せます。Linux はメモリが逼迫するとOSのOOM Killerがプロセスを強制終了する仕組みがあり、swap を確保しておくとこの強制終了が起きにくくなります(公式man pageに基づく一般論。今回の検証ではVPS実機での改善幅そのものは計測していません)。
それでも改善しない、あるいはディスクI/Oの遅さが気になる場合は、モデルを軽い量子化版に切り替えるのが次の一手です。こちらは実測しています。Q8_0からQ4_K_Mに切り替えたところ、ロード後のメモリ使用量は615MB→481MB(-21.8%)でした。ファイルサイズの差(-25.1%)よりメモリ使用量の減り幅がやや小さいのは、どちらのモデルもファイルサイズより実際のメモリ使用量が大きくなるためです(q4_K_Mで表示ファイルサイズの約+21%、q8_0で約+16%のオーバーヘッド)。モデルのファイルサイズだけで必要メモリを見積もると、実際にはそれより少し余裕を見ておく必要があります(モデルサイズ帯ごとの具体的なRAM目安は、現行のOllama公式ドキュメントに明記が見当たらず、出典不明の数値として本記事には書いていません)。
コールドロード時間も、q4_K_Mがq8_0の半分以下(2.12秒 vs 5.07秒)でした。生成速度そのもの(1秒あたりのトークン数)は今回の条件(GPU・0.5Bという極小モデル)では大きな差が出ていません。CPUのみの環境やより大きなモデルではq4の速度優位が広がる可能性がありますが、これは公式ドキュメント上の一般論で、今回の検証では確認していません。
注意点: 応答の中身も目視で確認したところ、q4_K_Mの出力に「メモリリクセス」のような不自然な語が出ました。0.5Bクラスの極小モデルは量子化のレベルに関わらず、そもそも日本語の生成品質が安定しない傾向があります。メモリは減らせても、モデル自体が小さすぎれば実用に耐えないことがある点は、切り替える前に踏まえておいてください。日本語モデルの実測比較はVPSで動くOllama日本語モデル実測比較でも扱っています。
④ それでも足りなければVPSプランを見直す
swapを足しても量子化しても落ちる場合、あるいは複数モデルを同時に使いたい場合は、VPSのメモリ帯そのものを上げるのが確実です。エックスサーバーのXServer VPSクラウドは2026-09-11時点で2GBプランが新規受付を一時停止しており、新規で契約できる最小プランは4GB(初回契約36ヶ月で月額3,850円〜、契約更新後は月額2,035円〜)です。今回の実測でQ4量子化への切替によりロード後メモリを481MBまで抑えられたことを踏まえると、それでも複数モデルを併用したい・0.5Bより大きいモデルも試したい場合は、更新後は月2,035円で当面の余裕を持たせられます。
VPSプランごとの料金・スペックの詳しい比較はVPS Ollama実測|メモリ選びと外部公開にまとめています。
最短手順:メモリ不足(OOM)の原因を確認してから対処する
① 本当にメモリ不足か確認する
Ollamaはモデルをロードする前に、必要なメモリと利用可能なメモリを自前でチェックする仕組みを持っています。足りない場合はアプリ自身が model requires more system memory (X GiB) than is available (Y GiB) という明確なエラーを返します。これはOSのOOM Killerによる強制終了とは別の、事前防止の仕組みです。
一方、エラーメッセージが出ないまま応答が突然止まる・プロセスが落ちる場合は、OSのOOM Killerが働いた可能性があります。Linux VPSでは dmesg -T(カーネルログをタイムスタンプ付きで表示)や journalctl -k(明示指定がなければ今回の起動分のカーネルログのみが対象になります)でカーネルメッセージを確認します。コマンドの構文は公式man pageで確認済みですが、今回の確認はWindows環境のため、実際のVPS上での出力例は掲載していません(未計測)。VPS実機ではこのコマンドで確認してください。
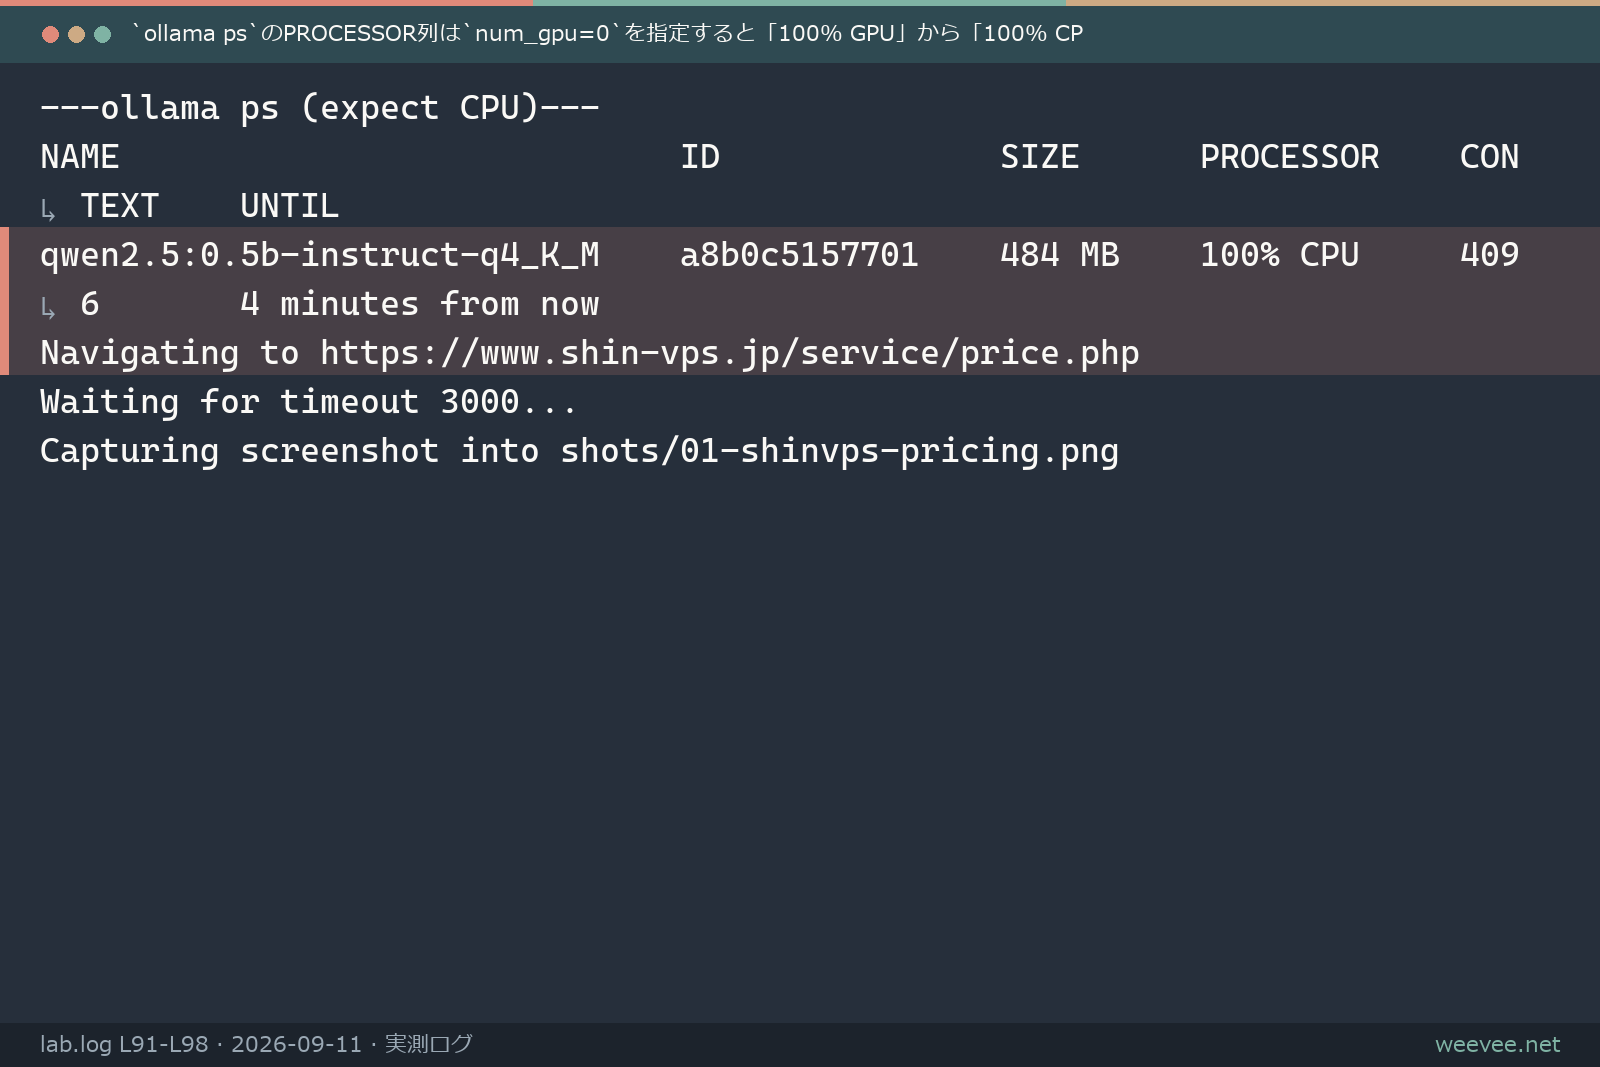
もう一つの手がかりが ollama ps です。実行中のモデルとメモリ使用量、GPU/CPUどちらで処理されているかが一覧で見られます。options.num_gpu に 0 を指定してリクエストを送ると、同じモデルでも ollama ps のPROCESSOR列が「100% GPU」から「100% CPU」に切り替わることを確認しました。GPUなしのVPSで動かしている場合、この列は常にCPU表示になっているはずです(ただし今回の確認はGPU搭載のローカル機を疑似的にCPU動作させたもので、実際にGPUを搭載しないVPS実機での確認ではありません)。
② swap(仮想メモリ)を追加する
Linux VPSでの基本手順は3ステップです。①dd でスワップ用ファイルを確保する(man pageでは「最も可搬性が高い」方法として案内されています。fallocate も広く使われますが、ファイルシステムによっては非対応の場合があります)②mkswap で初期化する③swapon で有効化する。優先度は swapon -p で指定でき、再起動後も有効にするには /etc/fstab に記述して swapon --all します。各コマンドの所要時間は今回は計測していません。
ローカルのWindows機でOllamaを試している場合は、Linuxのswapにあたるのが「ページファイル」です。Windowsは既定でシステム管理になっており、Microsoftの公式ガイドでは目安として「物理メモリの3倍または4GBのいずれか大きい方」が上限として案内されています(クラッシュダンプの設定によっても必要サイズは変わります)。
③ モデルを量子化版に切り替える
量子化とは、モデルの精度をやや落とす代わりにファイルサイズとメモリ使用量を減らす仕組みです。Ollamaの公式ライブラリでは、同じモデルでも複数の量子化タグが用意されています。qwen2.5:0.5b-instruct の場合、主なタグのファイルサイズは次の通りです(2026-09-11・Ollama公式ライブラリで確認)。
| 量子化タグ | ファイルサイズ |
|---|---|
| q4_0 | 352MB |
| q4_K_M | 398MB |
| q5_K_M | 420MB |
| q6_K | 506MB |
| q8_0 | 531MB |
| fp16(非量子化) | 994MB |
実際にq4_K_MとQ8_0をローカル環境(GPU搭載)でロードして比較したところ、ロード後のメモリ使用量は615MB→481MB(-21.8%)でした。ファイルサイズの差(-25.1%)よりメモリ使用量の減り幅がやや小さいのは、どちらのモデルもファイルサイズより実際のメモリ使用量が大きくなるためです(q4_K_Mで表示ファイルサイズの約+21%、q8_0で約+16%のオーバーヘッド)。モデルのファイルサイズだけで必要メモリを見積もると、実際にはそれより少し余裕を見ておく必要があります(モデルサイズ帯ごとの具体的なRAM目安は、現行のOllama公式ドキュメントに明記が見当たらず、出典不明の数値として本記事には書いていません)。
コールドロード時間も、q4_K_Mがq8_0の半分以下(2.12秒 vs 5.07秒)でした。生成速度そのもの(1秒あたりのトークン数)は今回の条件(GPU・0.5Bという極小モデル)では大きな差が出ていません。CPUのみの環境やより大きなモデルではq4の速度優位が広がる可能性がありますが、これは公式ドキュメント上の一般論で、今回の検証では確認していません。
注意点: 応答の中身も目視で確認したところ、q4_K_Mの出力に「メモリリクセス」のような不自然な語が出ました。0.5Bクラスの極小モデルは量子化のレベルに関わらず、そもそも日本語の生成品質が安定しない傾向があります。メモリは減らせても、モデル自体が小さすぎれば実用に耐えないことがある点は、切り替える前に踏まえておいてください。
よくある失敗トップ3
- エラーが出ないから大丈夫、と思い込む:
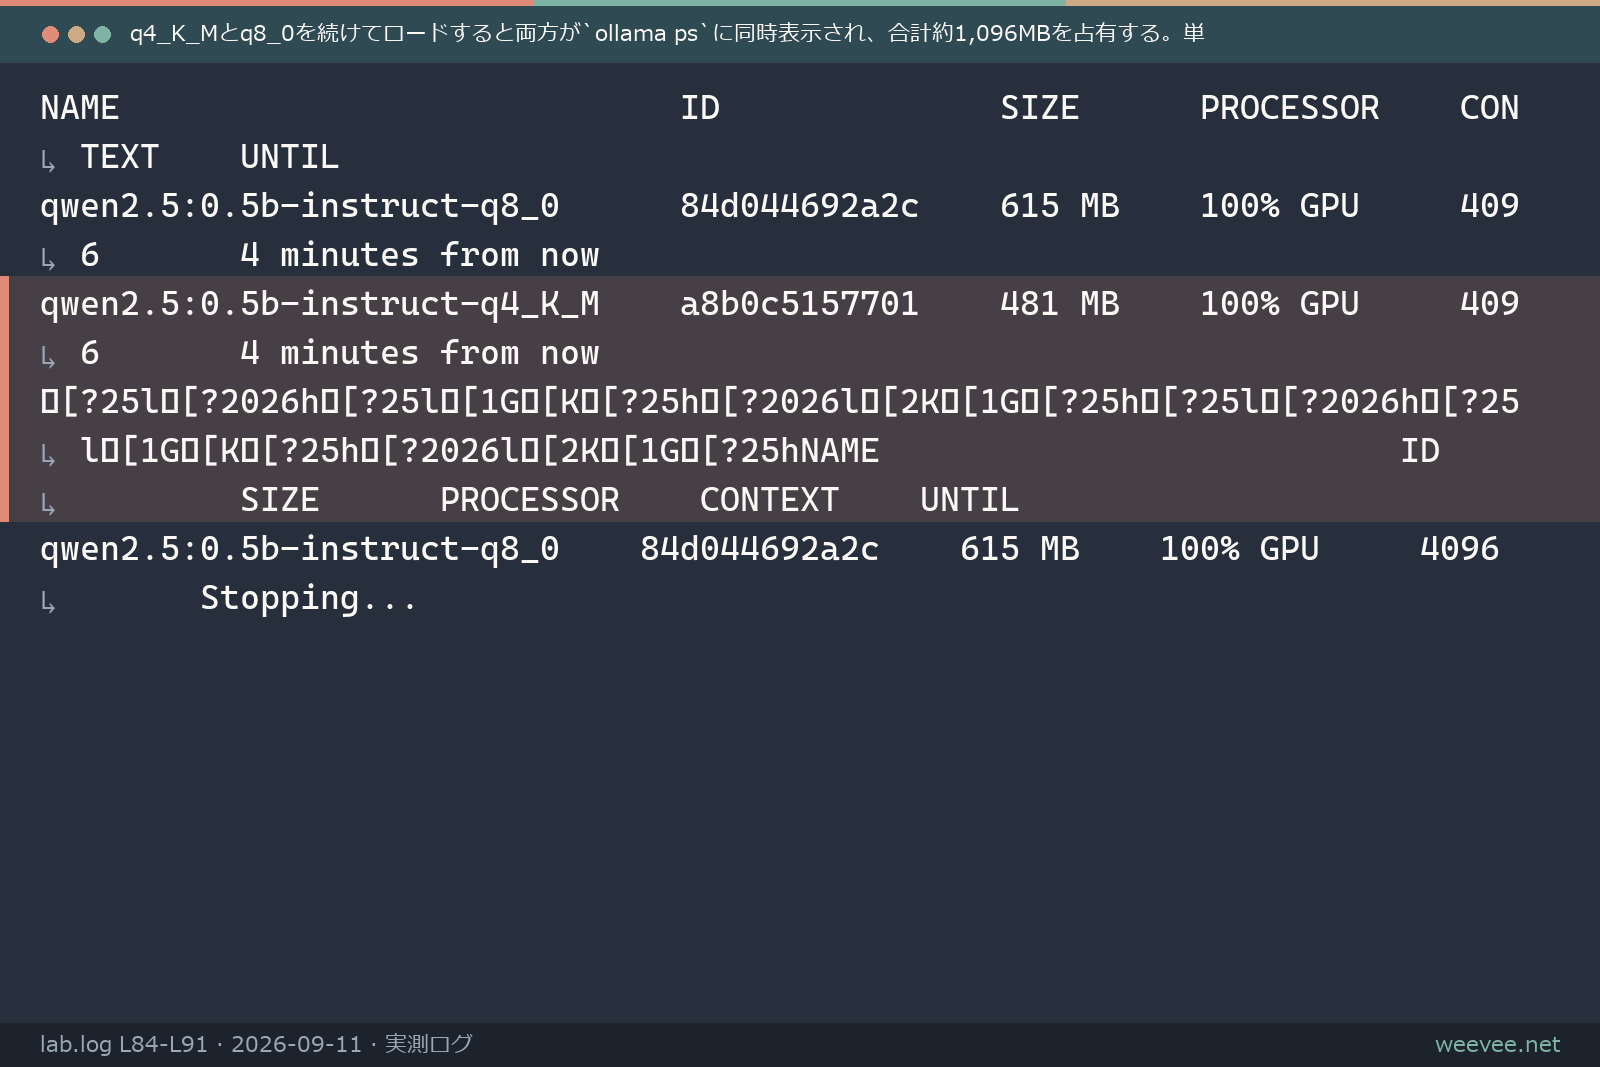
OLLAMA_KEEP_ALIVEの既定値は5分で、使い終えたモデルもロード後5分間はメモリに残り続けます。次のリクエストで別のモデルを呼ぶと、前のモデルがまだメモリに残ったまま新しいモデルもロードされ、合計のメモリ使用量が想定より膨らみます。 - 複数モデルを意識せず同時に呼び出す: q4_K_Mをロードした状態で続けてQ8_0にもリクエストを送ったところ、
ollama psにはq4_K_M(481MB)とQ8_0(615MB)が同時に表示され、合計で約1,096MBを占有していました。単体なら収まるはずのモデルでも、複数同時ロードでメモリを圧迫することがあります。 - 量子化すれば安心、と品質チェックを飛ばす: 前述の通り、極小モデルは量子化のレベルに関わらず日本語生成が不安定になることがあります。メモリだけ見て切り替えると、実用に耐えない応答品質になっていないかの確認が漏れがちです。
次の一歩
今日やることは1つです。まずswapと量子化を試し、それでも足りなければ上のCTAからXServer VPSクラウドを検討してください。実測ではQ4量子化でロード後メモリを615MB→481MB(-21.8%)まで抑えられており、まずは無料の対処から試す価値があります。
もっと詳しく
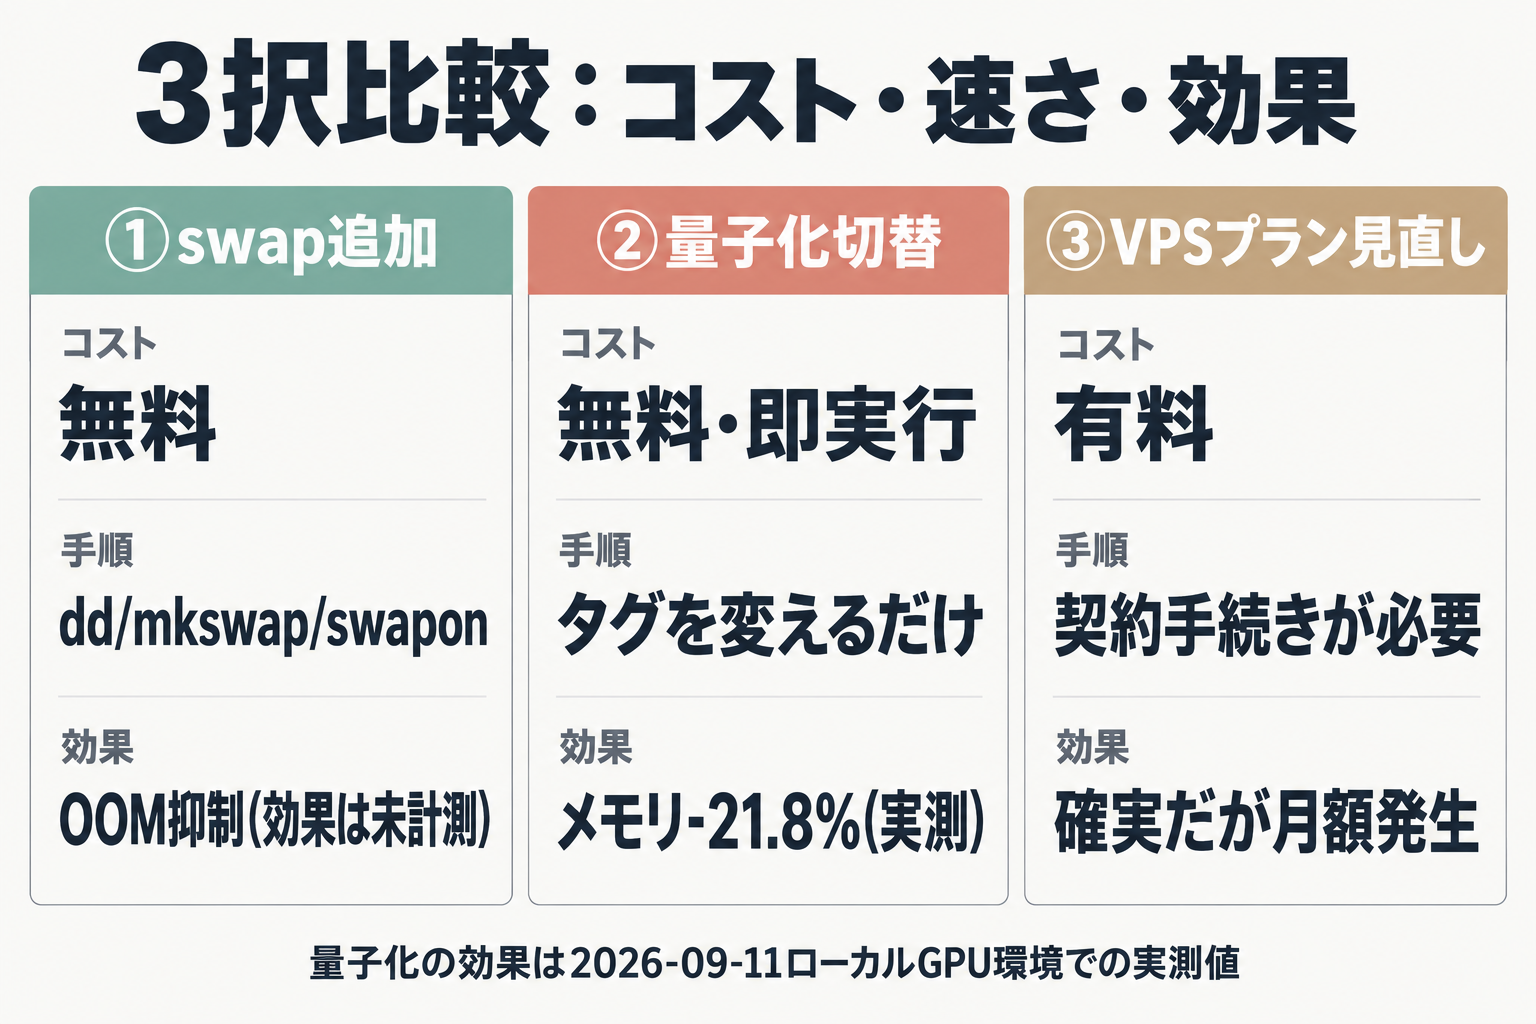
3択の比較
| 対処法 | コスト | 実行の速さ | 確実性・効果 |
|---|---|---|---|
| ①swap追加 | 無料 | 手順は dd/mkswap/swapon の3ステップ(所要時間は未計測) | OSの強制終了は起きにくくなるが、ディスクI/Oに起因して応答が遅くなる場合がある(一般論。VPS実機でのOOM再現率は今回未計測) |
| ②量子化切替(Q8→Q4等) | 無料・即実行 | モデルタグを変えるだけ | 実測でメモリ削減を確認(ファイルサイズ-25%・実メモリ-21.8%、ロード時間も半分以下)。生成速度・品質への影響は今回の条件では僅かだが、極小モデルの応答品質はそもそも不安定 |
| ③VPSプラン見直し | 有料 | 契約手続きが必要 | 確実だが月額コストが発生。2026-09-11時点でXServer VPSクラウドの新規最小プランは4GB(初回3,850円〜/更新後2,035円〜) |
GPU非搭載環境の確認について
本記事の ollama ps によるGPU/CPU切り替えの確認は、GPU搭載のローカル機を num_gpu=0 オプションでCPU動作に強制した代替実験です。実際にGPUを搭載しないVPS実機での確認ではありません。GPUなしVPSで運用している場合、ollama ps のPROCESSOR列が常に「100% CPU」と表示されているか、実機で確認してください。
同時ロード数を絞る設定
OLLAMA_MAX_LOADED_MODELS(既定値: GPU数×3、またはCPU推論時は3)と OLLAMA_NUM_PARALLEL(既定値1。必要メモリはこの値×コンテキスト長に比例)を環境変数で調整すると、同時にロードされるモデル数やメモリ使用量の上限をコントロールできます(Ollama公式ドキュメントで確認。値を変更した場合の挙動は今回は確認していません)。