Google が 2026年9月23日、文章を読み上げ音声にする「TTS(テキスト読み上げ)」モデルを 2 つ発表しました。Gemini 3.8 Flash TTS と Gemini 3.8 Flash-Lite TTS です。公式ブログによると 100 以上の言語で声を作れて、用意済みの声も 2,000 種類以上から選べます。つまり、棒読みになりがちだった自動ナレーションに「口調」「感情」「間」を指示できるようになった、という更新です。
この記事を読み終えると、Flash と Flash-Lite のどちらが自分の用途に合うか、今日どこで試せるか、費用がいくらかを同僚に一言で説明できます。内容は Google の発表、API ドキュメント、料金ページ(いずれも 2026年10月4日時点)に基づく公式情報の整理で、音声の生成テストは行っていません。
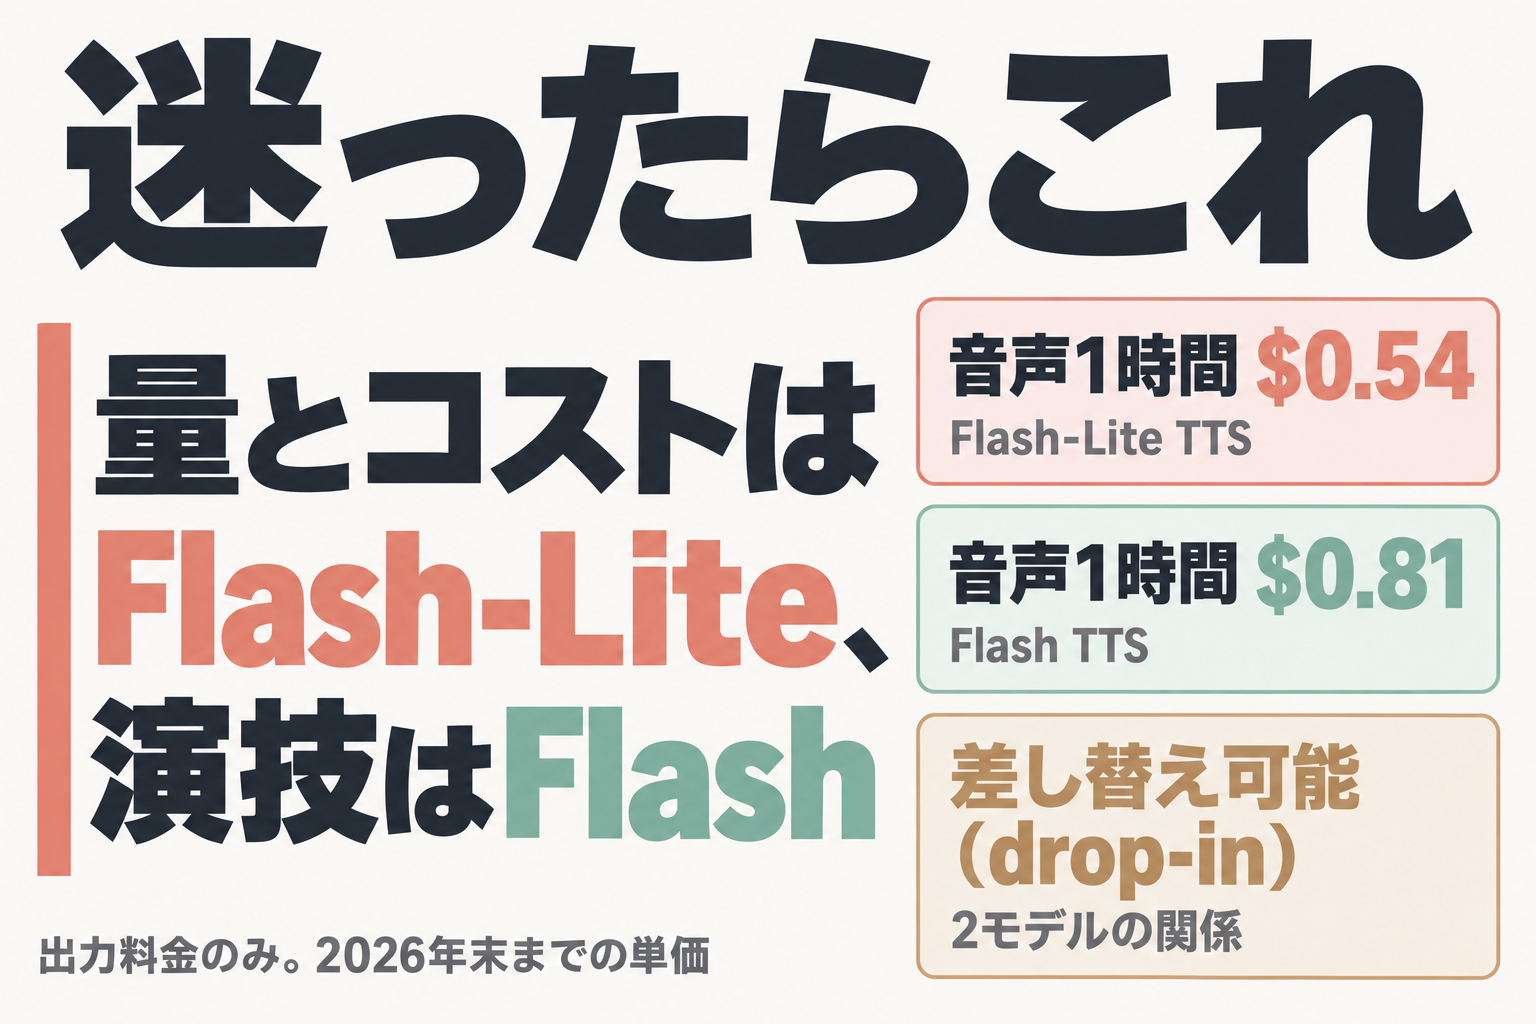
迷ったらこれ:量とコストならFlash-Lite、演技ならFlash
- ナレーション・読み上げ機能・動画の吹き替えを大量に作る人は Flash-Lite TTS。公式は Flash-Lite を「高スループット・低遅延・低コスト」向けと位置づけ、前世代 3.1 Flash TTS preview の推奨される置き換え先として明記しています。出力料金だけで見ると、音声 1 時間あたり $0.54(2026年末まで)です。
- オーディオブック、ゲームの声、ポッドキャストのように、声の演技を作り込みたい人は Flash TTS。公式は「声の忠実度・繊細な演技・方言カバレッジ」を強みとしています。1 時間あたり $0.81(同)です。
- 2 つは互いに差し替えられる(drop-in)と公式に説明されています。まず Flash-Lite で試し、演技に物足りなければ Flash に替える進め方なら、書いた台本も設定もそのまま使えます。
最初の 5 分でやること:Google AI Studio(開発者向けの試用画面)を開き、オーディオのプレイグラウンドで短い台本を 1 本読ませます。料金ページには両モデルとも無料枠があると書かれています。ただし無料枠に送った内容は Google の製品改善に使われます。社外秘の台本は流さないでください。
向かない人もいます。3 人以上の会話を 1 回の依頼で作りたい人、Live(リアルタイム対話)のように会話しながら音を返す用途の人は、この 2 モデルでは足りません(詳しくは後述)。
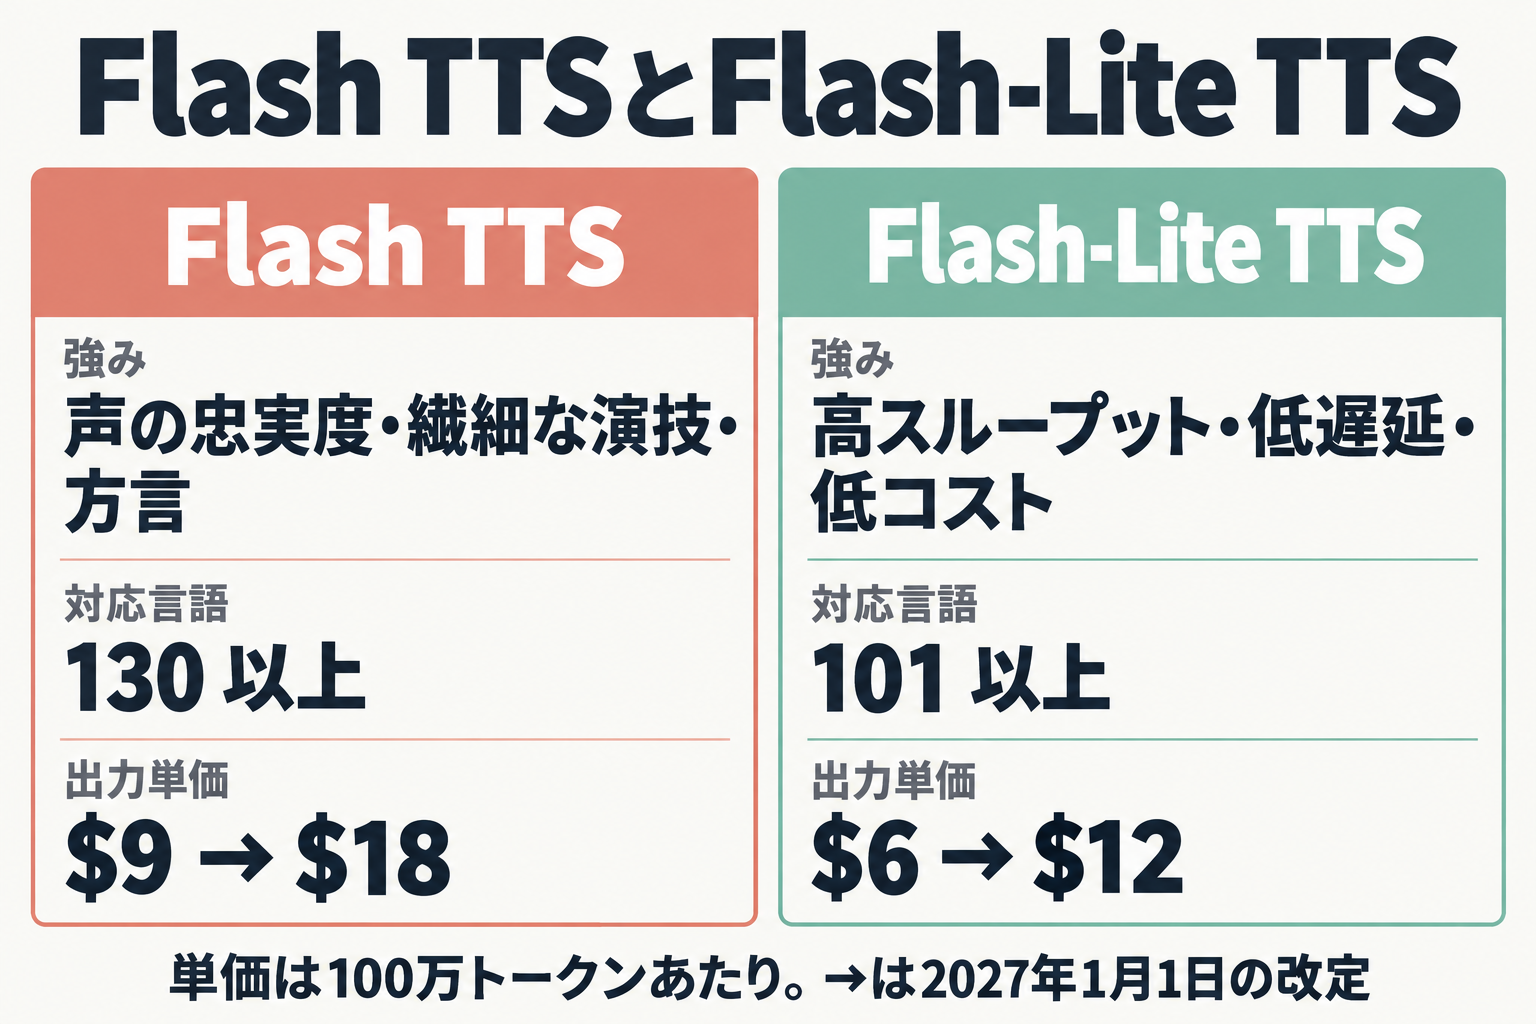
FlashとFlash-Liteの違い
| 項目 | Flash TTS | Flash-Lite TTS |
|---|---|---|
| モデル ID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 強み | 声の忠実度・繊細な演技・方言 | 高スループット・低遅延・低コスト |
| 向く用途 | オーディオブック、スタジオ収録のナレーション、複雑な複数話者の対話 | 大量生成、リアルタイムのエージェント、読み上げ機能 |
| 対応言語(ドキュメント) | 130 以上 | 101 以上 |
| 日本語 | あり | あり |
| 使える場所 | Gemini API・AI Studio・Gemini Notebook | Gemini API・AI Studio・Google Vids |
| 出力単価(100 万トークン) | $9 → $18 | $6 → $12 |
| 入力単価(100 万トークン) | $0.50 → $1.00 | $0.50 → $1.00 |
「→」は 2027年1月1日の改定を表します。言語数の見え方が「100 以上」と「130 以上 / 101 以上」で違うのは、ブログが大まかな表記、ドキュメントが具体数という関係です。どちらも日本語は対応言語表に入っています。
両モデルとも、音声生成、コンテキストキャッシュ、Batch API、Flex 推論、優先推論に対応します。一方、関数呼び出し、構造化出力、thinking、Live API、コード実行、ファイル検索、画像生成には対応しません。
まず無料で試したい人には無料枠あり。
Gemini API(Gemini 3.8 Flash TTS / Flash-Lite TTS) を無料で始める(公式)3.1から変わった点と、移行で壊れる点
前世代の gemini-3.1-flash-tts-preview からの最大の変更は、入力テキストの扱いです。3.8 は入力を「一字一句の台本(verbatim transcript)」として扱います。本文に「明るく読んでください」のような演出指示を混ぜると、指示まで読み上げられる可能性があります。3.1 向けに書いた台本は、モデル名を替えるだけで済ませず、指示の置き場所を直してから使うのが安全です。
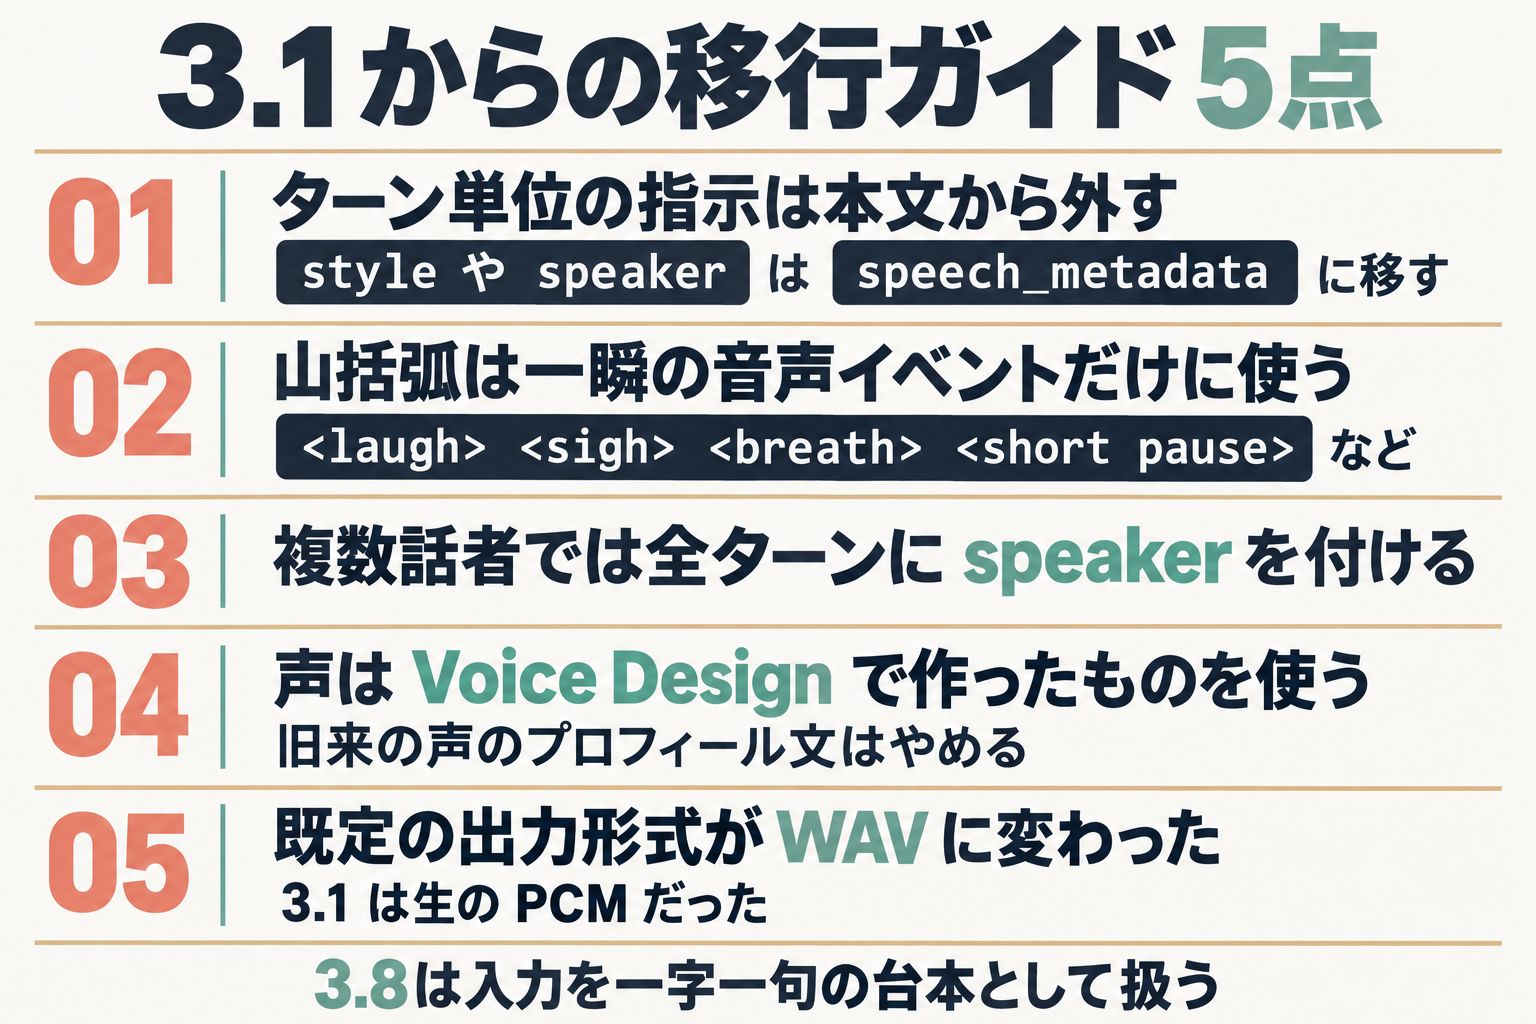
公式の移行ガイドは 5 点です。
- ターン単位の指示は本文から外す。
styleやspeakerはspeech_metadataに移し、「Say cheerfully」のような本文中の指示は避けます。 - 山括弧は一瞬の音声イベントだけに使う。
<laugh><sigh><breath><short pause>などです。話し方そのものはspeech_metadata.styleに置きます。 - 複数話者では全ターンに
speakerを付ける。 - 旧来の声のプロフィール文をやめ、Voice Design で作った声を使う。
- 既定の出力形式が WAV(RIFF ヘッダ付き)に変わった。3.1 は生の PCM でした。生 PCM が必要なら
audio/l16・audio/mulaw・audio/alawを指定します。
動画編集ソフトに読み込むだけなら WAV 既定は扱いやすい変更です。自前の処理で生 PCM を前提にしていた人は、5 番に合わせて出力形式を指定し直してください。
今日どこで使えるか
| 場所 | 誰向け | 使えるモデル |
|---|---|---|
| Google AI Studio | 開発者。画面で声と指示を試したい人 | Flash / Flash-Lite |
| Gemini API | 開発者。自分のアプリや制作フローに組み込む人 | Flash / Flash-Lite |
| Gemini Notebook | 一般ユーザー | Flash TTS |
| Google Vids | 一般ユーザー。動画づくりの中で使う人 | Flash-Lite TTS |
提供は発表日から順次です。Gemini Enterprise は両モデルとも「近日」とされ、開始日は示されていません。
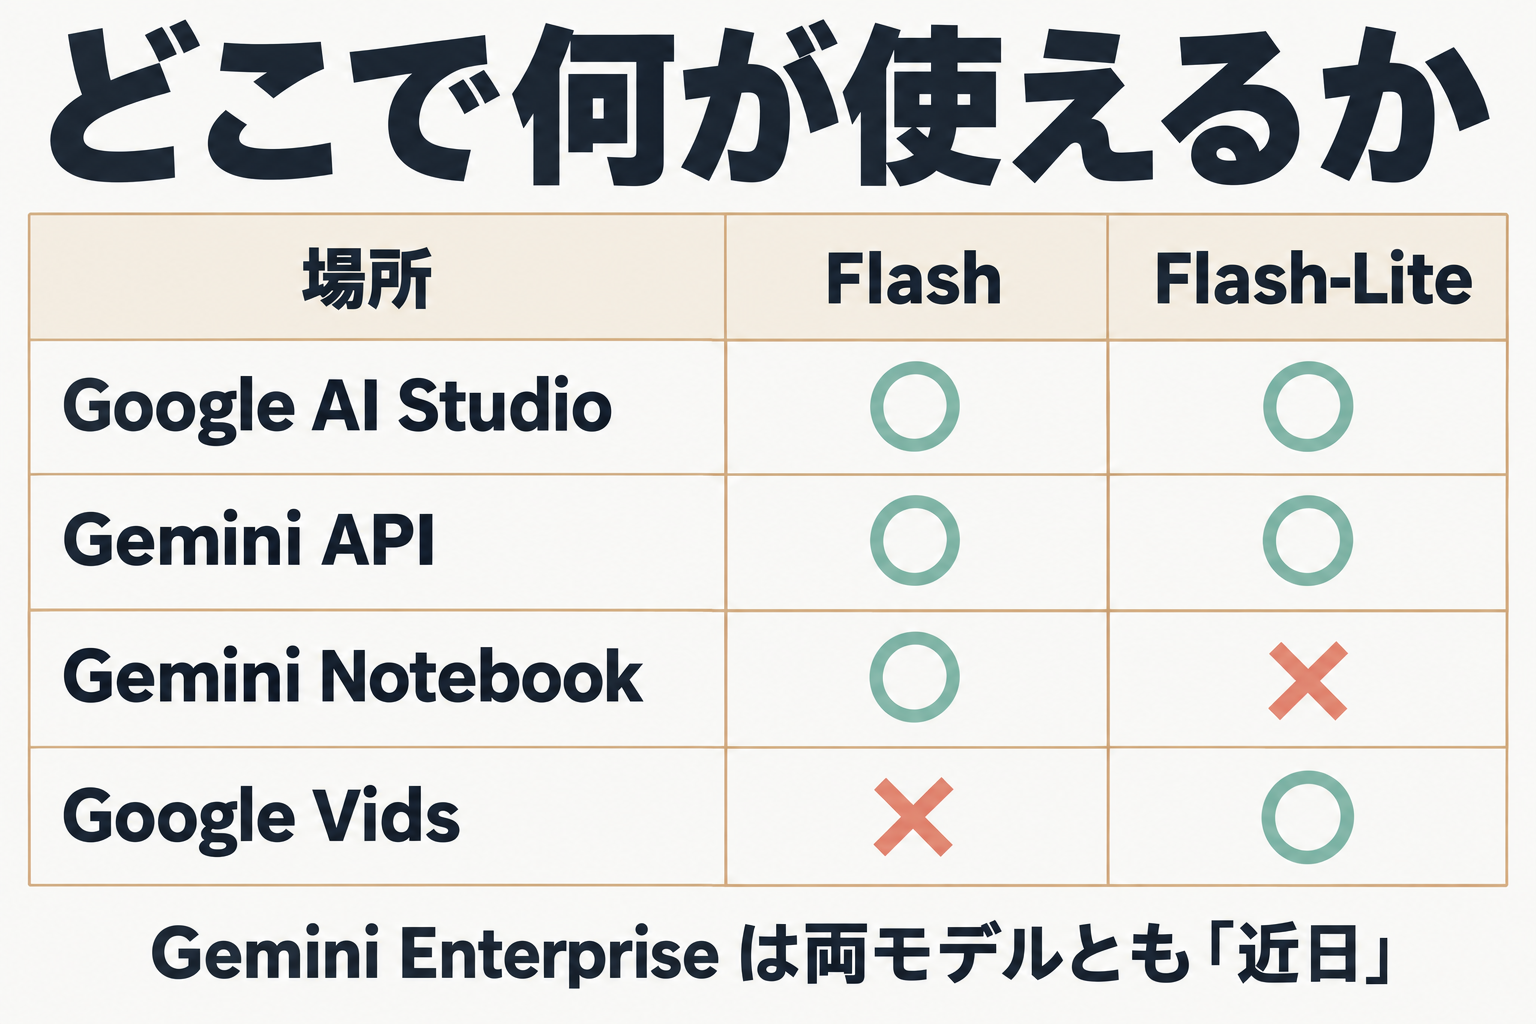
プログラムを書かない人は、Gemini Notebook か Google Vids の中で使うのが現実的です。API キーの取得から始める人は、Google AI Studioの使い方に発行手順を整理しています。
API の呼び出し例
以下は公式の音声生成ドキュメントのサンプルをもとにした形です。抜粋のため、コピーして使う前に最新の原文と突き合わせてください。
1 人で読む(style 指定)
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{"type": "user_input", "content": [{
        "type": "text",
        "text": "Have a wonderful day!",
        "annotations": [{"type": "speech_metadata",
                        "style": "cheerful and friendly"}]
    }]}],
    response_format={"type": "audio"},
    generation_config={"speech_config": [{"voice": "Kore"}]}
)
2 人で話す(speaker 指定)
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{"type": "user_input", "content": [
        {"type": "text", "text": "How's it going today Jane?",
         "annotations": [{"type": "speech_metadata",
                         "speaker": "Joe", "style": "cheerful"}]},
        {"type": "text", "text": "Not too bad, how about you?",
         "annotations": [{"type": "speech_metadata",
                         "speaker": "Jane", "style": "calm"}]}
    ]}],
    generation_config={"speech_config": {"speakers": [
        {"speaker": "Joe", "voice": "Puck"},
        {"speaker": "Jane", "voice": "Kore"}
    ]}}
)
Flash-Lite を使うときは model を gemini-3.8-flash-lite-tts に替えます。
演技の指定の考え方
- 話し方全体は
styleに書く。公式の例は"cheerful and friendly"(明るく親しみやすく)や"whispered urgently"(切迫してささやくように)です。 - 笑い・ため息・間のような一瞬の音は、本文の中にタグで置く。
<laugh><sigh><cough><breath><short pause>が公式に挙がっています。日本語の台本でも、タグは英語のまま使うことが推奨されています。 - 聞き手の相づちは
|reaction|の形で表します。
書き方の違いを、日本語の台本で例にします(書き方の例であり、生成結果を示すものではありません)。
| 避ける書き方 | 勧められる書き方 |
|---|---|
| 本文:「明るく元気に読んでください。本日はご来店ありがとうございます」 | 本文:「本日はご来店ありがとうございます」 / style: "cheerful and friendly" |
左は、3.8 では「明るく元気に読んでください」まで声に出される可能性があります。
声の用意は 4 通り
- プリセット 30 種(Kore、Puck、Zephyr など)。
- 拡張ボイスライブラリ。言語・アクセント・性別・用途で絞り込めます。ブログは「2,000 種類以上」、API ドキュメントは「数百の追加ボイス」と書いており、表現が異なります。
- Voice Design。自然言語の説明から新しい声を作ります。
- Voice Replication。参照音声から声を複製します。参照音声は 10〜30 秒が推奨で、参照話者の同意確認が必要です。提供地域は要確認とされています。
作った声は voice_… で始まる ID で呼び出します。保存は 1 プロジェクト最大 200 個、最終使用から 1 年で期限切れです。
Voice Design と Voice Replication が無料枠で使えるかは、公式ドキュメントに明記がありません。料金ページも「無料枠あり」とだけ書いています。
料金と無料枠
音声は 1 秒 = 25 トークンなので、1 分は 1,500 トークン、1 時間は 90,000 トークンです。下表は出力(音声)料金のみで、台本テキストの入力料金は含みません。
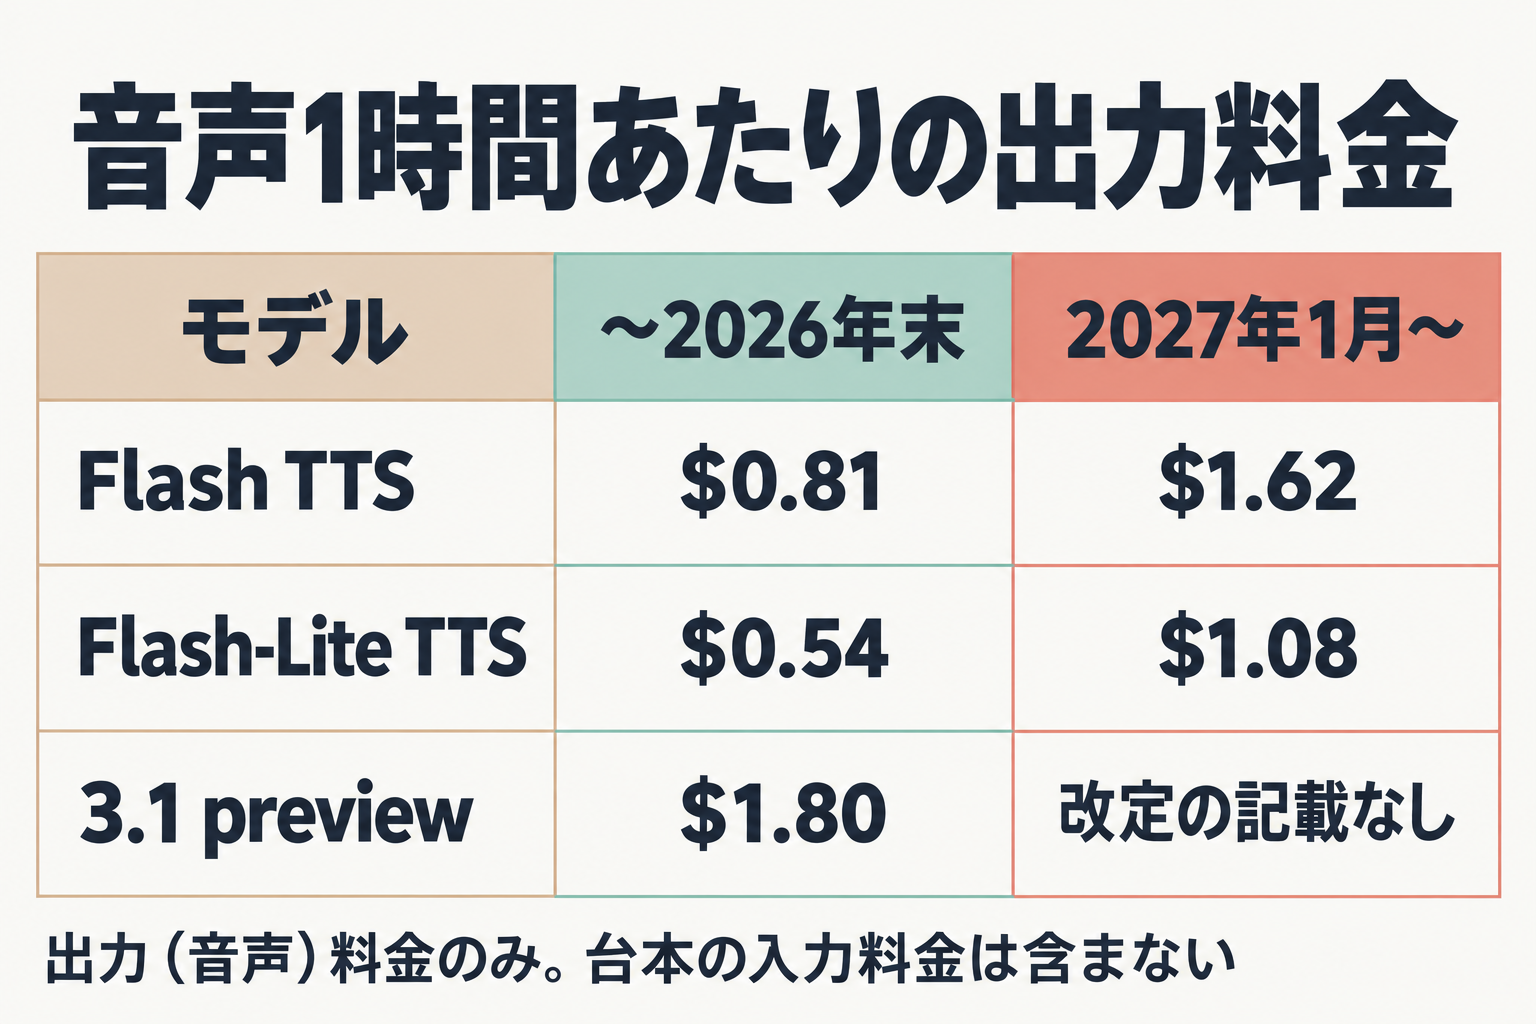
| モデル | 〜2026-12-31 の 1 分 | 〜2026-12-31 の 1 時間 | 2027-01-01〜 の 1 分 | 2027-01-01〜 の 1 時間 |
|---|---|---|---|---|
| Flash TTS | $0.0135 | $0.81 | $0.027 | $1.62 |
| Flash-Lite TTS | $0.009 | $0.54 | $0.018 | $1.08 |
| 3.1 Flash TTS preview | $0.030 | $1.80 | 改定の記載なし | 改定の記載なし |
2027年1月1日から、3.8 の 2 モデルは入力・出力とも単価が 2 倍になります。Batch は 50% 引きです(Flash-Lite の出力は $3.00 → $6.00)。
「1 万字あたり」の目安は、公式に日本語の読み上げ速度の記載がないため、仮定を置いた計算です。毎分 300 字で読むと仮定すると、1 万字は約 33 分です。
| モデル | 〜2026 年末 | 2027 年 1 月〜 |
|---|---|---|
| Flash TTS | 約 $0.45 | 約 $0.90 |
| Flash-Lite TTS | 約 $0.30 | 約 $0.60 |
| 3.1 Flash TTS preview | 約 $1.00 | 改定の記載なし |
実際の読み上げ速度は台本や指示で変わるため、あくまで見積もりの目安です。
無料枠は 3.8 Flash、3.8 Flash-Lite、3.1 preview のすべてにあります。違いはデータの扱いです。無料枠のデータは Google 製品の改善に使われ、有料枠のデータは使われません。社外秘の台本、未発表の商品の案内文、顧客名の入った読み上げは、有料枠で扱うのが安全です。
向き不向きと制限
| 場面 | 合うモデル | 理由(公式の位置づけから) |
|---|---|---|
| オーディオブック・ゲームの声・ポッドキャスト | Flash | 演技と声の作り込み向け |
| 動画の大量の吹き替え・多言語の案内 | Flash-Lite | 大量生成・低コスト向け |
| アプリの読み上げ機能 | Flash-Lite | 低遅延向け |
| 2 人の掛け合い(1 回の依頼) | どちらも可 | 最大 2 人まで |
制限(公式に書かれているものだけ)
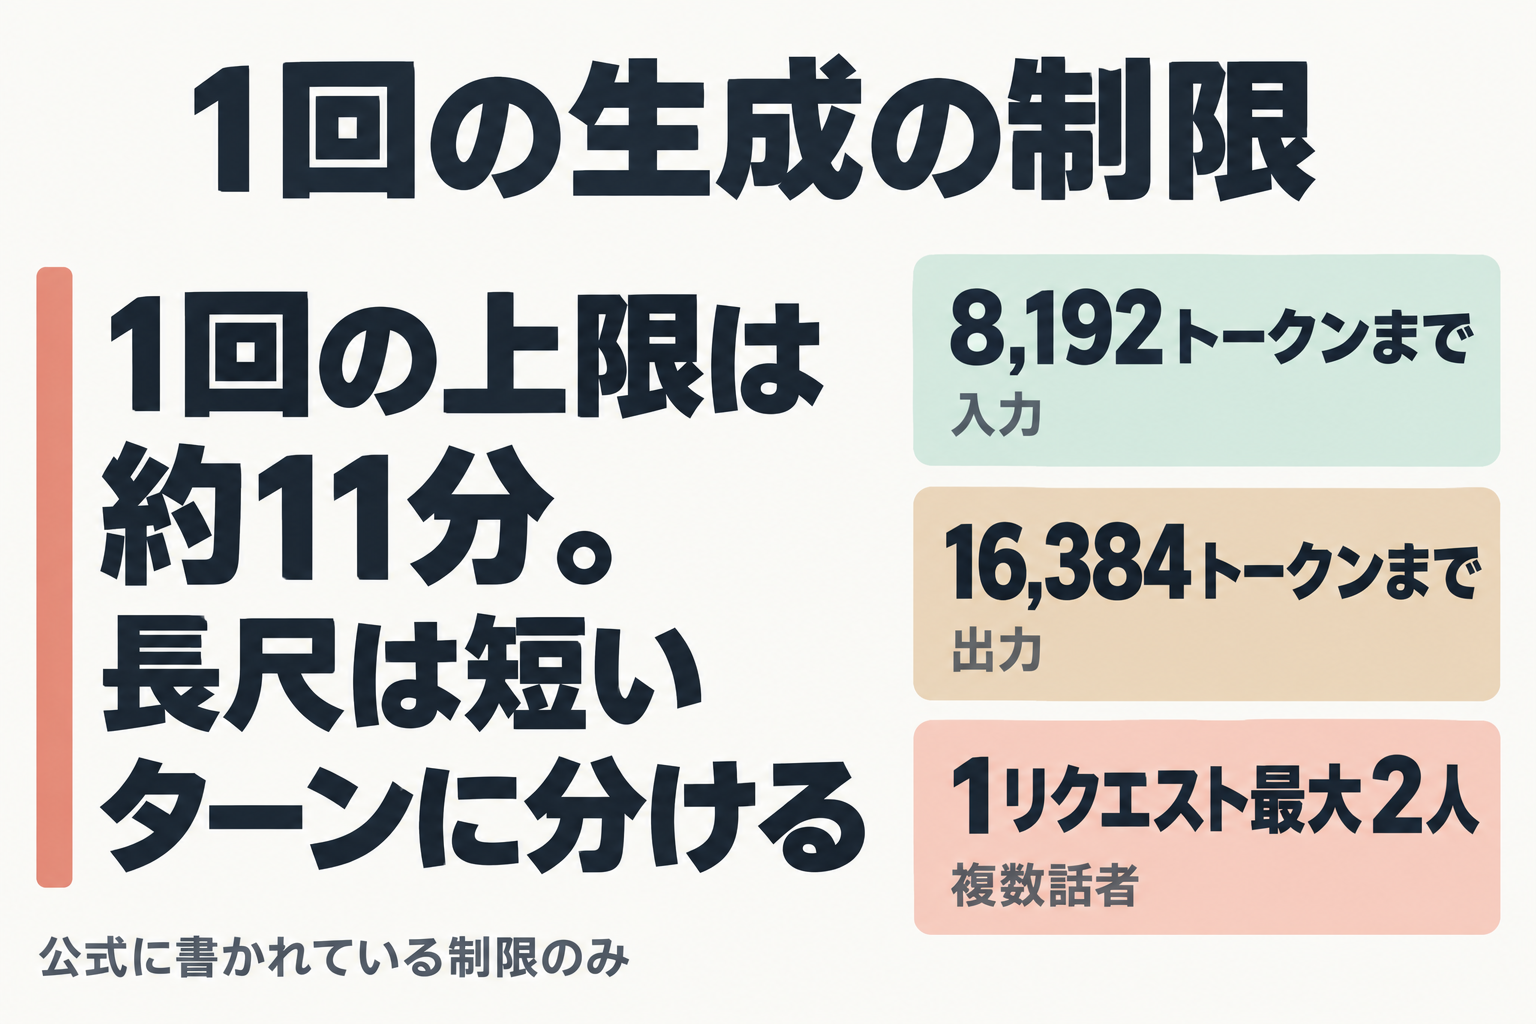
- 入力は 1 回 8,192 トークンまで、出力は 16,384 トークンまでです。出力は 1 秒 25 トークンなので、約 655 秒、つまり約 11 分が 1 回の上限です。
- 長尺は 1 回の大きな依頼ではなく、短いターンに分けて生成することが推奨されています。
- 複数話者は 1 リクエスト最大 2 人で、プリセット音声が前提です。3 人以上は個別に生成し、WAV ヘッダを除いた PCM を連結します。
- 生成音声には SynthID の透かしが入ります。C2PA クレデンシャルにも対応します。
- 日本語の読み上げ品質を数値で示す公式資料はありません。Google は Voice Arena で日本語を含む主要言語でトップ、Hume AI の Voice Design Benchmark で総合 1 位(71.4)と発表していますが、どちらも Google の発表値です。納品物に使うなら、自分の台本で数十秒を聞いてから決めてください。
Live との違い
2 つの TTS モデルは Live API に対応しません。TTS は「用意した台本を読み上げる音声を作る」用途で、会話しながらリアルタイムに声を返す用途は別系統の機能です。後者が目的なら、TTS ではなく Live 系の機能を選んでください。音声系の別の動きは、ElevenLabs Eleven v4とは?v3との違いにまとめています。
次の一歩:今日、Flash-Lite で 1 本読ませる
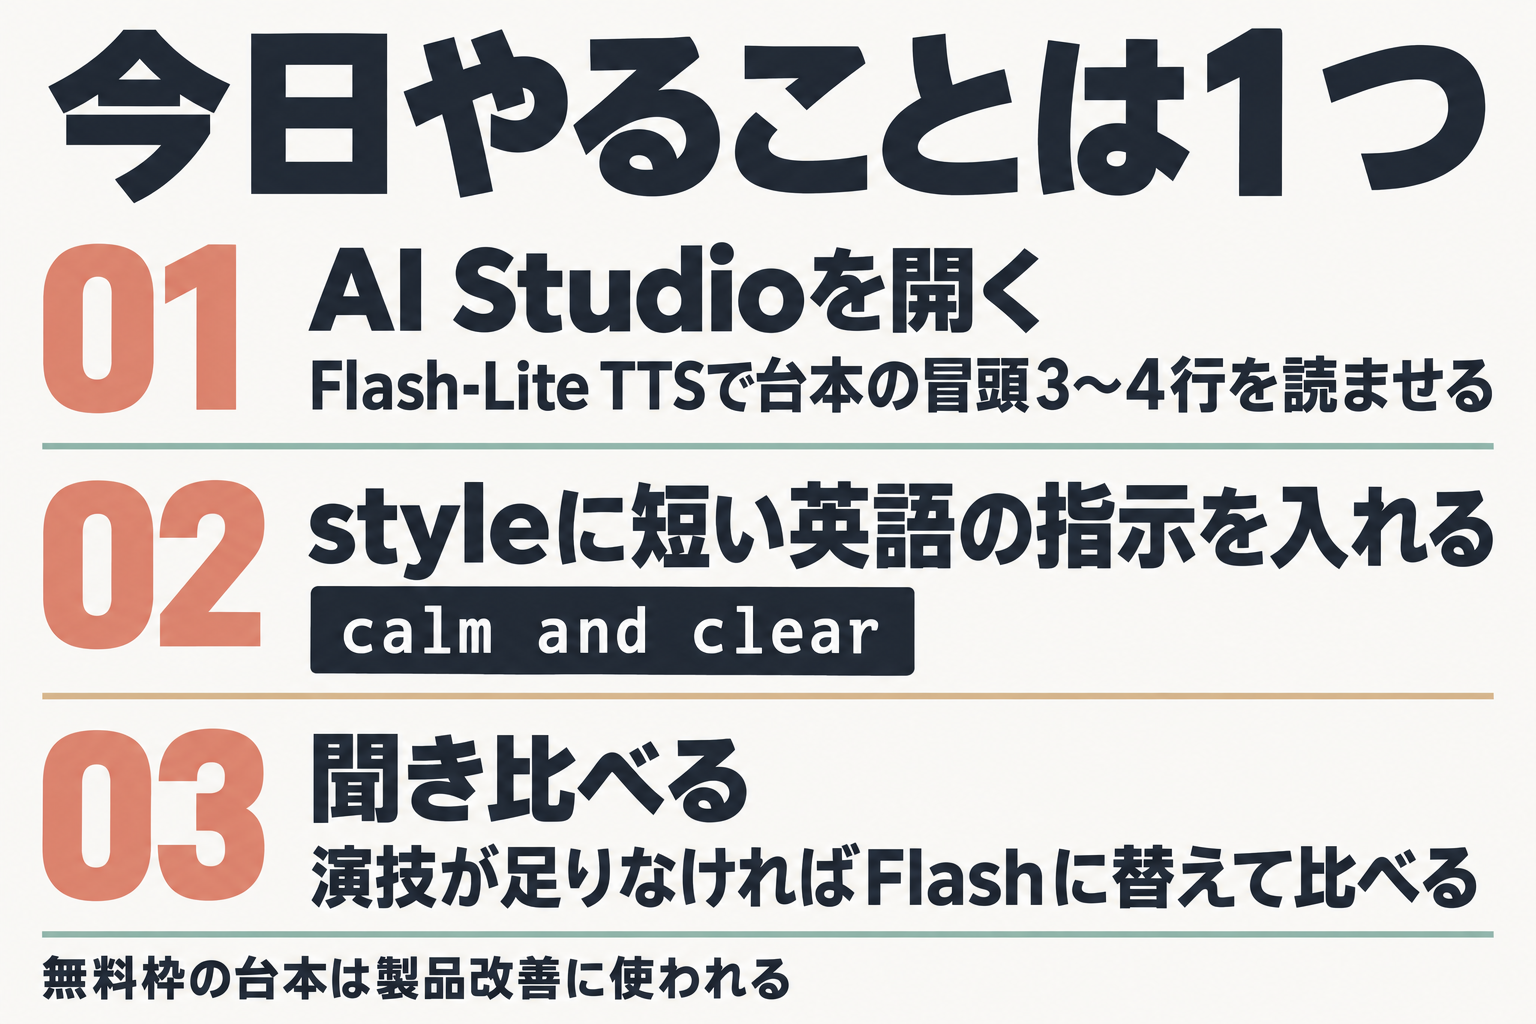
今日やることは 1 つです。AI Studio を開き、Flash-Lite TTS で自分の台本の冒頭 3〜4 行を読ませ、style に "calm and clear" のような英語の短い指示を入れて聞き比べます。演技が足りないと感じたら、同じ台本を Flash に替えて比べます。
出力料金で見ると、Flash-Lite は 1 時間のナレーションが $0.54(2026年末まで)、2027年1月以降も $1.08 です。外注や手作業でナレーションを作っている小規模事業者や個人開発者は、台本 1 本ぶんの試作を無料枠で済ませてから有料枠に進めば、費用の見通しが立てやすくなります。
3.1 preview を使っている人は、2027年1月の改定の前に、指示文を style に移して Flash-Lite に差し替えて確認してください。