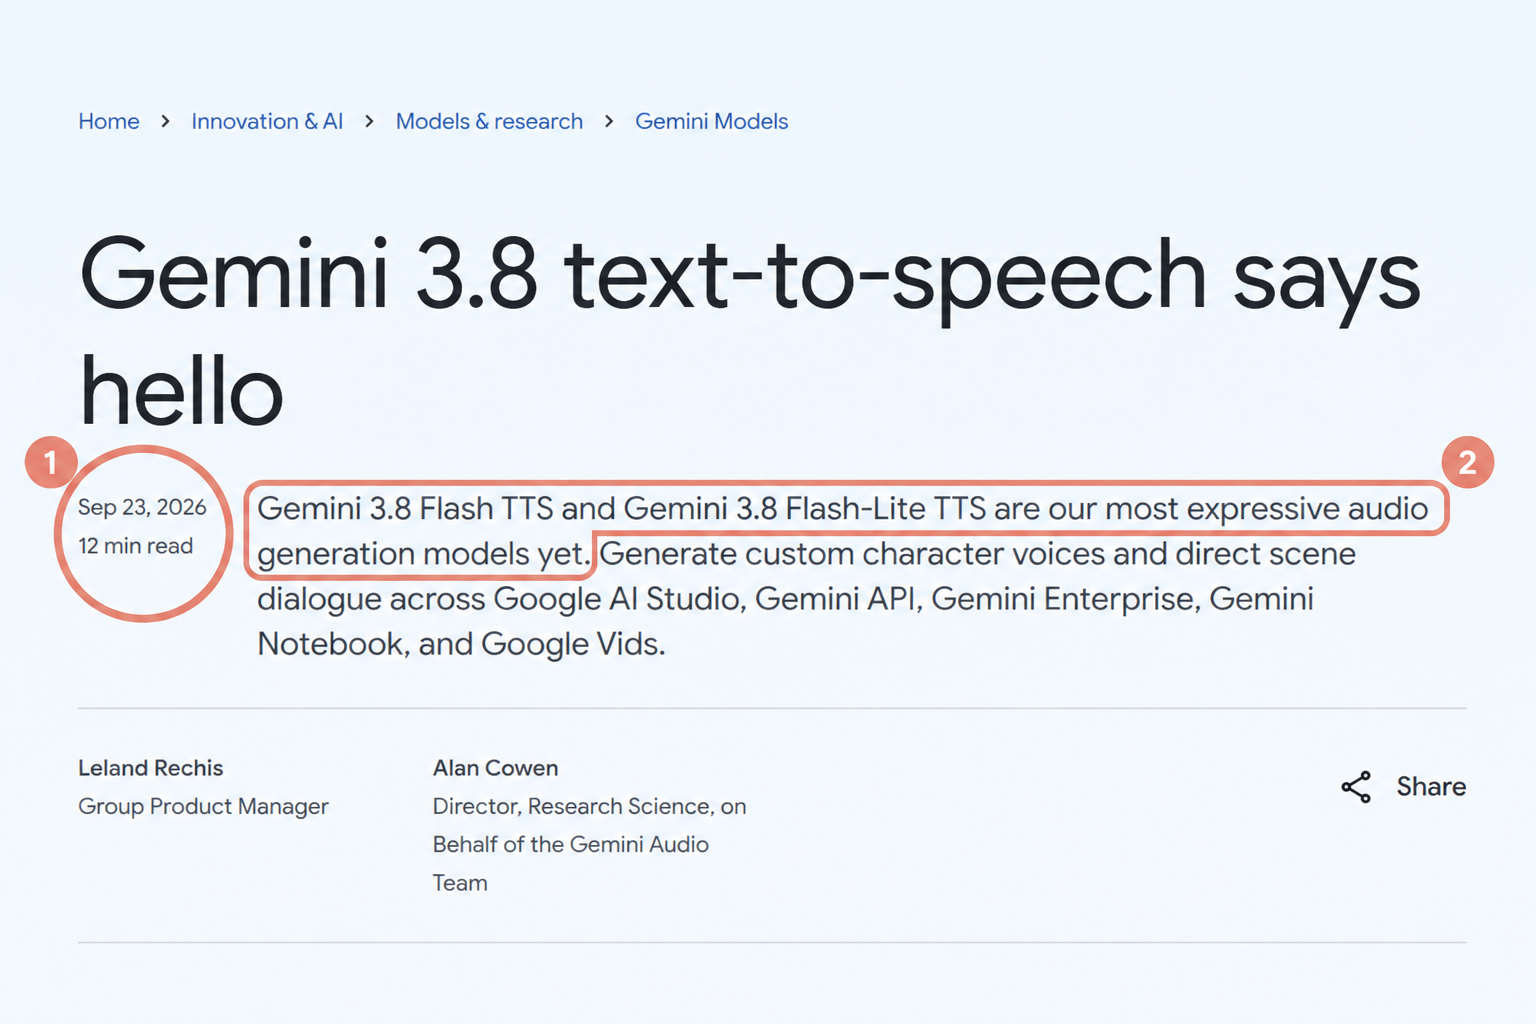
Googleは2026年9月23日、文章を人の声のような音声に変える「テキスト読み上げ(TTS)」の新モデル「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を発表しました。笑い声やため息まで台本に書き込めるようになり、声を新しく設計したり、同意を得た声を複製したりもできます。ナレーションや多言語音声の下書きをAIで作りたい人に関係する更新です。本記事では実際の音声生成は行っておらず、公式ブログ・公式ドキュメント・モデルカード(2026年9月27日確認)の記載に基づいて整理しています。
つまり何が起きたか
一言でいうと、読み上げAIが「棒読みの朗読」から「演技の指定ができる声優役」に近づきました。台本に「ささやくように」「息を切らして」といった話し方の指定や、笑い・ため息といった音の指定を入れられます。2人の会話を1本の台本から作る機能も使えます。
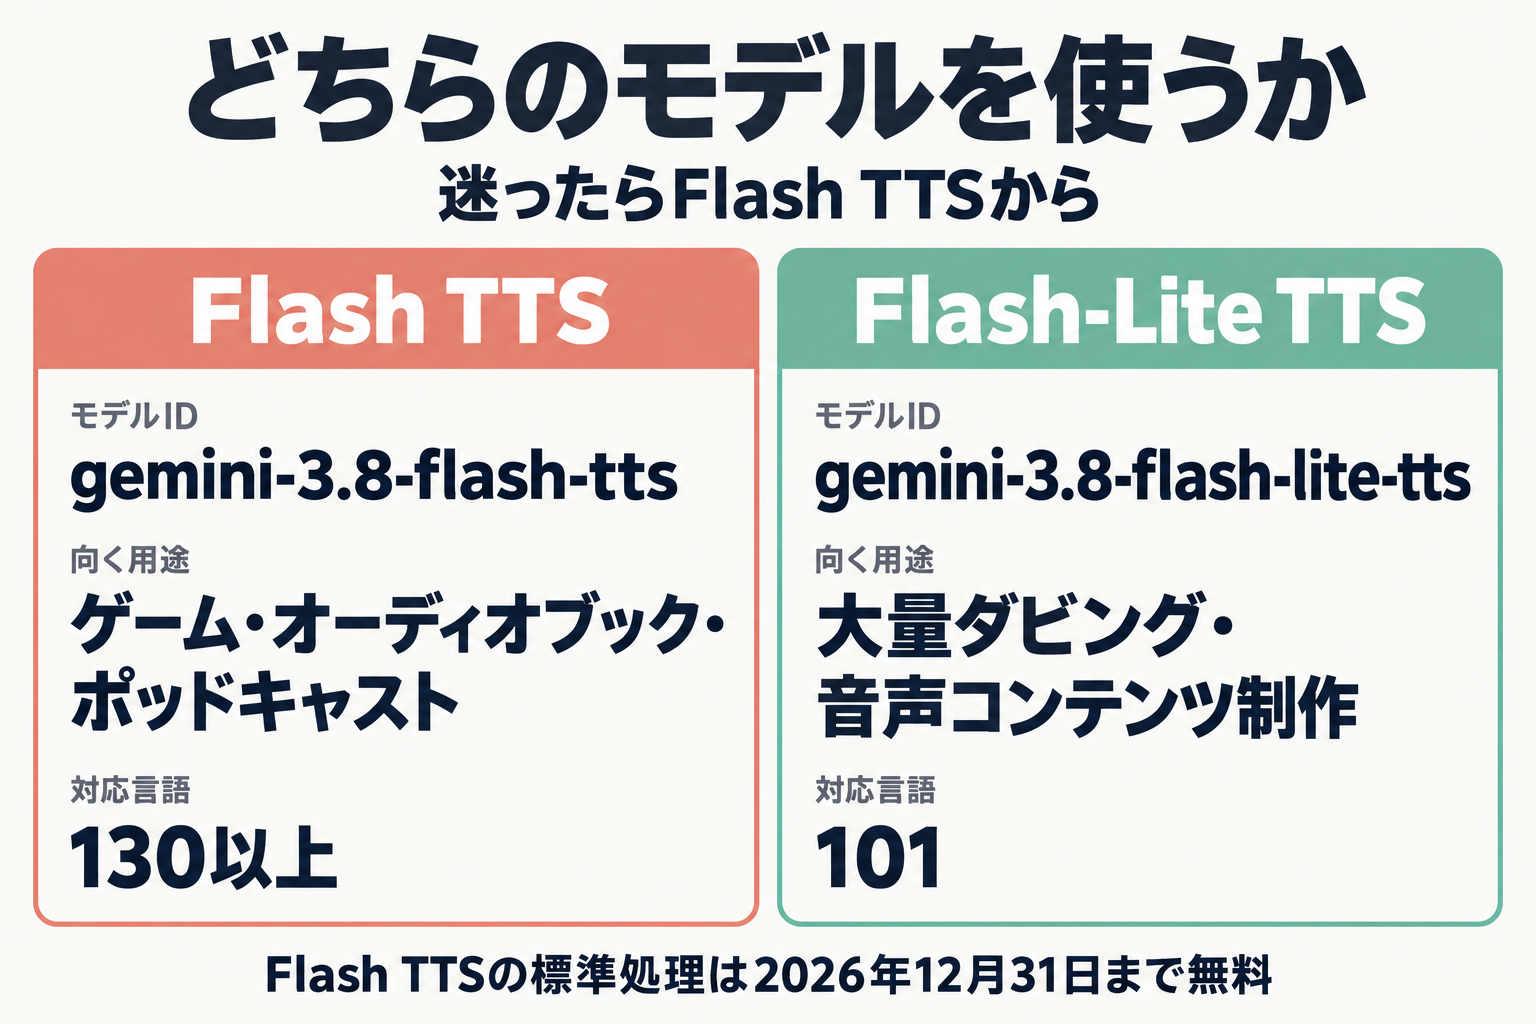
迷ったらこれ:どちらのモデルを使うか
- セリフの演技・ナレーション・ポッドキャスト風の下書き → Flash TTS(
gemini-3.8-flash-tts) - 大量の読み上げ・コストを抑えたい用途 → Flash-Lite TTS(
gemini-3.8-flash-lite-tts)
迷う人は、まず Flash TTS から試すのが分かりやすい選択です。公式の料金ページでは、Flash TTS の標準処理(Standard)は入力も出力も2026年12月31日まで無料と記載されています。つまり年内なら、音声1時間ぶんを標準処理で生成しても料金はかかりません。一方、Flash-Lite TTS は標準処理でも有料で、音声1時間あたり約0.54ドルです(計算方法は料金の章に載せています)。最初の5分でやることは、短い台本を1つ用意して読み上げさせてみることです。
| Flash TTS | Flash-Lite TTS | |
|---|---|---|
| モデルID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 向く用途(公式) | ゲーム、没入型オーディオブック、ポッドキャスト、複数話者の会話 | 大量ダビング、音声コンテンツ制作、表現力のある音声エージェント |
| 対応言語 | 130以上 | 101 |
| 提供先 | Gemini API・Google AI Studio・Gemini Notebook・Gemini Enterprise(近日) | Gemini API・Google AI Studio・Google Vids・Gemini Enterprise(近日) |
向かない人もいます。社外秘の原稿を読み上げさせたい場合、無料枠に送った内容は「製品改善に使われる」と料金ページに明記されています(有償枠は「使われない」)。その場合は有償枠を使うか、機密性の低い原稿で試すのが安全です。また、通常のGeminiチャットアプリ(gemini.google.com)への搭載は、公式発表・モデルカードのどちらにも記載がありません。
これまで(3.1プレビュー)→ いま(3.8)
前の世代の gemini-3.1-flash-tts-preview は、チェンジログで「legacy preview model(旧プレビュー)」とされ、Flash-Lite TTS に置き換えられたと書かれています。単価(100万トークンあたり・Standard)で見ると変化は大きく、Flash-Lite TTS は出力が20ドルから6ドルになりました。
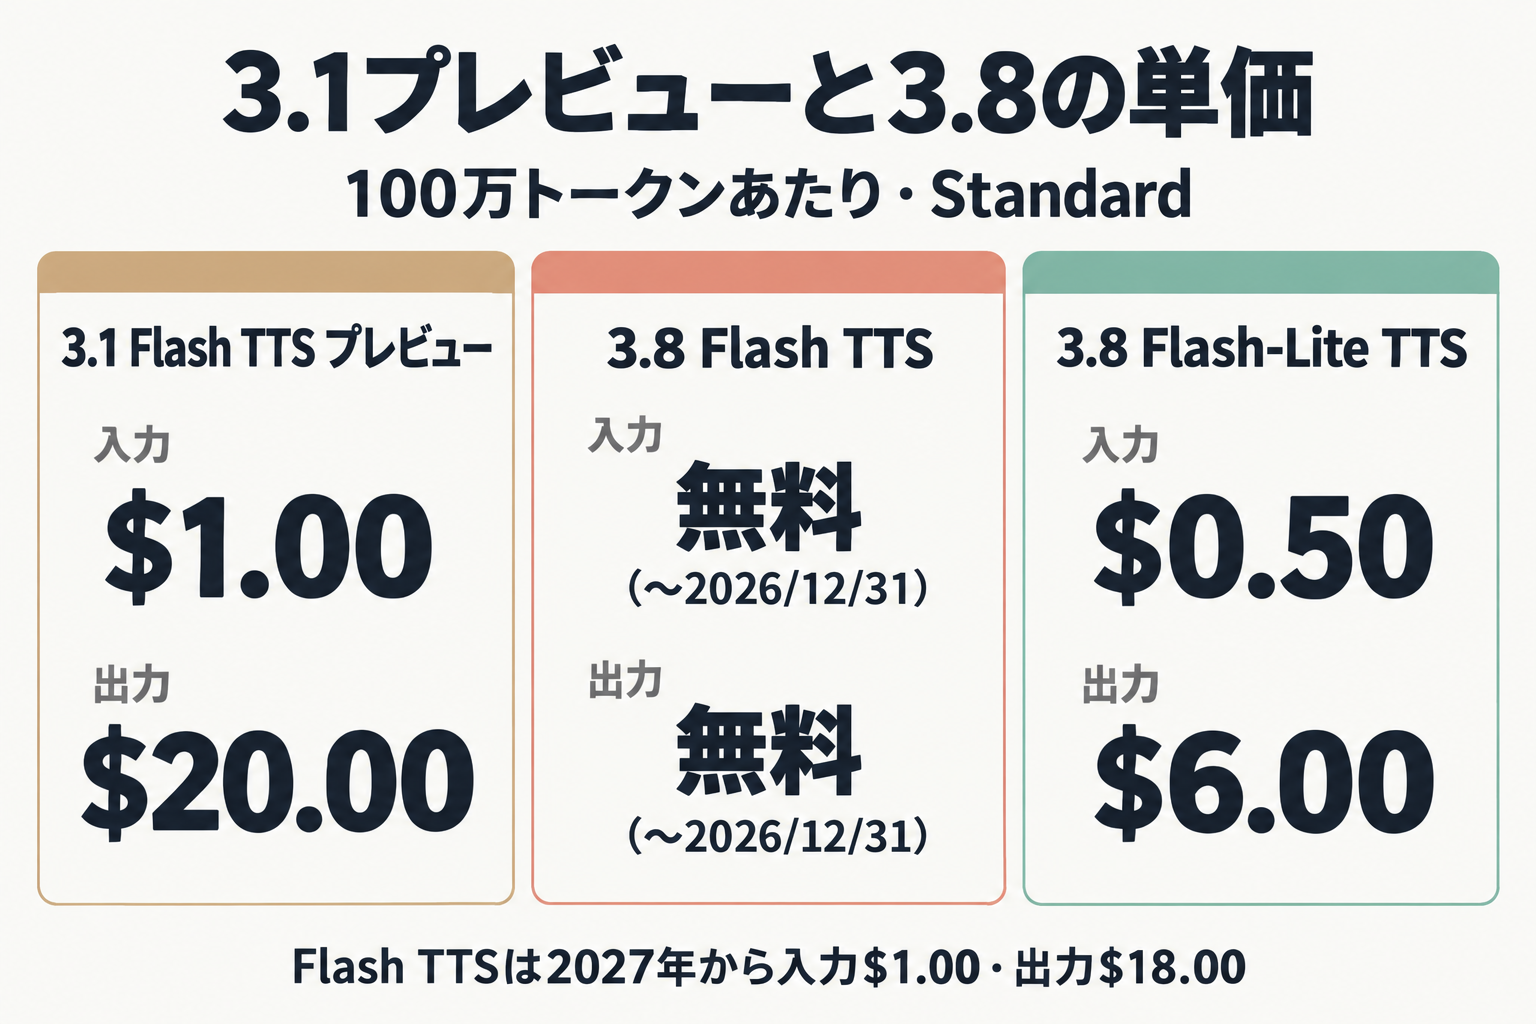
| 項目 | 3.1 Flash TTS プレビュー | 3.8 Flash TTS | 3.8 Flash-Lite TTS |
|---|---|---|---|
| 入力 | $1.00 | 無料(〜2026/12/31)→ 2027年から$1.00 | $0.50(2027年から$1.00) |
| 出力 | $20.00 | 無料(〜2026/12/31)→ 2027年から$18.00 | $6.00(2027年から$12.00) |
3.8で使える演技の指定(style とVocal Eventタグ)と、最大2人の複数話者は、次の章以降で説明します。
3.8の音声モデルは、モデルカードによると共通して「Gemini 3 Pro」をベースに作られています。声の種類はプリセットだけで2,000以上あります。
感情・話し方を演出する:styleとタグの使い分け
3.8の演技指定は、役割の違う2つの道具に分かれています。
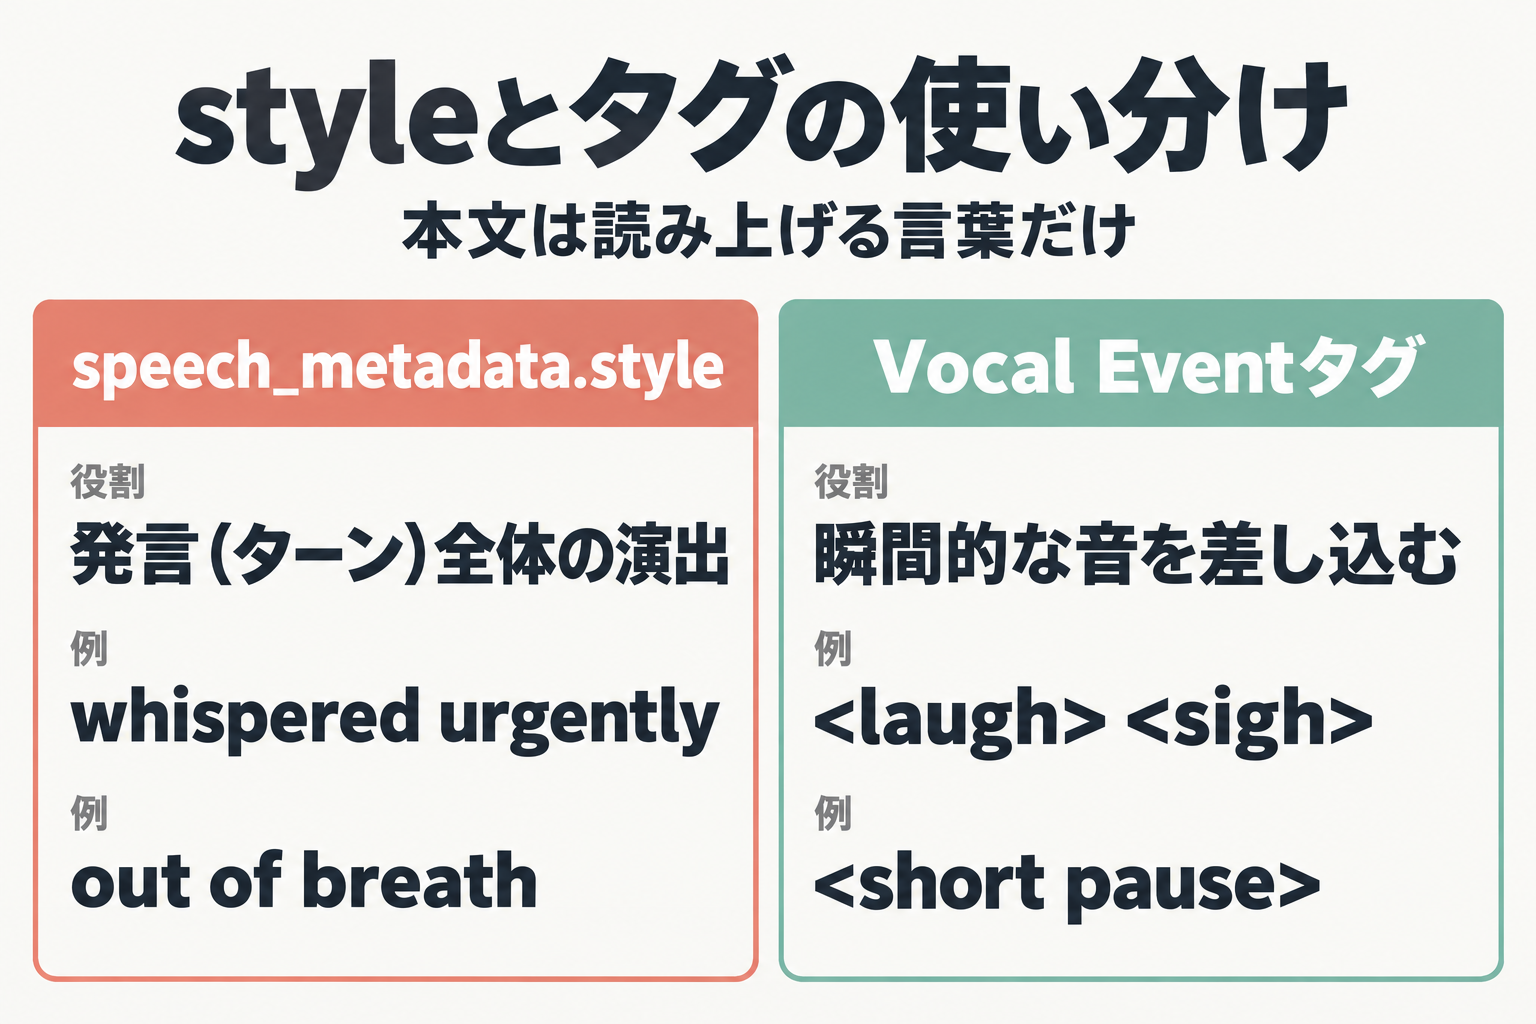
| 道具 | 役割 | 公式の例 |
|---|---|---|
speech_metadata.style | その発言(ターン)全体にかかる演出。感情・抑揚・話す速さ・音量 | "cheerful and friendly"(明るく親しげに)、"whispered urgently"(切迫してささやく)、"out of breath"(息を切らして)、"sarcastic"(皮肉っぽく) |
| Vocal Eventタグ | 瞬間的な音を台本の好きな位置に差し込む | <laugh> <sigh> <breath> <gasp> <cry> <short pause> <long pause> など |
台本は、公式の例を写すとこうなります。
"Wait... <short pause> did you hear that? <sigh>"タグは笑い・咳・うめきなど30種類以上用意されています。台本の一部分だけ間を取りたいなら <short pause>、1発言まるごとの雰囲気なら style、と使い分けます。
3.1から移行する人へ:指示を本文に書かない
3.8の公式ドキュメントは、text フィールドを**一字一句そのまま読む台本(逐語台本)**として扱うと説明しています。本文に書いた言葉はすべて読み上げる台本とみなされるため、「やさしく読んで:」のような話し方の指示を本文に混ぜると、その指示文も台本の一部になります。演出は必ず style かタグに分けて書きます。
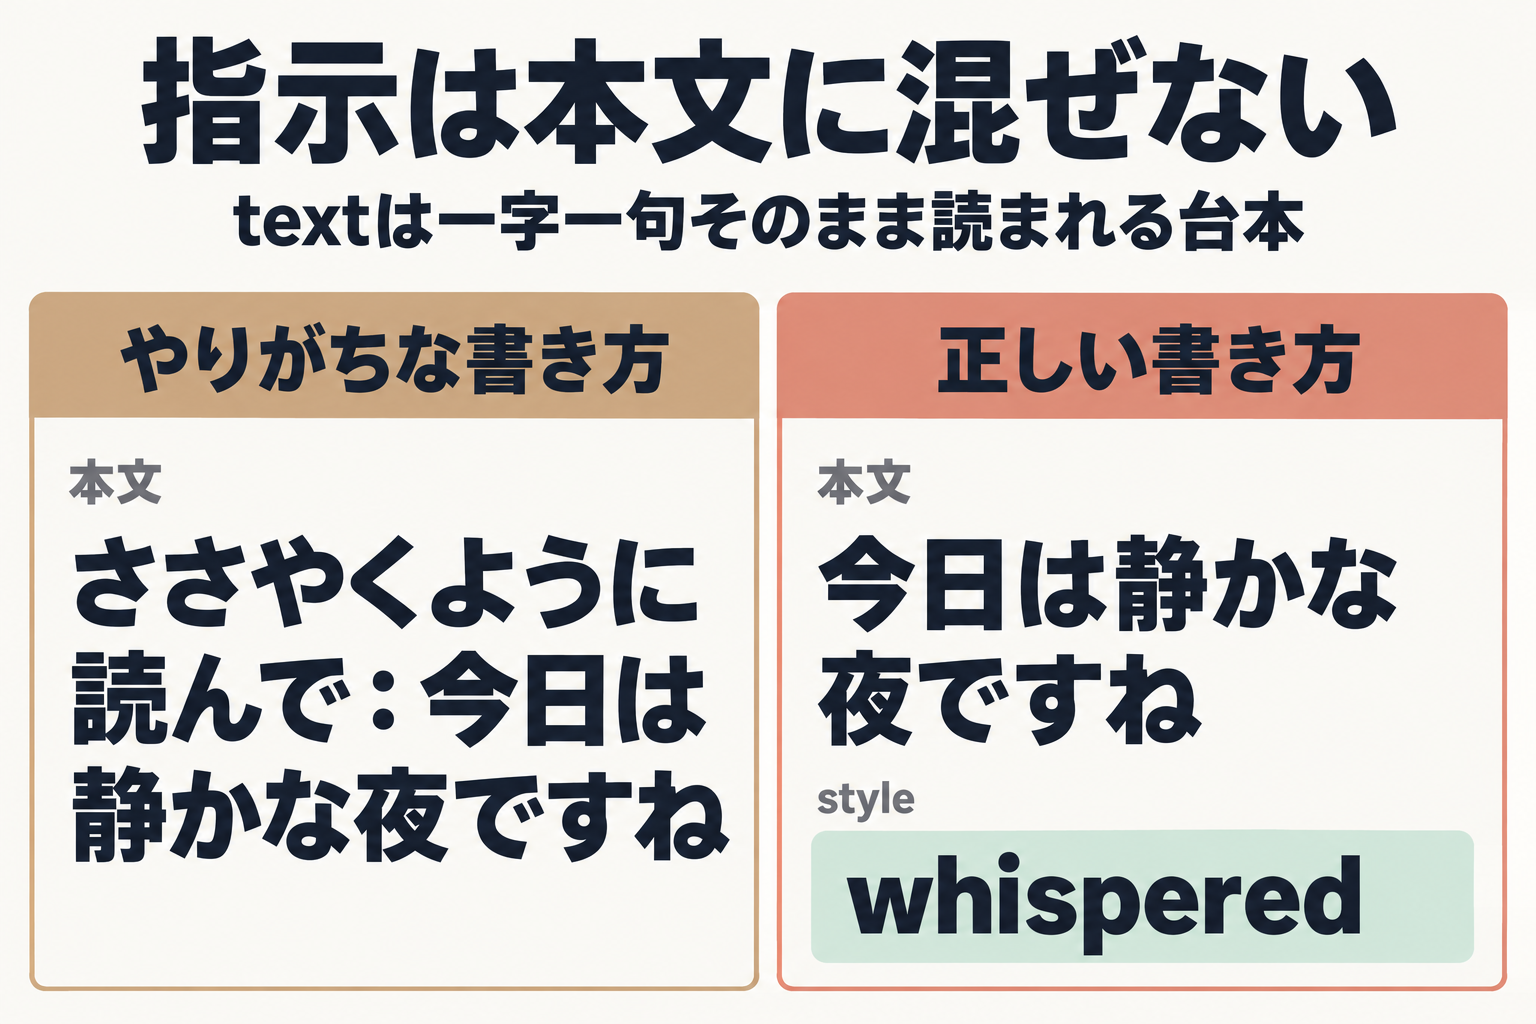
| やりがちな書き方 | 正しい書き方(一例) |
|---|---|
| 本文: 「ささやくように読んで:今日は静かな夜ですね」 | 本文: 「今日は静かな夜ですね」+ style: "whispered" |
3.1との挙動の違いを公式が明記しているわけではありません。ただし3.8を使う限りは「本文=読み上げる言葉だけ」と覚えておけば迷いません。
2人の会話を1本の台本から作る
複数話者は、1リクエストで最大2人まで、プリセット音声で使えます。設定は speech_config.mode: "conversational" にして、speakers に話者名と声の組み合わせを並べます(公式例は Joe=Puck、Jane=Kore)。各ターンの speech_metadata に speaker を書いて誰のセリフかを示します。
業務の場面では、研修の「先生と生徒」風の掛け合い、商品紹介の対談風ナレーションなどの下書きに使える機能です。3人以上の会話は1リクエストでは作れないため、2人ずつ分けて作ります。
今日試せる最初の一歩
公式ドキュメントが「まずここで試すと良い」と案内しているのは、Google AI Studioの音声生成ページ(aistudio.google.com/generate-speech)です。Googleアカウントでのサインインが前提です。
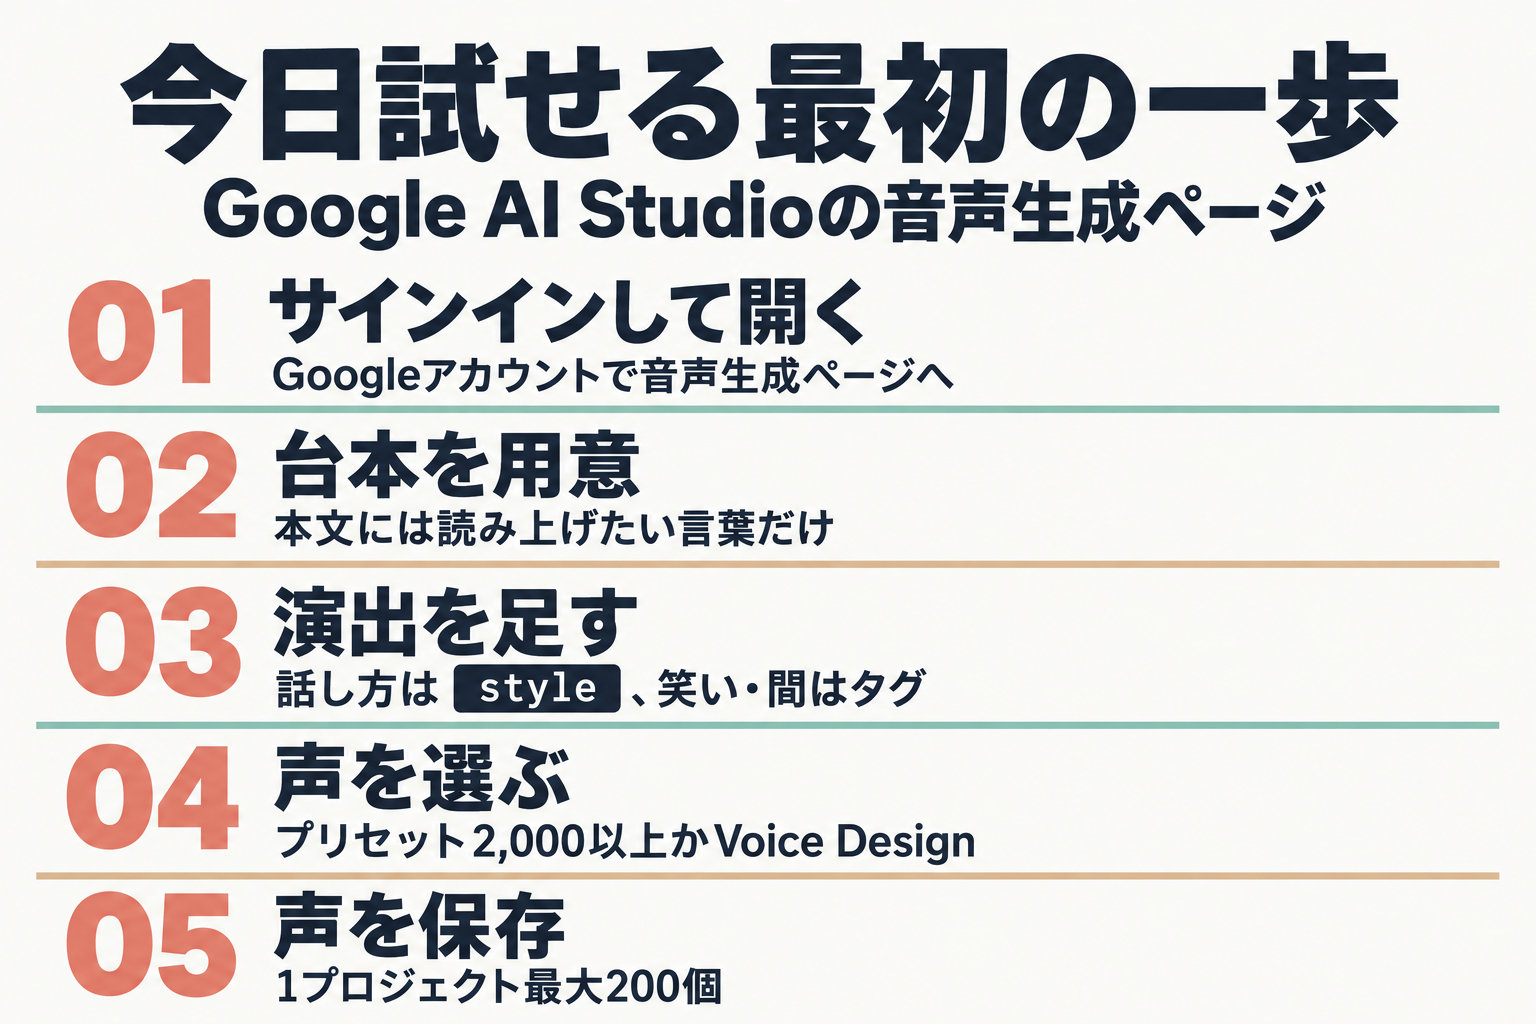
- Googleアカウントでサインインして、音声生成ページを開く
- 読ませたい台本を用意する。本文には読み上げたい言葉だけを書く
- 話し方は
style、笑い・ため息・間はタグで足す - 声はプリセット(2,000以上)から選ぶか、Voice Designで文章から設計する
- 気に入った声は保存する(1プロジェクトあたり最大200個。保存期間は
store=Trueのステートフル運用で1年、store=Falseのステートレスキー運用で7日)
無料枠の1日あたりの上限回数は、公式のレート制限ページにモデル別の数値がなく、AI Studio内の自分のアカウント画面で確認する案内になっています。業務の原稿は入れず、公開済みの文章や短い練習用の台本で試すのが安全です。公式ドキュメントには人名・地名・数字の読み間違いへの対処法の記載がないため、これらは生成後に必ず聞いて確かめます。API経由で使うなら、モデルIDを上の表のとおり指定します。
声を作る・複製するときに知っておくこと
Voice Designは、自然な文章で「どんな声か」を書いて声を設計する機能です。Voice Replicationは既存の声を複製する機能で、ルールが厳格です。
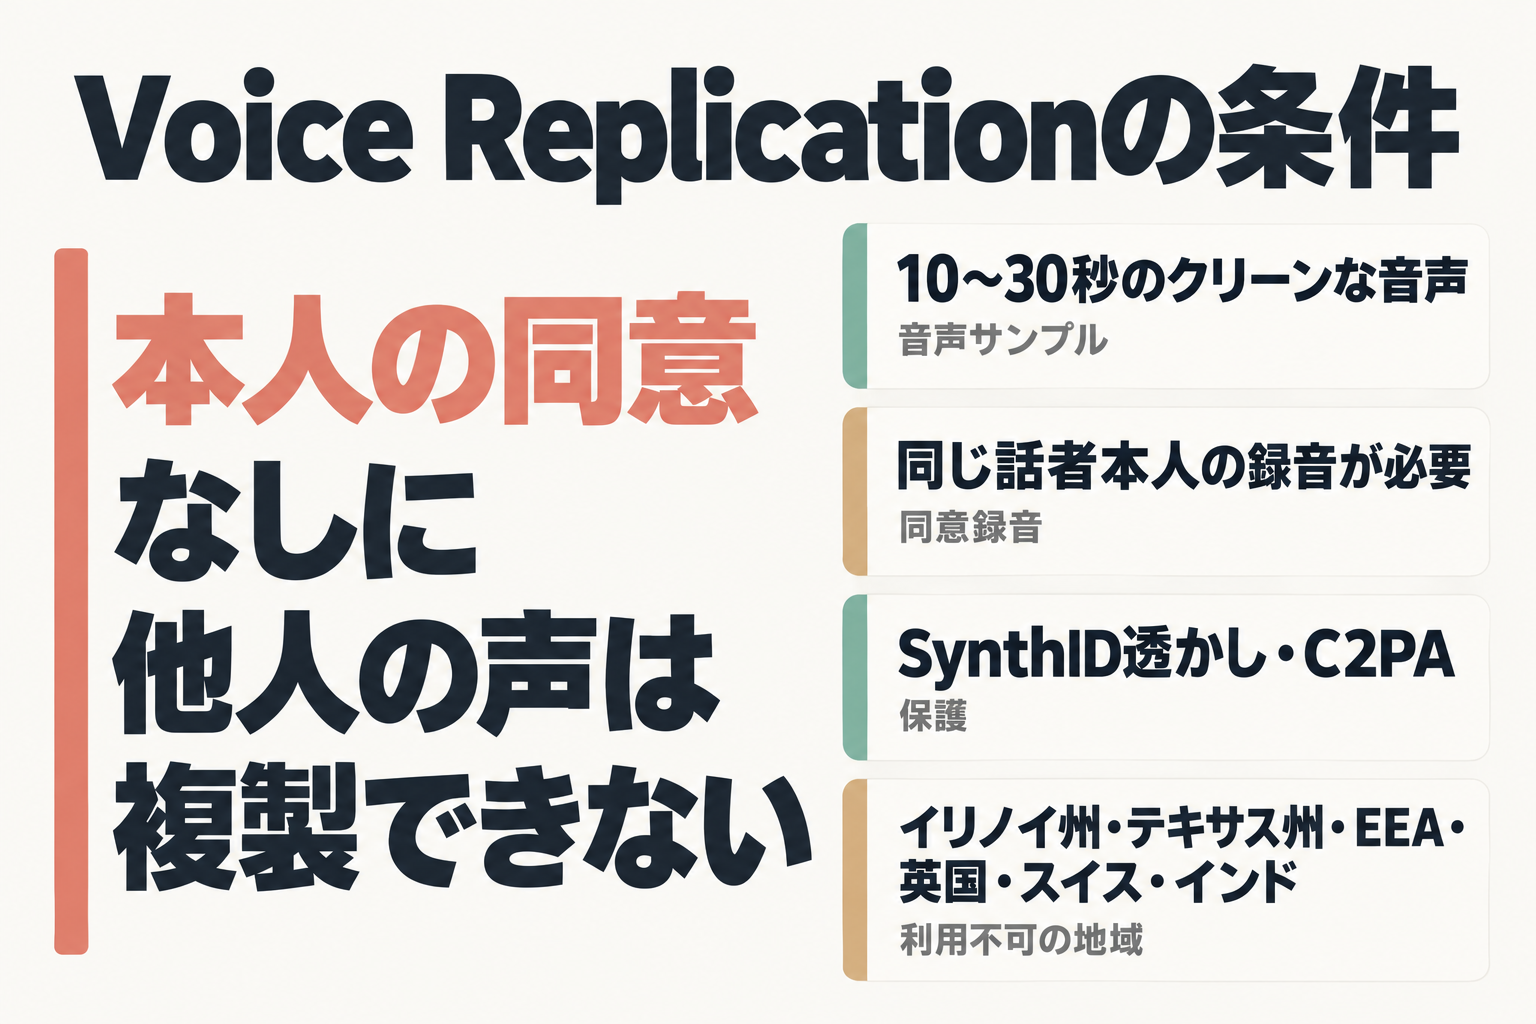
- 10〜30秒のクリーンな音声サンプルに加え、同じ話者本人の同意録音が必要
- 同意文は公式指定の英語文言(「この声の持ち主であり、Googleが合成音声モデルを作ることに同意する」という内容)
- つまり本人の同意なしに他人の声を複製することは、仕組みのうえでできない
- 公式ブログによると、Voice Design・Voice Replicationは同意確認・SynthID電子透かし・C2PA認証情報で保護される
- AI Studio経由のVoice Replicationは、イリノイ州・テキサス州・EEA・英国・スイス・インドでは利用できない
今後、声のピッチ・話速・アクセントを微調整できる「Voice Remix」が近日提供される予定です。時期の具体的な日付は案内されていません。
料金:1時間あたりに直すといくら?
公式の料金ページは100万トークン単位で書かれていて直感的ではないため、1時間あたりに換算します。公式は「音声1秒=25トークン」と注記しているので、1時間=3,600秒×25=9万トークンです。これに出力単価を掛けた目安が下の表です(出力分のみの試算。台本テキストの入力分は含みません)。
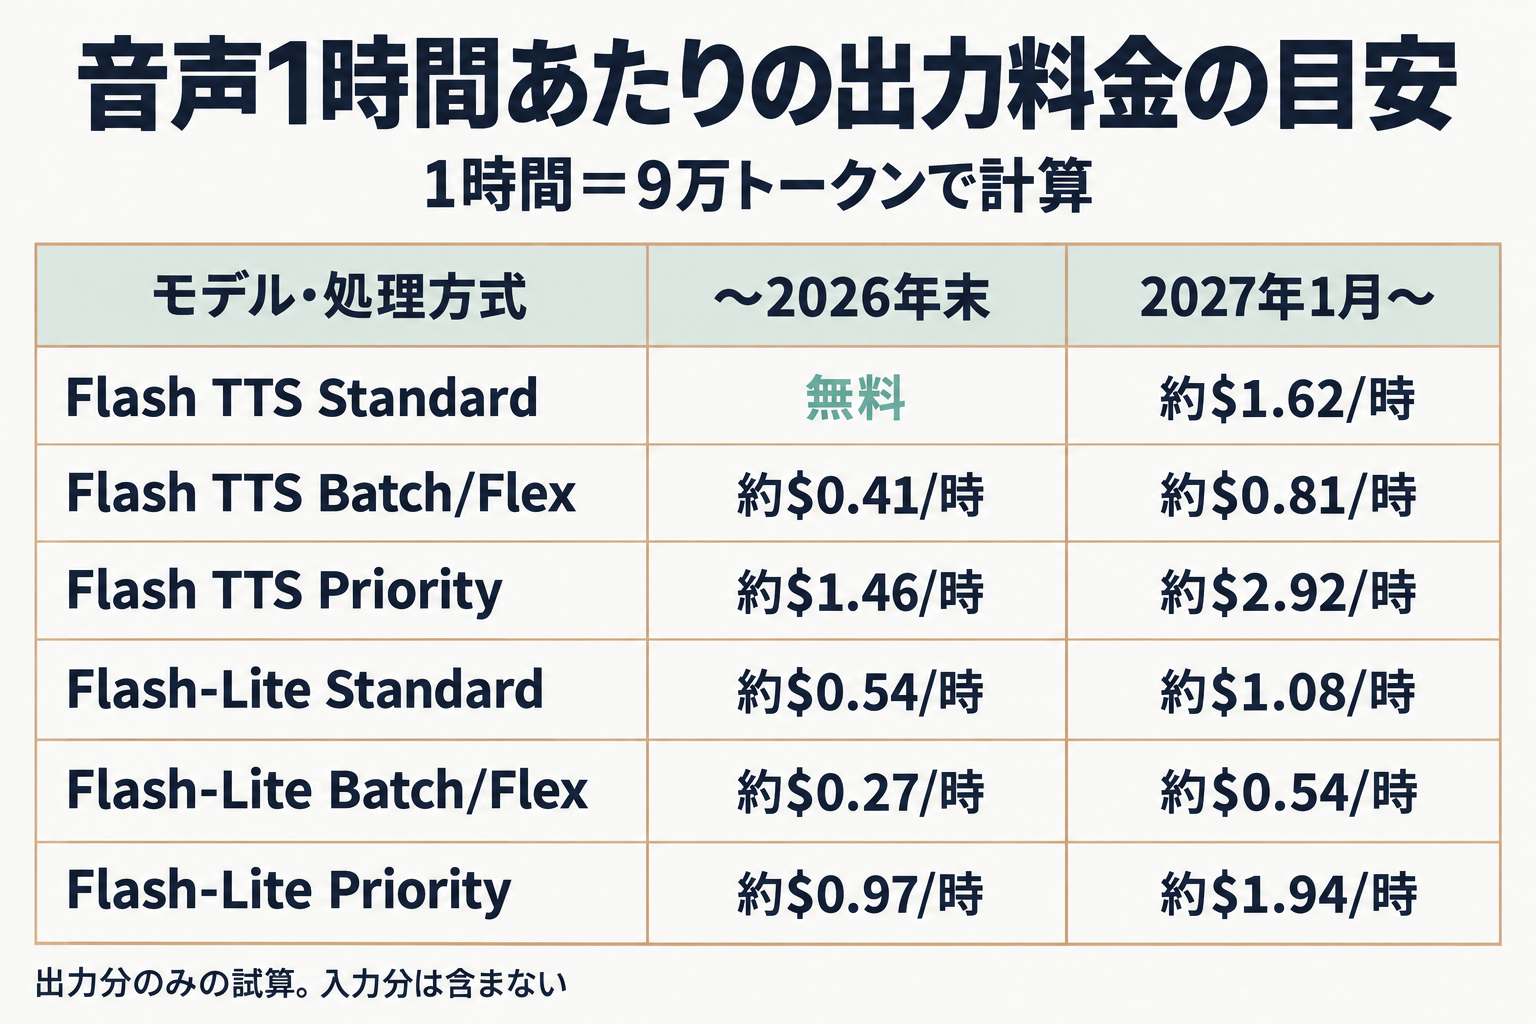
| モデル | 処理方式 | 〜2026年末 | 2027年1月〜 |
|---|---|---|---|
| Flash TTS | Standard(標準) | 無料 | 約$1.62/時 |
| Flash TTS | Batch / Flex | 約$0.41/時 | 約$0.81/時 |
| Flash TTS | Priority | 約$1.46/時 | 約$2.92/時 |
| Flash-Lite TTS | Standard | 約$0.54/時 | 約$1.08/時 |
| Flash-Lite TTS | Batch / Flex | 約$0.27/時 | 約$0.54/時 |
| Flash-Lite TTS | Priority | 約$0.97/時 | 約$1.94/時 |
Batch(まとめて後で処理)とFlex(優先度を下げる)は単価が半額、Priority(優先処理)は約1.8倍です。2027年1月1日から、有料の単価はどの方式も約2倍になります(Flash TTSの標準処理は無料から有料に変わります)。
品質の評価と技術仕様
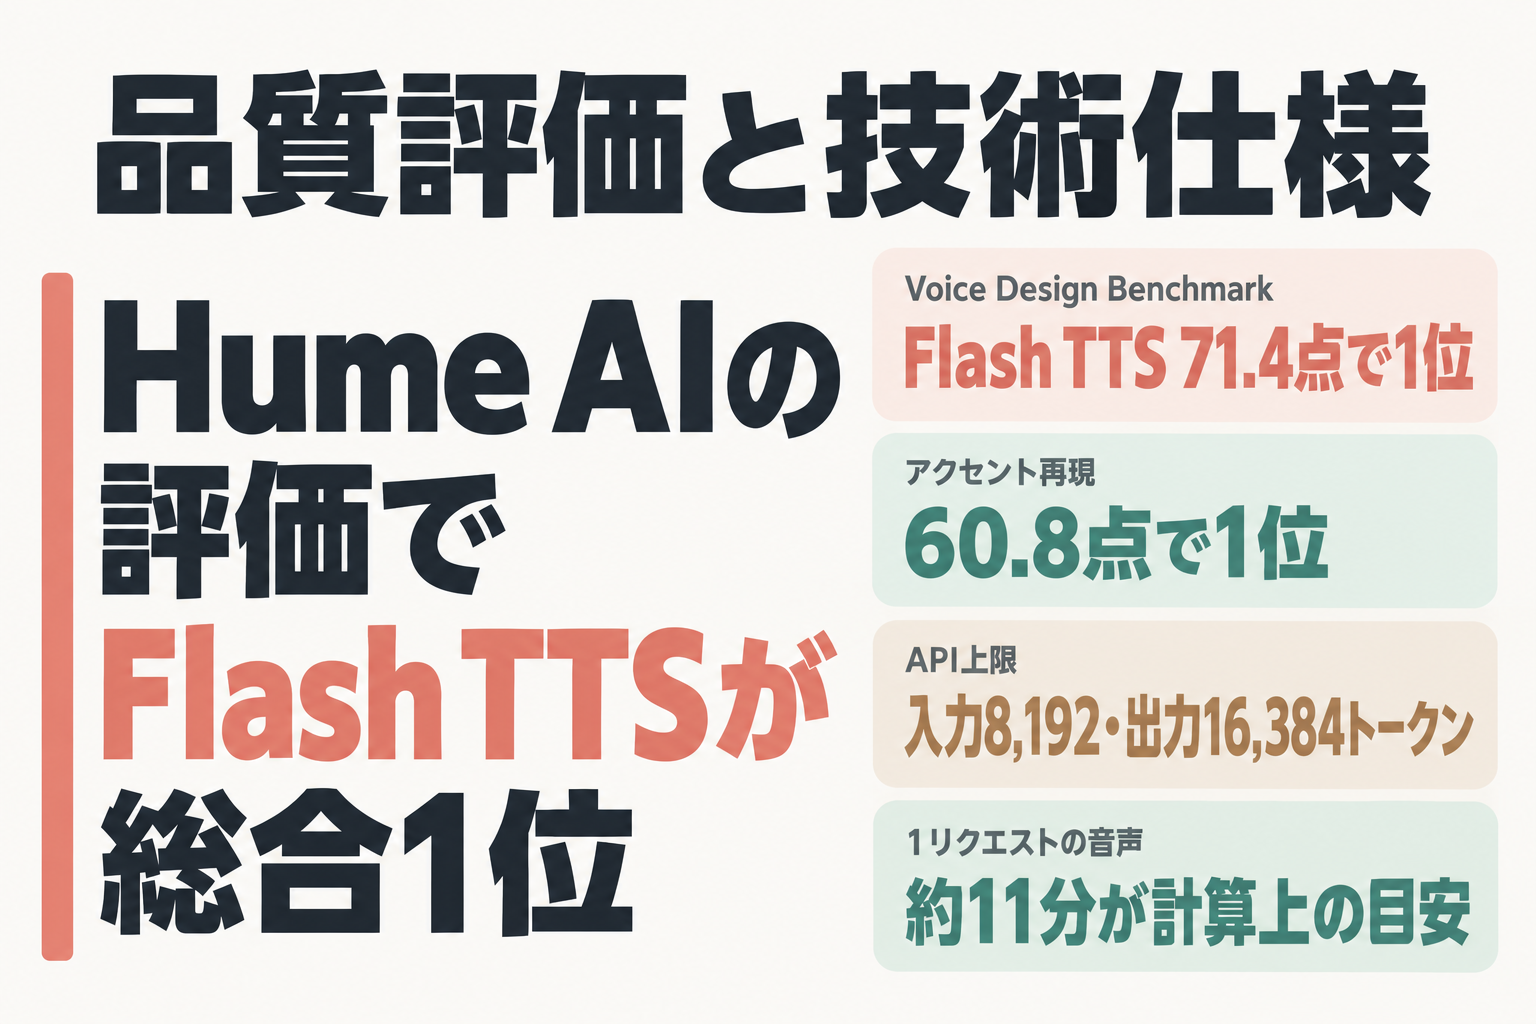
- 第三者評価: Google公式ブログによると、Hume AIのVoice Design Benchmarkで Flash TTS が71.4点で総合1位、アクセント再現では60.8点で1位です。Hume Overall Quality Indexでは Flash TTS が1位、Flash-Lite TTS が2位、人が目隠しで聞き比べるVoice Arenaでも複数の言語で上位とされています。Hume AI自身のブログも、Voice Designで1位という方向性を伝えています(評価者は3人の人間で、トーン・表現・自然さ・話者の一貫性・信頼性を評価)。
- 入出力の上限: Gemini APIの上限は入力8,192トークン、出力16,384トークンです。出力を音声だけと仮定して25トークン/秒で割ると、1リクエストで作れる音声は約11分が計算上の目安です。DeepMindのモデルカードには「64K出力」の記載もあり、モデル自体の能力とAPI提供時の上限は別と考えると整理しやすくなります。
- 出力形式: 非ストリーミングの標準は、ヘッダー付きのWAV(24kHz・モノラル・16bit)です。Raw PCM・Mu-law・A-lawにも対応し、
stream: trueでストリーミング生成もできます。
もっと詳しく
音声まわりのAIをまとめて知りたい人は、weeveeの実測比較「AI文字起こし実測比較|Notta/Rimo/tl;dv」が参考になります。同じ3.8の音声モデルを別の角度から整理した「Gemini 3.8 Flash TTSの使い方と料金の違い」もあります。Google AI Studio自体のアカウント準備や料金は「Google AI Studioの使い方|料金と発行手順」にまとめています。条件は変わるため、本番で使う前に公式の料金ページとドキュメントで最新の内容を確認してください。
Flash TTSの標準処理は2026年内なら出力まで無料で、複数話者や演技指定を含めて下書きの質を確かめられます。今日やるなら、公開済みの短い文章を2〜3行用意し、style を変えて読み上げさせて違いを聞き比べるところまでが最初の一歩です。
Flash TTSは130言語に対応(公式発表)。
Gemini 3.8 TTS(Google AI Studio) を無料で始める(公式)